HumanCLAW:视觉语言模型能否通过身体去行动?

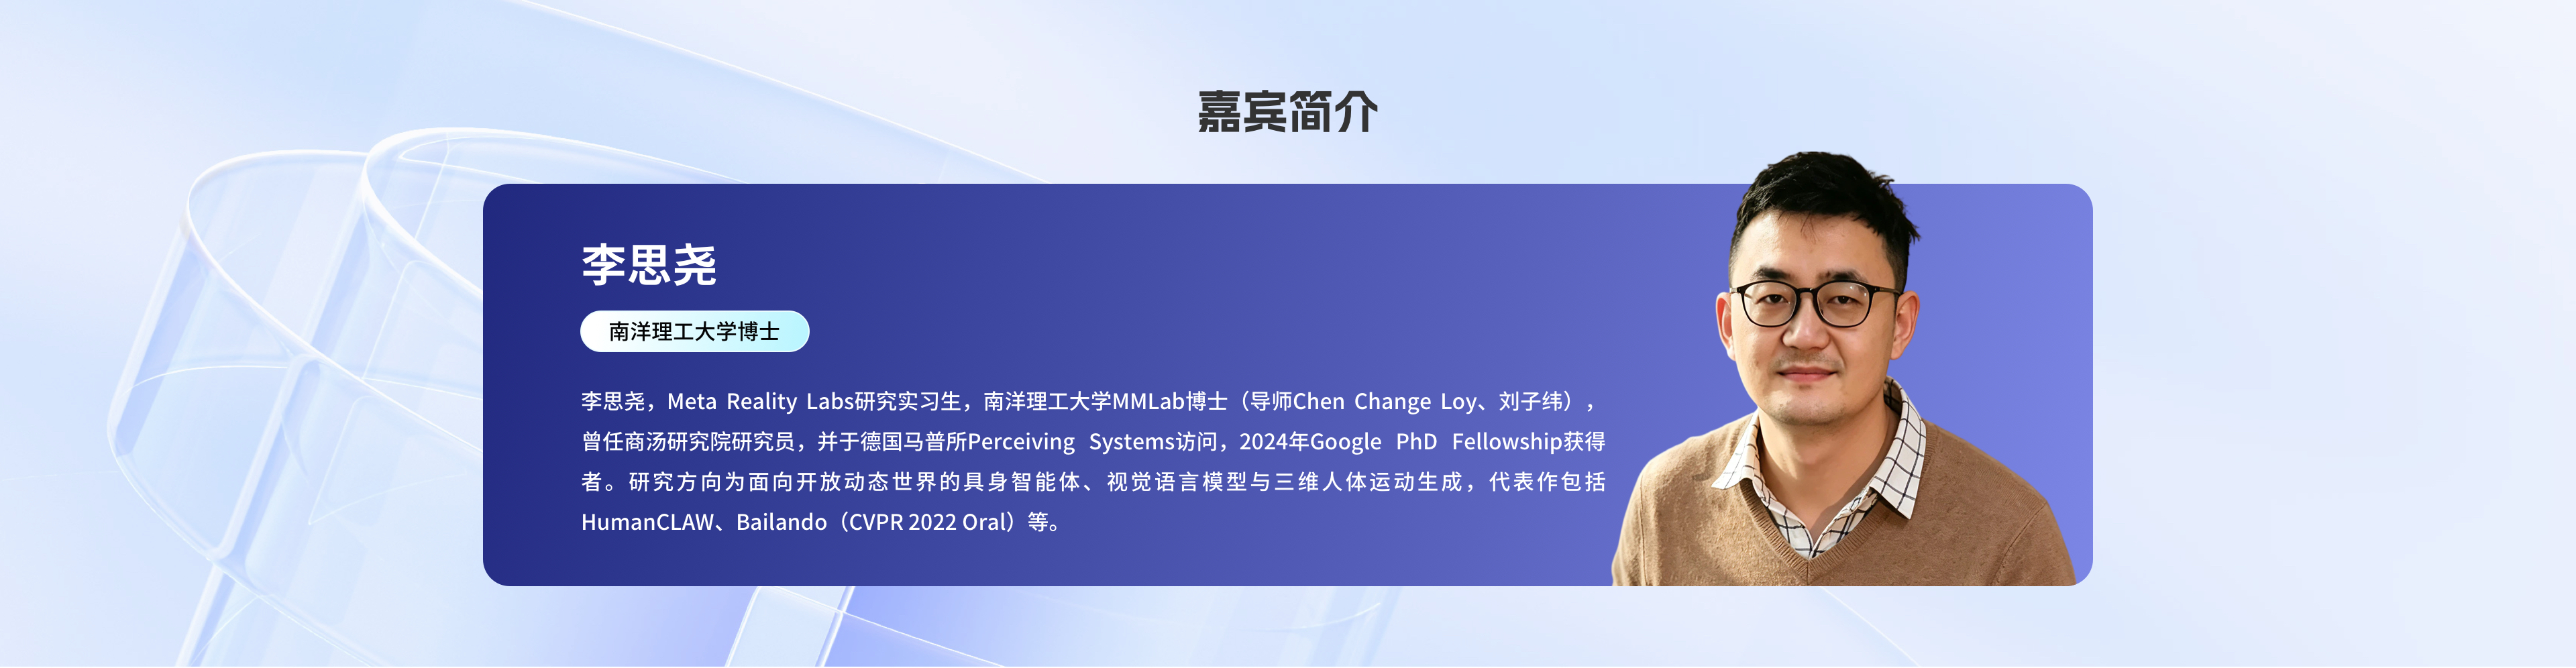
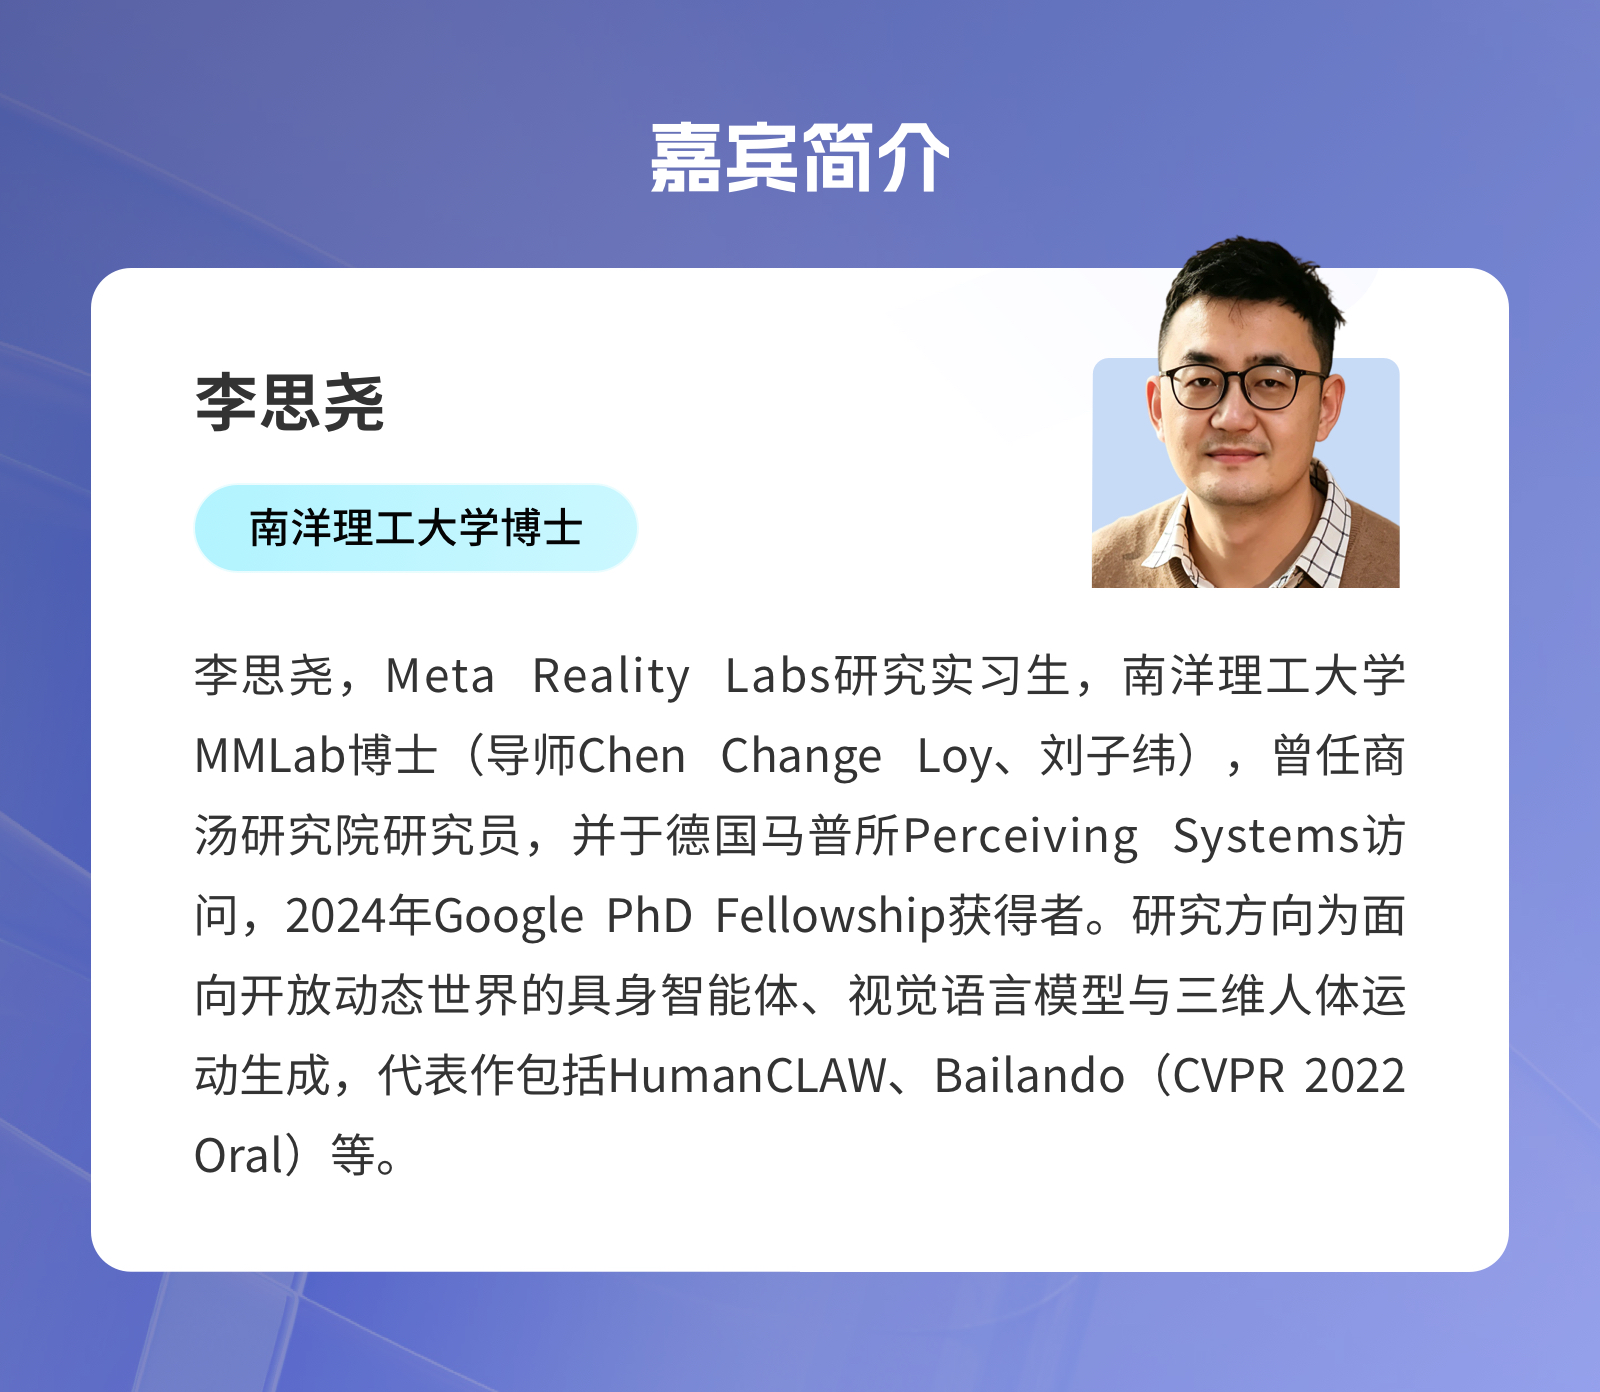
主讲人:李思尧 | 南洋理工大学博士

  • 开课时间

    2026.09.22 19:55

  • 课程时长

    90分钟

  • 预约人数

    0人预约

立即报名
添加助教,领取课件

直播将于09月22日19:55开始

立即报名

已有0人报名了此课程

HumanCLAW:视觉语言模型能否通过身体去行动?

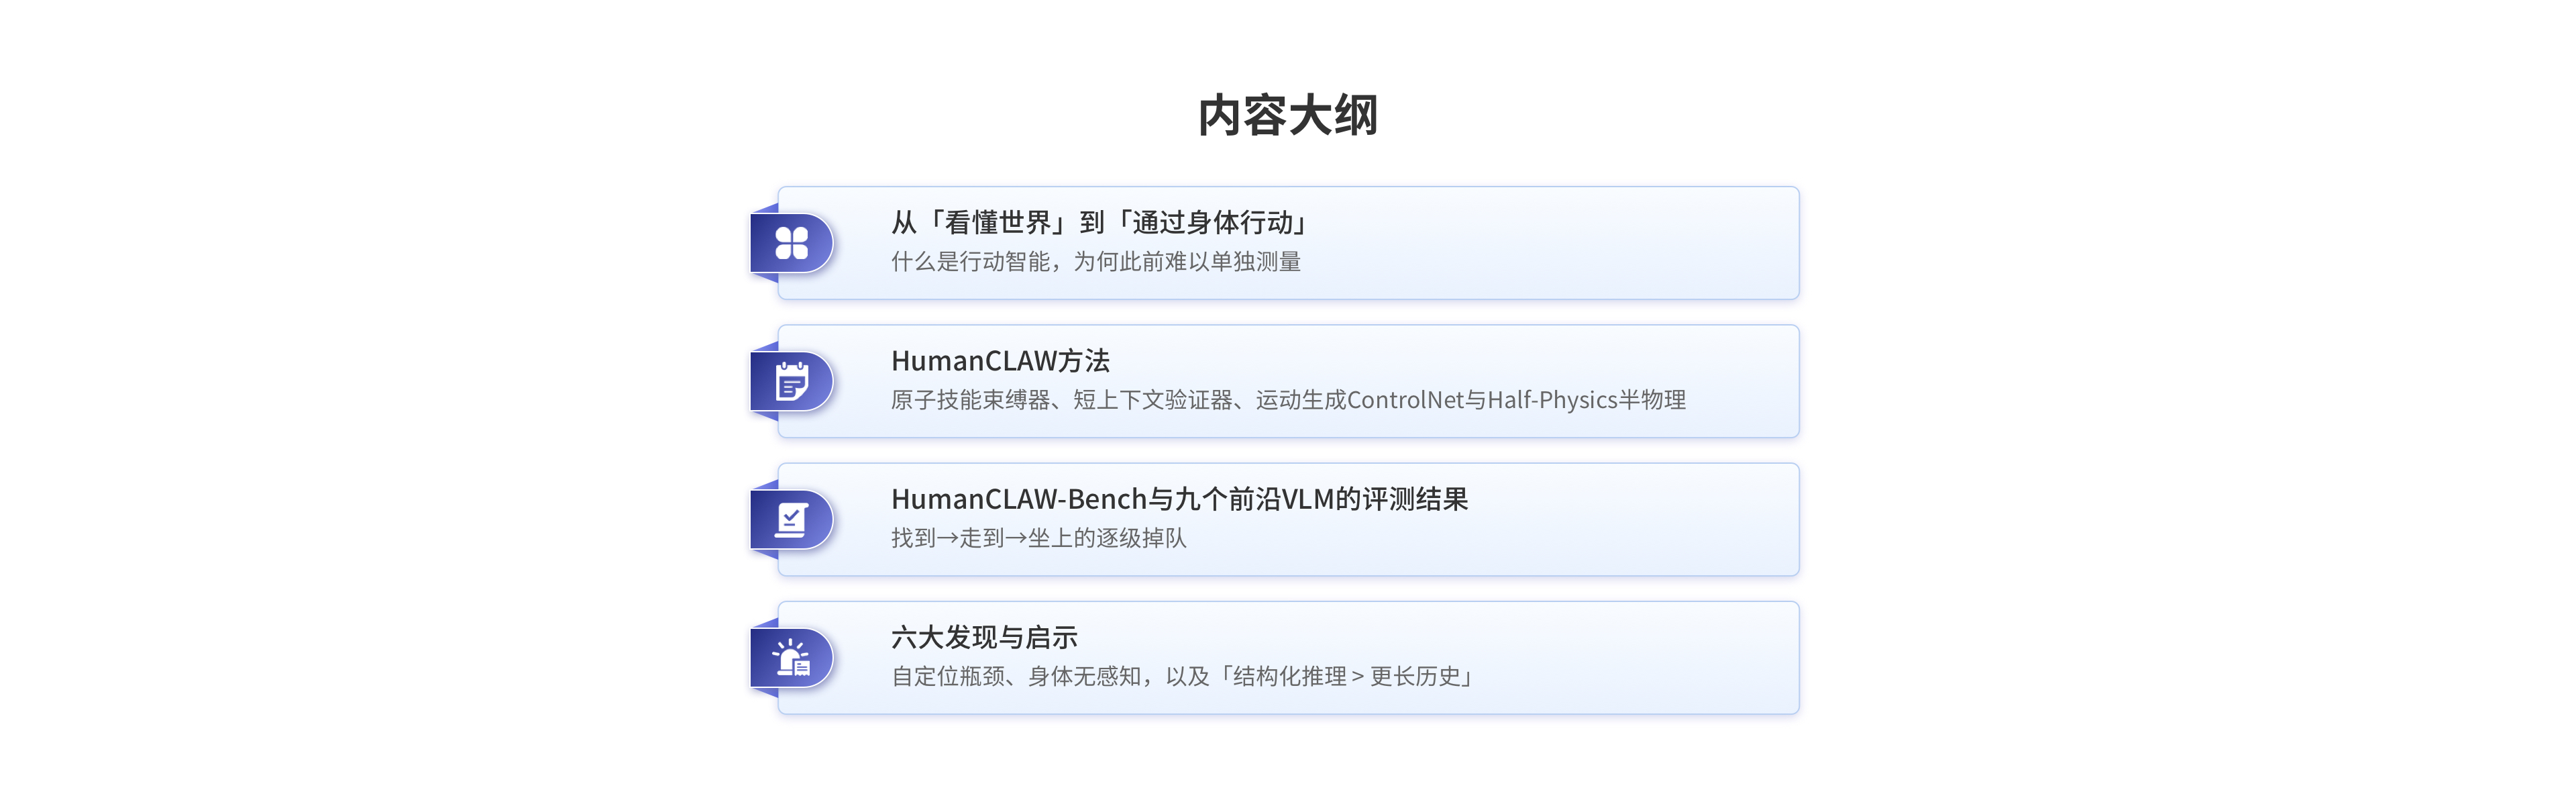
当低层控制器已能可靠地维持平衡与执行动作,前沿的视觉语言模型(VLM)是否真的知道身体下一步该做什么? 

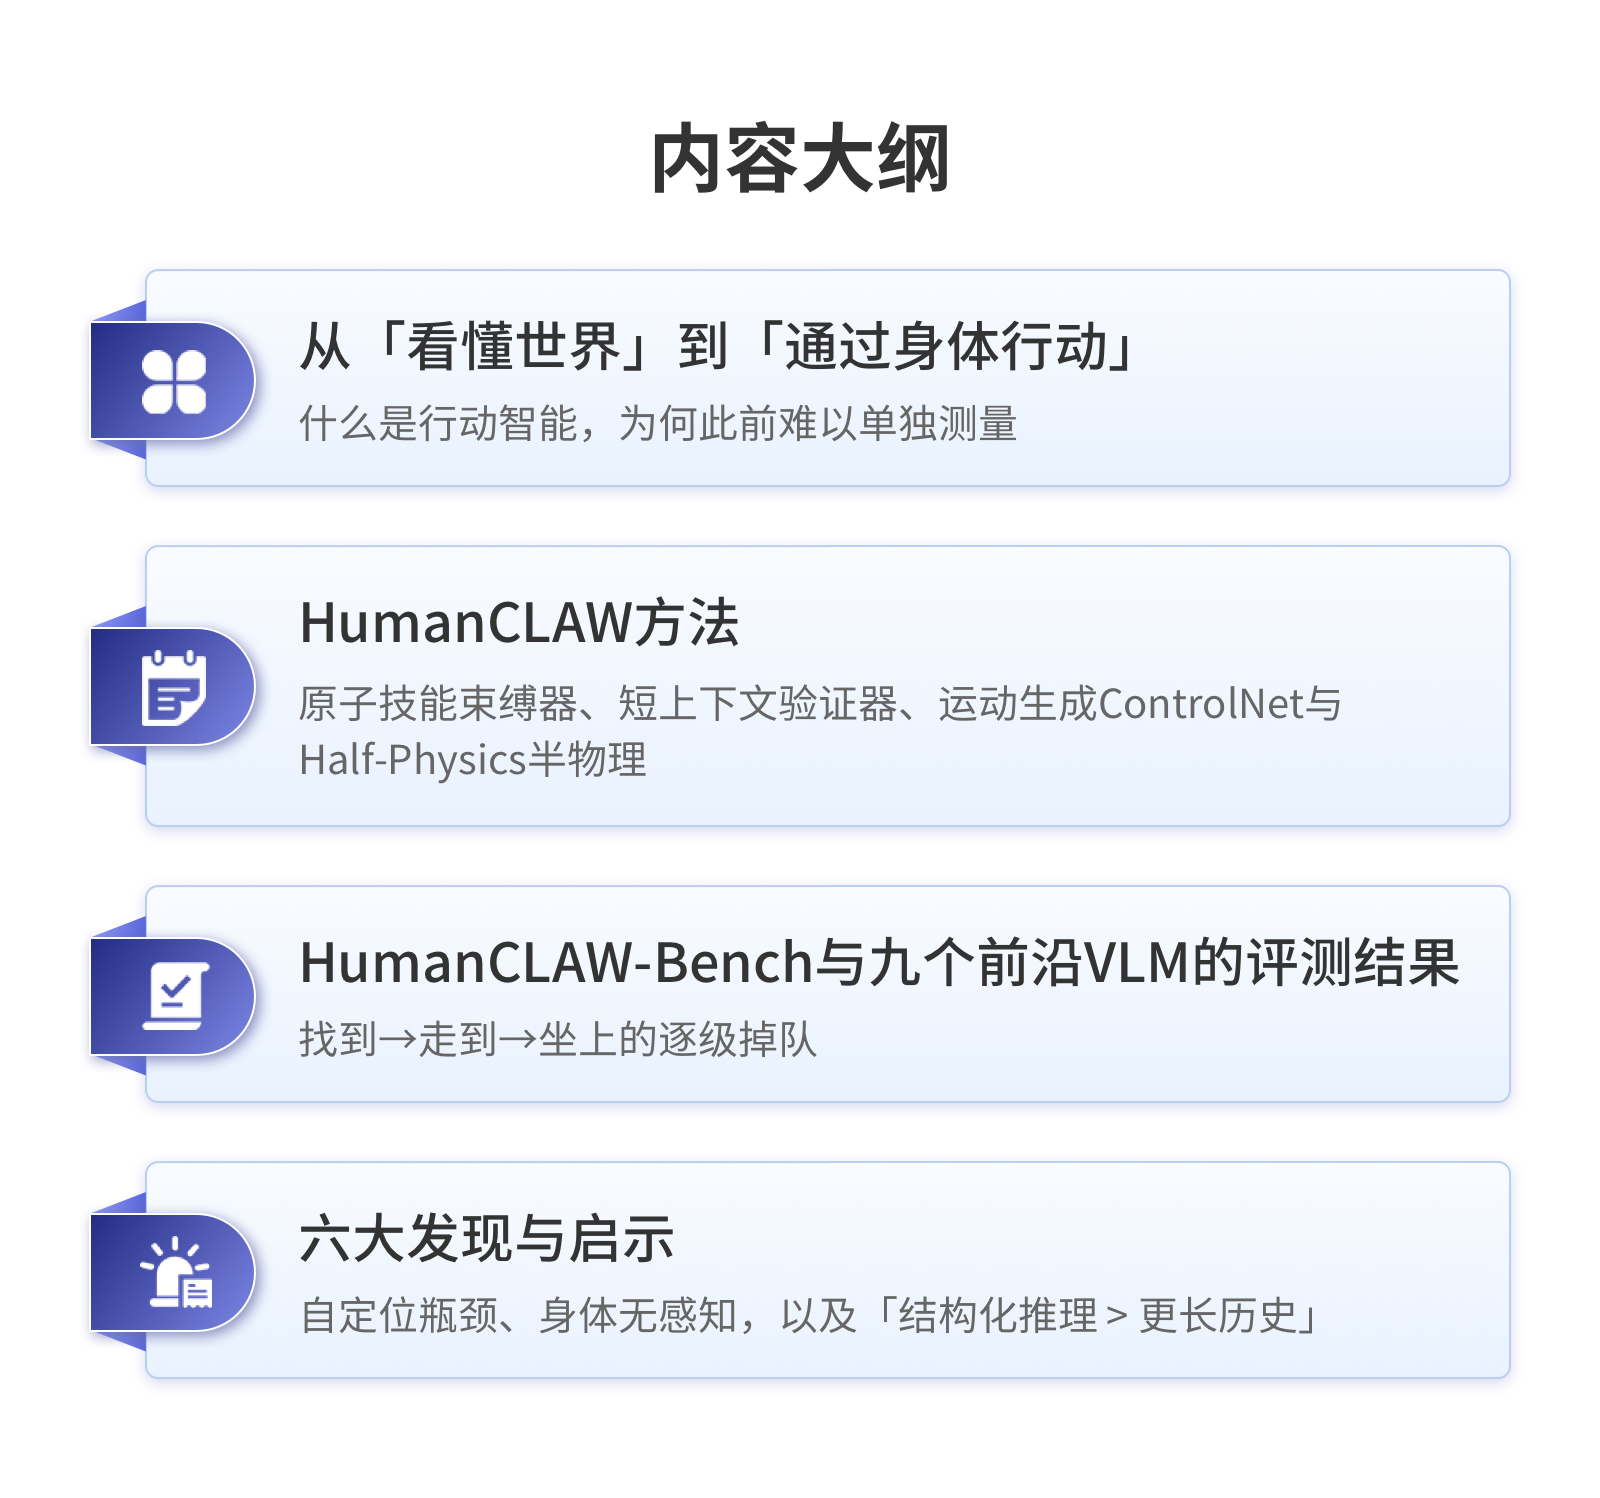
本次公开课将介绍HumanCLAW——一个把「高层行动决策」从「低层运动控制」中干净剥离、同时保留碰撞/接触/重力真实后果的评测框架。它让冻结的现成VLM每0.5秒只发出一个原子全身技能,由运动生成器 + 半物理(Half-Physics)执行:身体不会摔倒,但世界照常运行。在41个室内场景、1218个「寻找—导航—交互」任务上,九个前沿VLM无一攻克,最强模型完整交互成功率仅16.8%。我们将拆解方法设计,并分享VLM在闭环具身决策中暴露的系统性短板与改进方向。

直播精华文稿暂未上传
直播课件暂未上传
具身智能与机器人 具身智能 人形机器人 进阶
具身智能与机器人 人形机器人 进阶
具身智能与机器人 具身智能 进阶
大模型与Agent 大模型与Agent 进阶