

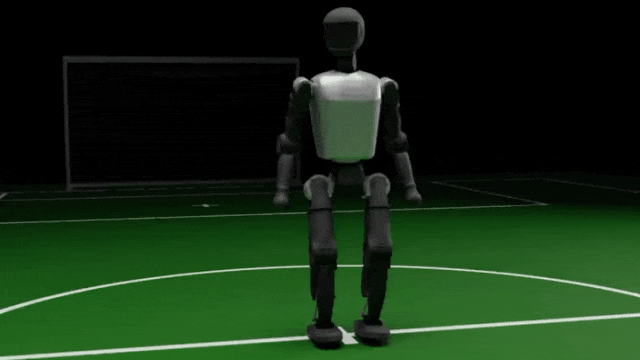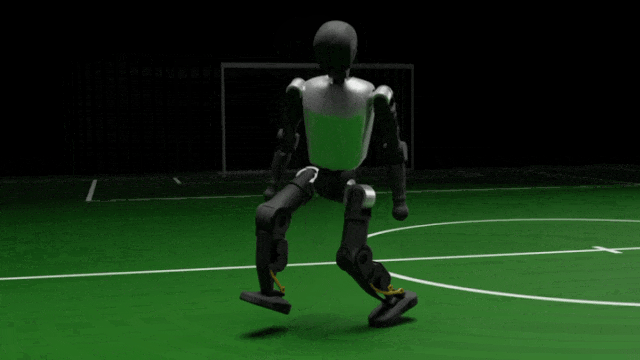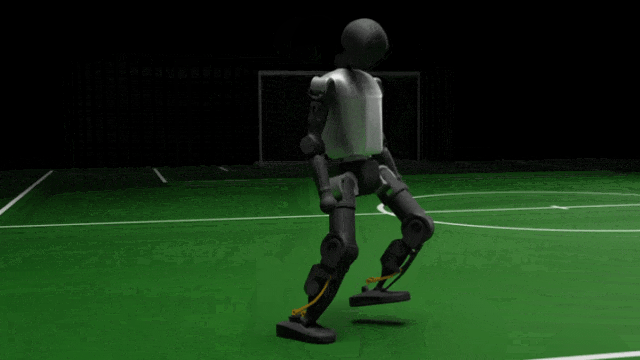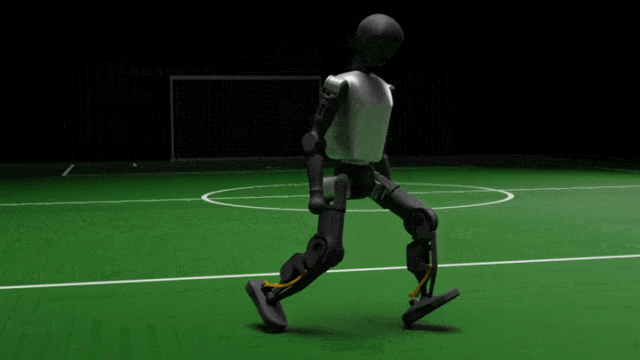
感知不再是前置预处理,而是策略本身的一部分
——端到端的“感知-运动”统一强化学习框架
人形机器人踢足球,最大的难关并不只是双足平衡、抬腿射门这些运动能力,而是运动过程中视觉感知本身就不可靠。
机器人跑动时镜头抖动、光照变化、球体短暂离开视野,都会造成检测丢失。过去主流方案采用感知‑规划‑控制模块化流水线,感知出错就会一路传导到动作输出,造成动作卡顿、反应迟缓。
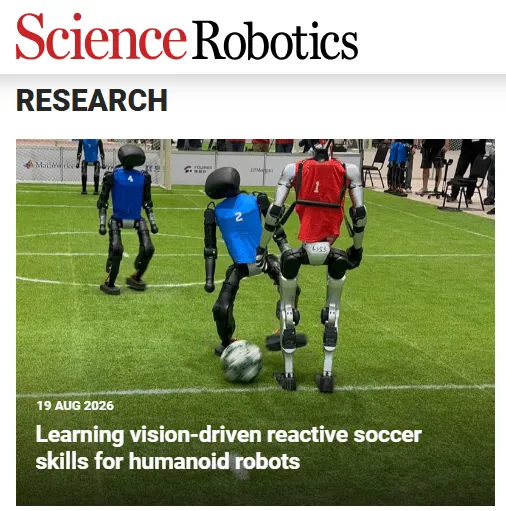
清华大学赵明国团队联合字节跳动Seed发表于Science Robotics的这项工作,打造了一套统一强化学习控制器,把视觉不确定性直接融入策略训练,机器人只使用机载相机,仿真训练结束后零样本直接部署真机,可以自主完成搜球、追球、多方向射门整套行为。
并且这套算法模块直接用于RoboCup 2025成人尺寸人形组,助力火神队拿下两项赛事冠军。
整套工作的核心思路,不是把视觉模块打磨到“百分百看得准”,而是让机器人策略学会适应看不清、看不准的现实。传统方案假设感知输出是可靠真值;而本工作把噪声、延迟、检测丢失全部放进仿真训练,让策略从训练阶段就习惯不完美的观测,依靠时序历史信息自己推测球的真实状态,做到感知和运动闭环协同。
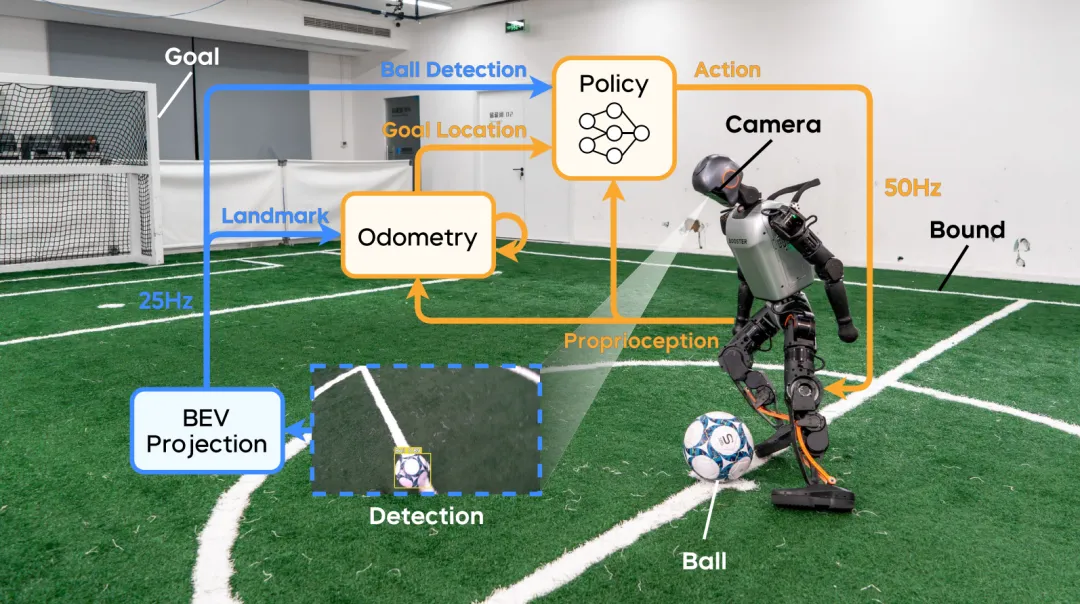
▲图| 系统总览图。真实机器人搭载机载相机完成视觉感知,图像检测转换为鸟瞰视角BEV坐标,里程计模块输出球门信息,策略网络结合本体感知输出50Hz关节指令,感知流水线以25Hz运行©【深蓝具身智能】编译
人形足球领域两大技术路线的固有短板
人形机器人足球,是具身智能非常典型的测试场景,需要敏捷双足移动、动态视觉跟踪、时机精准的踢球动作同时生效。
目前业内两条主流路线:
-
模块化规则基线(RoboCup大量队伍使用) 把任务拆成感知、规划、步态控制独立模块。
视觉输出球位置,规划器规划趋近路径,步态控制器执行行走,最后执行预设踢球脚本。 优点是逻辑清晰,调试直观;
但缺点在于:模块串行带来延迟,感知噪声会层层向下传递。机器人如果球在身后,需要原地大幅度旋转调整站位,从启动到完成踢球最多消耗5秒。
各模块独立调参工作量巨大,动态滚动的足球面前响应能力很差。
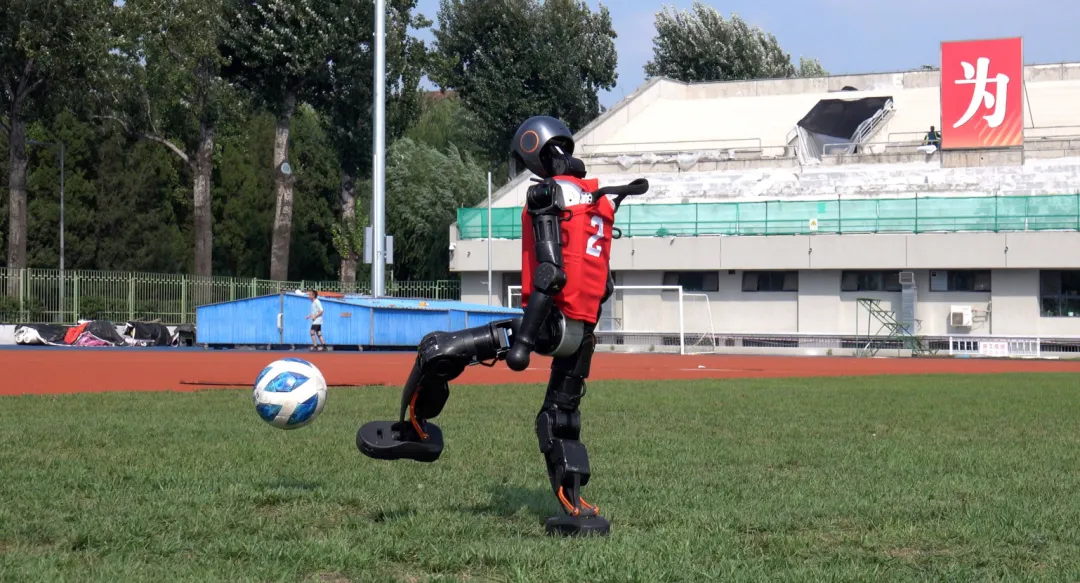
图| 结果与方法概述:本文方案使人形机器人可在多样条件下完成视觉驱动的反应式足球技能©【深蓝具身智能】编译
-
过往端到端强化学习人形足球方案
部分工作利用强化学习学习踢球行为,但大多依赖运动捕捉系统提供的精确全局状态,无法脱离实验室环境;少数视觉版本,需要耗费巨大算力渲染NeRF场景,仿真‑真机迁移后,反应速度、成功率会出现明显跳水,很难直接用于真实比赛。
以上两类方案,共同的短板是:没有把感知不确定性作为策略训练的内生条件,感知要么是完美真值,要么作为独立前置步骤,策略本身不会去理解“现在我可能没看清楚球”这件事。
这项登顶Science Robotics的研究正是针对该痛点给出的完整解法。
整套框架三大核心模块
整套框架基于PPO强化学习,结合AMP对抗运动先验、虚拟感知系统、编码器‑解码器时序表征、多Critic架构,在仿真完成全部训练,硬件无需改动直接部署Booster T1人形机器人(1.2m、30kg)。
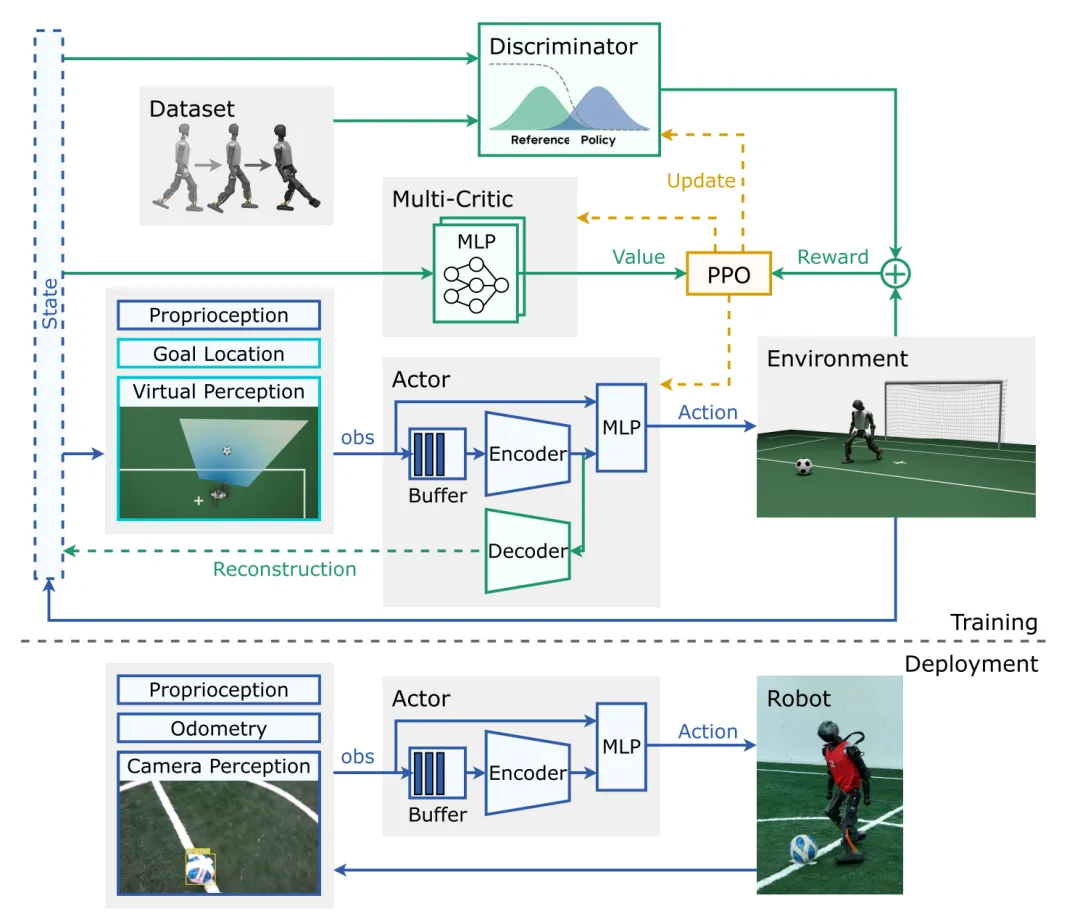
图| 本文提出的学习框架。上方是仿真训练流程,下方是真机部署流程;Actor接收部分观测,编码器‑解码器从历史数据重建辅助状态信息;策略由PPO更新,同时结合来自判别器的运动先验奖励;硬件仅部署蓝色标注部分的模块©【深蓝具身智能】编译
AMP对抗运动先验:让机器人学自然人类踢球动作
对抗运动先验AMP在人形模仿学习领域并不新鲜,但大多只用本体自身状态做模仿。
本文把AMP迁移到存在感知噪声的视觉驱动场景。
研究收集了人体全方位行走、脚弓踢球动作的动捕数据,经过重定向适配机器人本体,训练判别网络区分机器人运动轨迹和人类参考运动片段。
判别器输出风格奖励,引导机器人生成贴近人类的流畅步态。
这里有一个巧妙设计:不是固定复刻参考动作,只是提供风格约束。
策略会根据足球位置生成参考数据集里不存在的新动作,典型例子就是支点钩射:球门位于机器人身后,机器人以单脚为轴心横向摆腿把球勾向球门,不需要原地完整转身,大幅缩减动作耗时。
虚拟感知系统:仿真复刻真实相机的全部缺陷
这是实现零样本sim‑to‑real迁移的关键。团队拿真实机器人实地采集1小时数据集,记录真实相机的检测成功率、位置噪声分布、更新频率、时间延迟,以及视场FOV约束。
在仿真训练的时候,不再直接喂给策略球的真实坐标,而是调用这套虚拟感知系统输出带有噪声、随机丢检测、存在时延的观测,完全复刻真机上会遇到的视觉缺陷。
简单理解:训练的时候就故意给机器人“看不清楚的画面”,而不是理想仿真真值。
这样策略训练完成,面对真机上同样的感知缺陷,不会直接失效。 策略拿到的不是原始RGB图像,而是抽象结构化信息:球相对机器人坐标、球门位置、检测是否有效的布尔标记,这样大幅降低计算负担,同时过滤掉光照、纹理这类无关干扰,提升跨环境泛化能力。
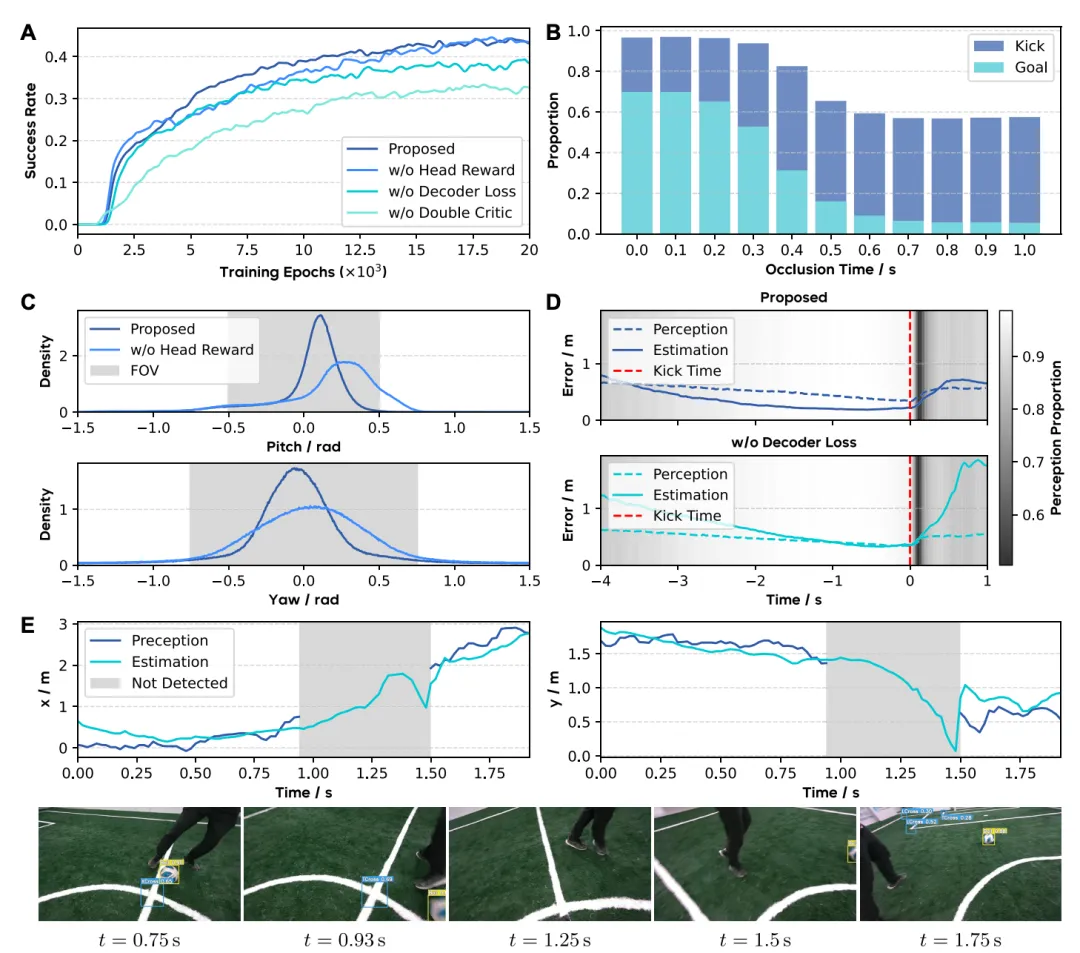
图| 感知‑动作协同分析。A不同消融设置训练曲线;B不同遮挡时长下踢球与进球成功率;C球在相机视场内的角度分布;D有无解码器损失情况下感知误差对比;E球移出视场之后,策略依靠历史隐状态预测球运动,引导机器人重新找回目标©【深蓝具身智能】编译
编码器‑解码器 + 多Critic架构,利用时序记忆对抗感知失效
机器人保存过去1秒一共50帧历史观测,编码器把时序观测压缩成64维隐表征。训练阶段,解码器尝试从隐状态重建真机拿不到的特权信息,例如球真实位置、机器人动力学参数。
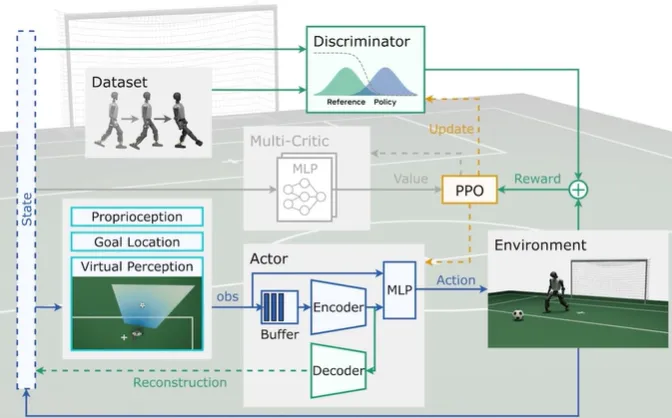
注:部署阶段解码器直接丢弃,不会参与推理。训练阶段解码器只是作为损失函数,倒逼编码器的隐状态把球的真实运动信息编码进去。 实际运行时,即便球短暂跑出视野,策略也能依靠这一段历史隐状态,推断球的大致去向,表现出主动转头搜寻、原地旋转扫描等涌现行为。
同时研究使用了多Critic设计,把进球稀疏奖励、运动风格奖励拆分成两组价值估计器,分别估算回报,再加权计算优势函数更新策略。
解决进球奖励极度稀疏带来梯度噪声大、训练震荡的问题。
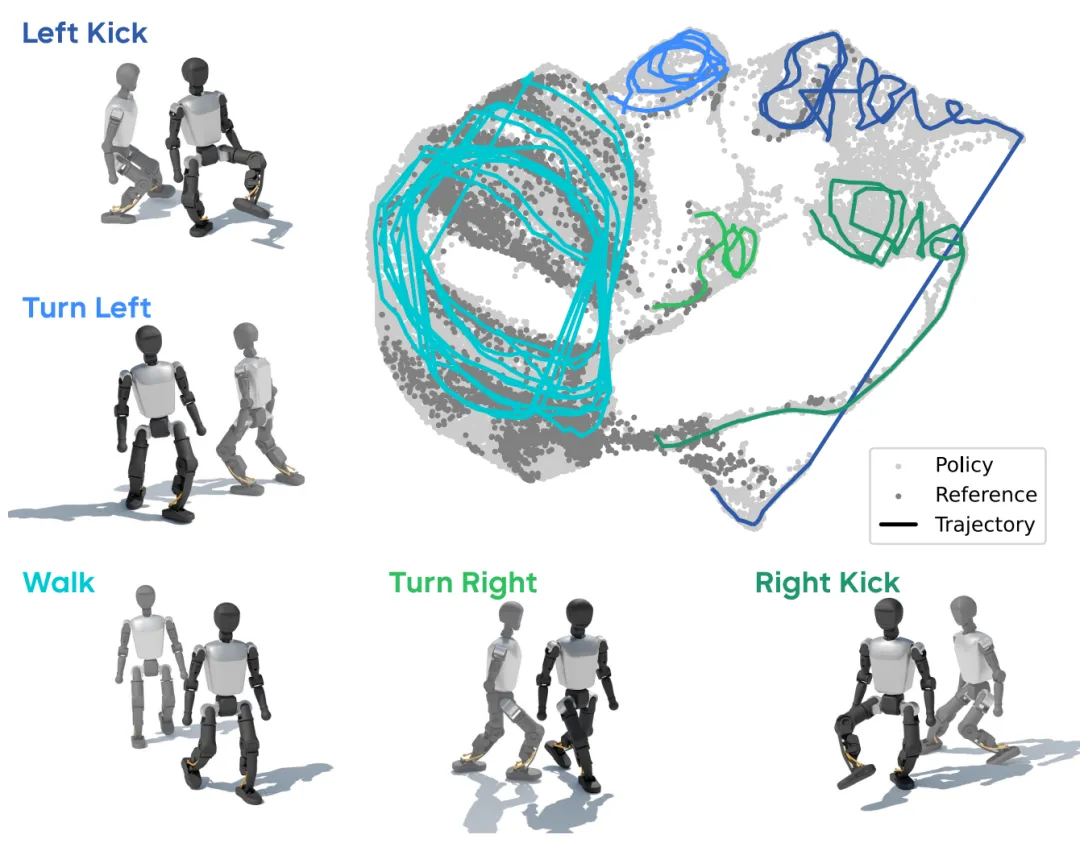
图 | 多样步态行为可视化。利用UMAP把关节轨迹降维到二维平面,可以看到策略自发形成5类清晰步态簇:直行、左转、右转、左脚踢球、右脚踢球,策略可以在这些行为之间平滑切换,完成搜球、追球、射门连贯任务©【深蓝具身智能】编译
实验:指标数据、行为涌现与真实赛事表现
实验分为仿真测试、真机多场景测试、RoboCup真实比赛三个层级。需要注意,论文中大部分指标来自可控测试集,真实赛场环境更复杂,指标会存在一定衰减。
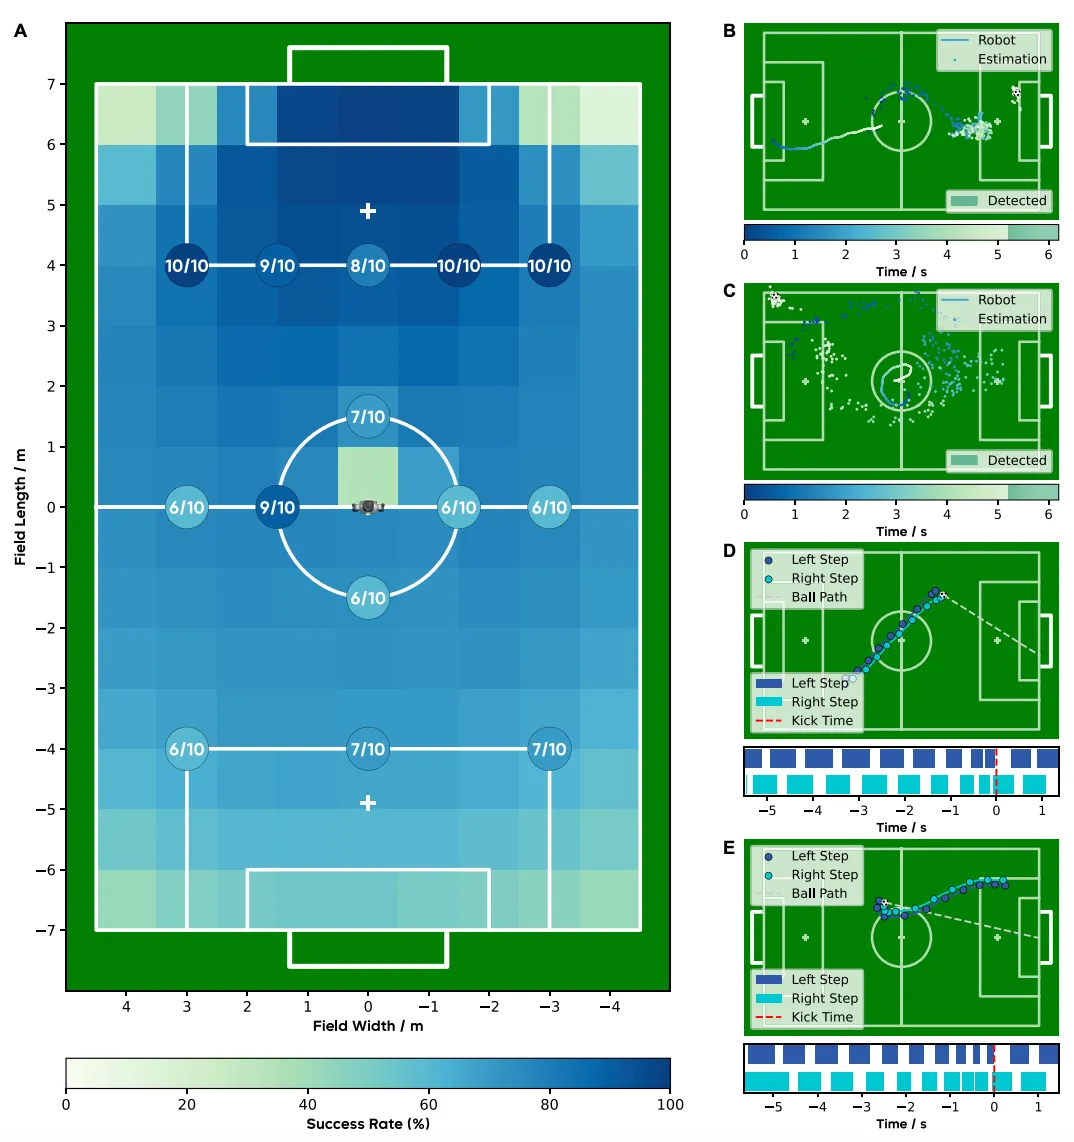
图 | 验证与行为分析。A是仿真8192次测试得到的场地热力成功率图,圆圈代表真机10次重复测试结果;B‑E展示机器人搜球行为和自适应步态,接近足球时步频变快、步幅缩短,方便微调落脚点完成射门©【深蓝具身智能】编译
关键定量指标对比(对比规则基准方案)
球位置估计均方根误差降低46%。射门前最后一秒,原始感知误差0.344m,策略内部估计下降到0.186m。
人形机器人脚弓才0.23m,这个量级误差降低对踢球命中至关重要。
踢球耗时大幅缩短:规则基线,机器人背对球门时踢球耗时接近5秒;这套学习策略无论初始朝向,平均约1.5秒完成踢球动作,时间最高缩短64%。
真机成功率:前场靠近球门位置80‑90%,后场难度较高区域60‑70%;所有测试没有出现机器人摔倒,平衡稳定性表现优秀。
视觉遮挡鲁棒性:仿真模拟球检测被屏蔽,0.3秒以内短暂遮挡,依然90%试验可以完成踢球;遮挡超过0.6秒,机器人识别观测失效,自动切换旋转搜球模式。
滚动足球测试:球速0.5m/s以内,踢球成功率大于50%;球速进一步提升,拦截难度上升,成功率逐步下降。机器人会出现侧向碎步拦截、原地快速转身等动态响应步态。
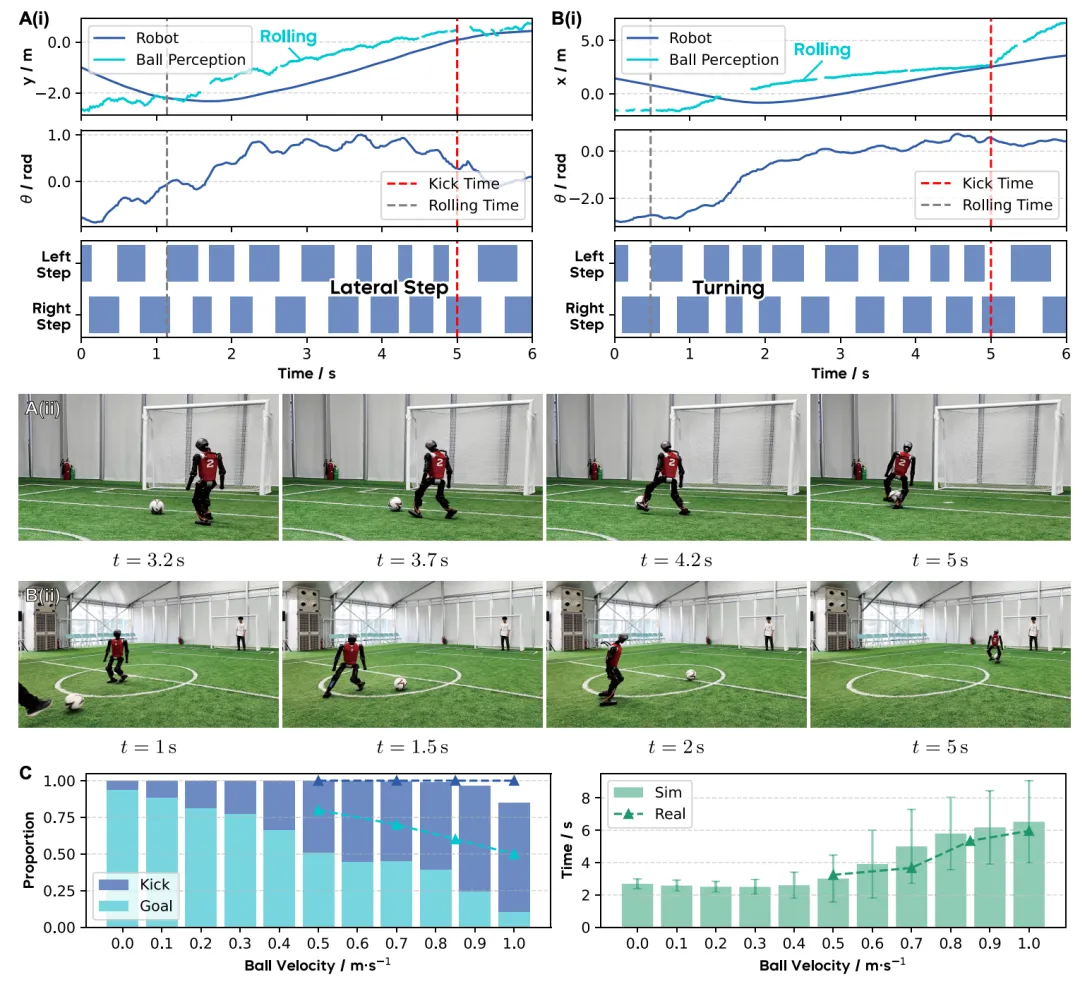
图| 滚动足球反应式踢球。A为足球横向滚动,机器人敏捷侧向移动拦截;B为足球滚向机器人后方,机器人两步之内完成大角度转向;C为不同球速下踢球、进球成功率与耗时,包含仿真与真机结果对比©【深蓝具身智能】编译
非常有意思的涌现行为
这套统一策略并没有人工写这些逻辑,全部是强化学习训练中自发产生:
主动感知行为:球跑到视野边缘,机器人主动转动头部、躯干,把球拉回相机视场中心,维持跟踪。
分策略搜球逻辑:丢失球的时候,如果机器人处在场地边缘,机器人优先向场地中心移动扩大可视范围;到达中心之后,原地旋转扫描全场。
自适应步态切换:离球远的时候,步频低、步幅大,兼顾移动效率和视觉跟踪;靠近足球瞬间,自动切换为小步快频步态,精细调整落脚点,为踢球做准备。
特殊钩射动作:球门在身后,直接单支点侧摆腿勾射,省去原地大回转,压缩反应时间。
RoboCup真实赛事落地
该算法作为技能模块集成进了清华火神队完整比赛系统。
RoboCup成人尺寸人形联赛规则限制严苛:机器人全部自主运行,禁止激光雷达、多摄像头这类超越人类感知能力的传感器,只允许机载单相机。
比赛场地光照、地面条件会变化,赛前留给机器人调试时间很短。队伍拿下RoboCup2025成人组、世界人形机器人运动会双冠军,总共打进76球,丢11球。场上会出现对手冲撞、视觉遮挡,算法模块依然稳定输出踢球技能。
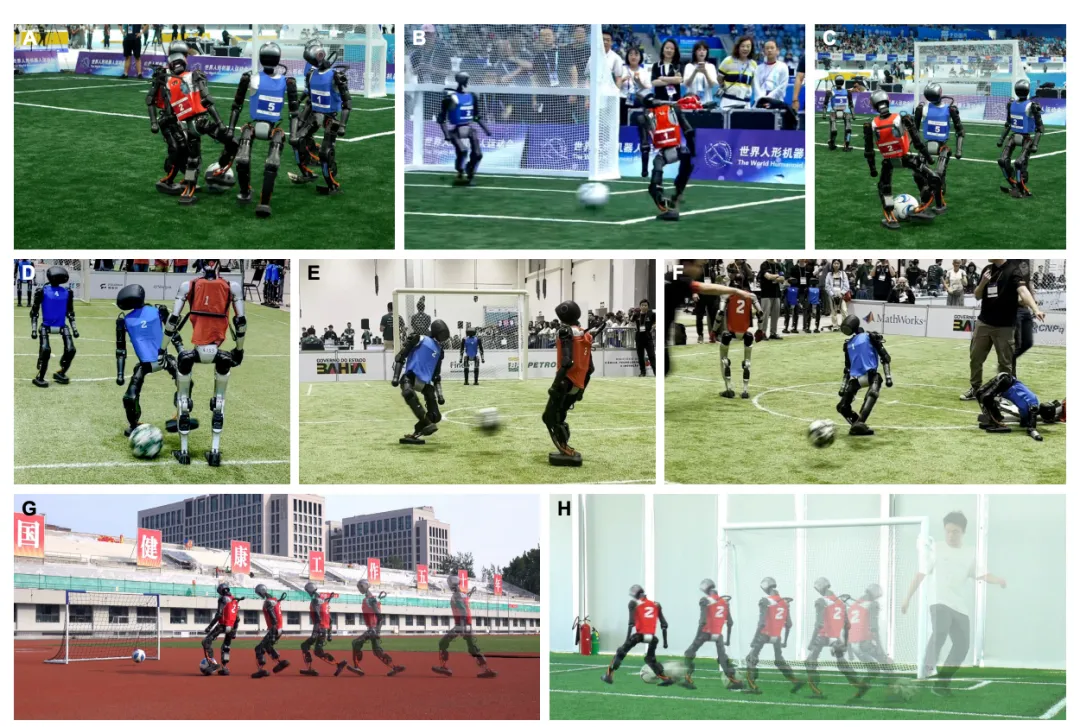
图| 控制器在各类场景下的表现。A‑C世界人形机器人运动会比赛;D‑F RoboCup比赛;G‑H机器人对足球的动态响应;©【深蓝具身智能】编译
落地启示
很多人形机器人任务,现实硬件一定会遇到噪声、延迟、目标短暂丢失。传统思路是感知模块尽量修复所有问题;而这套工作把传感器缺陷直接放进仿真训练循环,策略在优化运动的同时,同步学会怎么“看懂不完美的信号”,甚至衍生转头搜球、时序推断等主动感知行为。
这篇工作给人形具身智能提供一个很有参考价值范式:与其一味追求感知模块输出完美无缺的真值,不如让控制策略本身去学习处理感知的不确定性。
当然,这并不代表模块化方案彻底过时。这套算法是踢球底层技能模块,完整机器人比赛系统,依然需要上层的高层战术、状态管理模块配合。
但它证明,感知‑运动紧耦合统一策略,可以真正走出仿真,在严苛真实对抗赛场稳定发挥。
编辑|小小怪博士
审编|具身君
Ref
论文标题:Learning vision‑driven reactive soccer skills for humanoid robots
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
