

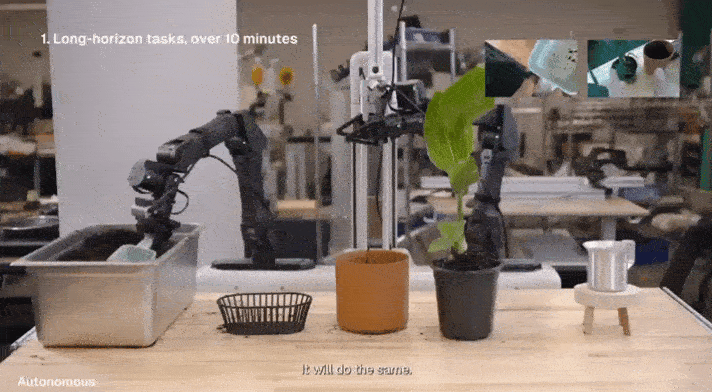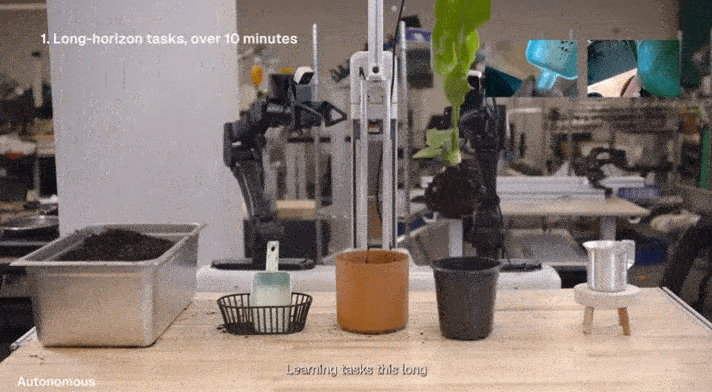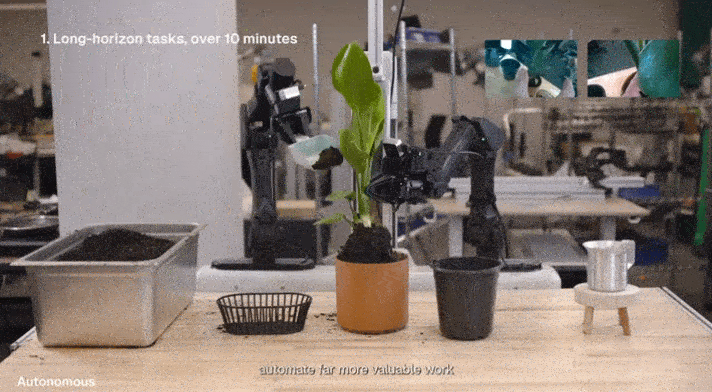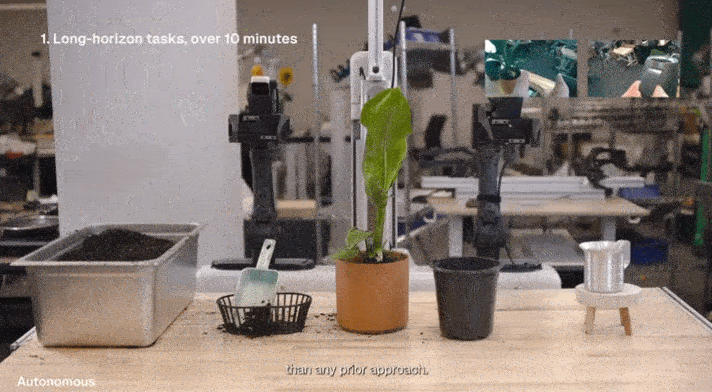
迄今为止,机器人技术一直停留在BERT时代。
——任务由视频演示指定,而非语言
大语言模型最关键的一步跃迁,不是参数变大,而是从BERT时代的"每个任务都要微调"走到GPT的"给个提示就能干"——也就是上下文学习。
机器人领域至今还卡在BERT阶段:想让机械臂学一个新任务,先花几小时遥操作采集数据,再跑一轮任务专属微调,验证完才能上线。换一个任务,整套流程重来一遍。
Skild AI发布的旗舰机器人基础模型S1,把上下文学习正式搬进了机械臂操作。
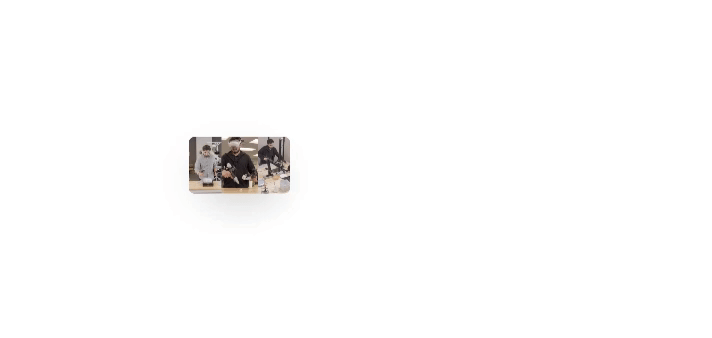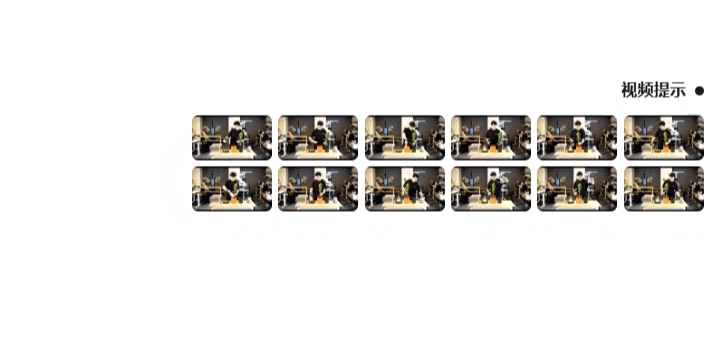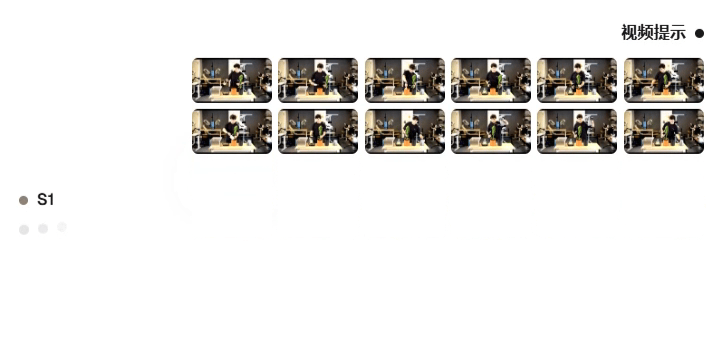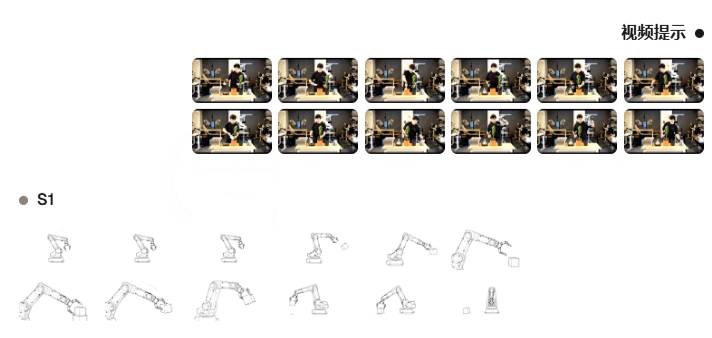
▲任务演示进入上下文窗口,策略将其翻译为自身形态与当前场景下的动作©【深蓝具身智能】编译
给它看一段人类演示视频,不管任务训练时见没见过、时长5秒还是10分钟,它直接在真机上执行,不微调、不后训练,同一套权重跑全部任务。
盆栽换盆、摊煎饼、手冲咖啡、套件组装这四个训练集里完全没有的长时序任务,单段视频演示即可驱动,从录演示到机器人自主跑起来最短11分钟。
为什么机器人需要上下文学习,而不是语言提示
现在主流VLA(视觉语言动作)模型用语言指令指定任务,“把杯子拿起来"这种原子动作确实够用。但任务一旦变复杂、变长时序,语言就不够用了。
没人能用一句话讲清楚怎么套床单、怎么把蛋白打到硬性发泡、怎么系一个特定的结。
人在这种时候会停止描述,开始"做给你看”。
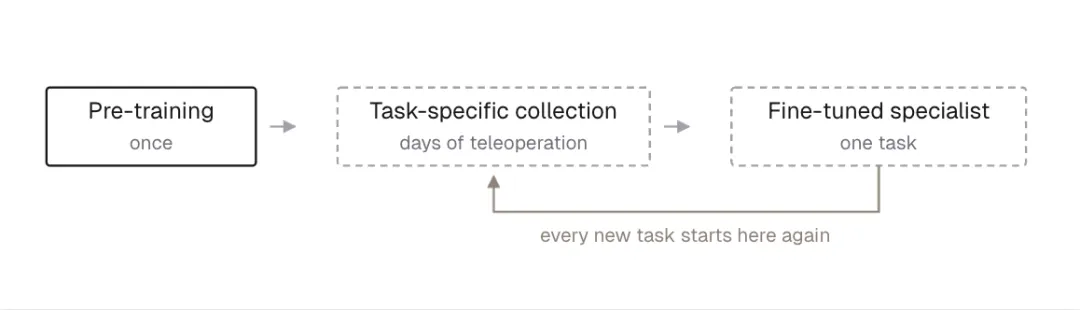
▲图 | 传统机器人学习流水线:每遇到一个新任务,都要从头采集数据、微调专用策略©【深蓝具身智能】编译
S1的核心判断就是:机器人的任务指定方式应该从语言转向视频演示。
预训练阶段,每个任务只用一段上下文演示来指定,演示可能来自不同场景、不同视角、甚至不同本体,策略被迫去理解演示者的意图、功能对应关系和任务进度,而不是死记硬背某条轨迹。
用元学习的话说,预训练是"外环",教会策略怎么从上下文里学;推理时演示驱动"内环",权重一个都不动。
这就引出评估上下文学习能力的两条轴:
-
任务是否在预训练分布内(已见 vs 完全未见);
-
任务是短时序原子动作,还是长时序需要组合新技能。
目前同期的机器人上下文学习工作,基本都集中在短时序、已见任务上。
S1是第一个在长达10分钟、训练完全没见过的任务上展示上下文学习的机器人基础模型。
数据引擎:没有单一数据源能同时赢三个维度
高质量数据是基础模型的核心,但机器人数据的麻烦在于,没有任何一个来源能同时占住三个关键维度:
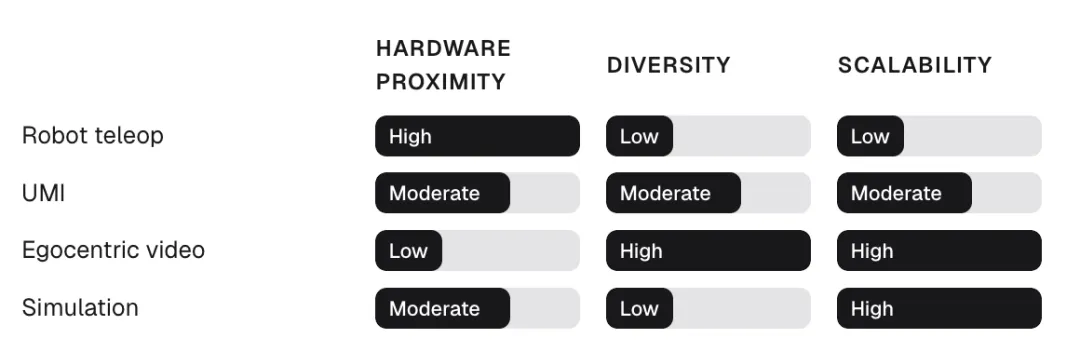
▲图 | 各类机器人数据源在硬件接近度、多样性、可扩展性三维度上的权衡:遥操作最贴近硬件但最难扩展,第一视角视频正好相反©【深蓝具身智能】编译
-
硬件接近度:数据和部署硬件有多像;
-
多样性:覆盖多少任务、场景、行为;
-
可扩展性:多采一份数据的成本有多高。
遥操作最贴近机器人本体,但采集最慢、最贵;第一视角视频(egocentric video)规模最大、场景最丰富,但和机器人本体之间域差距最大;UMI(单手遥操作采集)居中;仿真可扩展性强但多样性和真实感有限。
Skild的做法是四条线同时在内部扩,并且数据质量控制投入是采集投入的三倍
——每花1美元采数据,花3美元做质量筛查,低质量噪声数据盲目放大反而有害。
S1实际能做什么,以及指标背后的真实含义
已见任务:宽基础操作能力
预训练池覆盖大量操作原子技能,S1可以在分布内执行各类抓取、放置、整理任务。
这部分不是重点,因为已见任务上传统VLA本来就不差。
未见长时序任务:真正的差异化
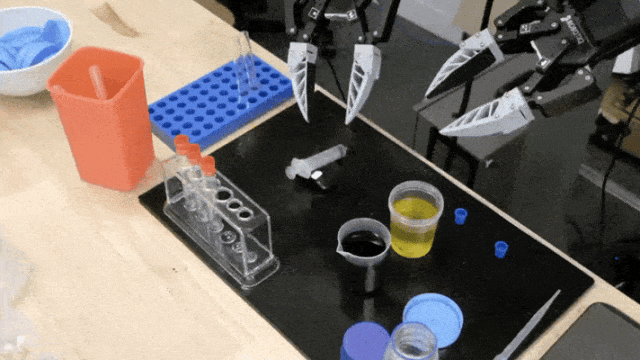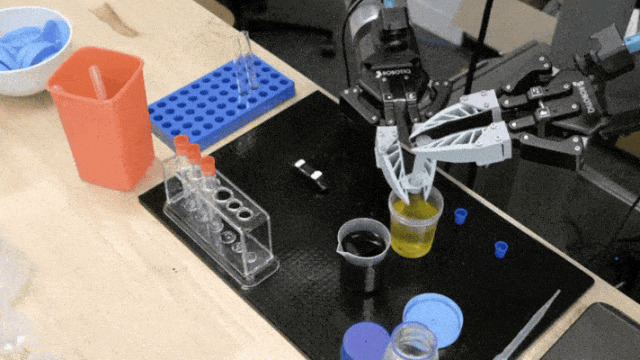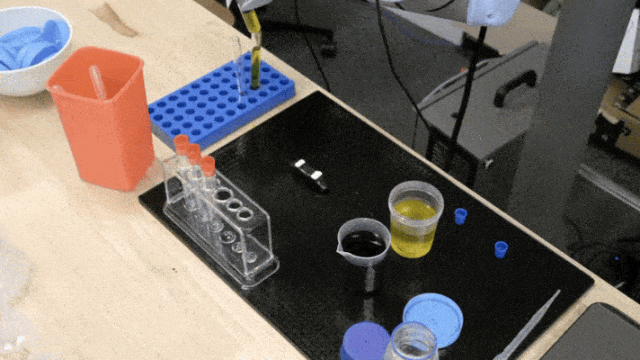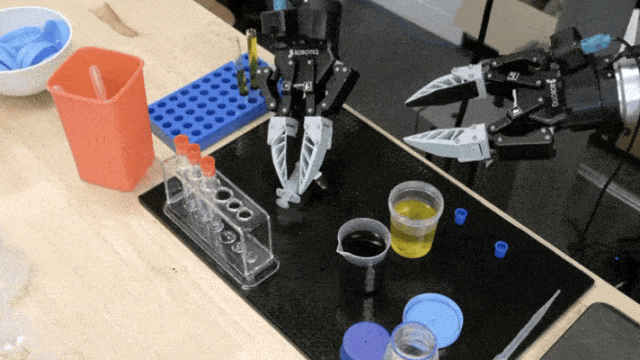
四个训练集完全没有的任务:盆栽换盆、摊煎饼、手冲咖啡、套件组装。
每个任务最长10分钟,包含几十步操作,全部由单段视觉演示驱动。S1不仅组合了已知技能,还出现了训练时没有的全新行为——比如挖土给植物腾位置、把咖啡滤纸压进漏斗、翻煎饼。
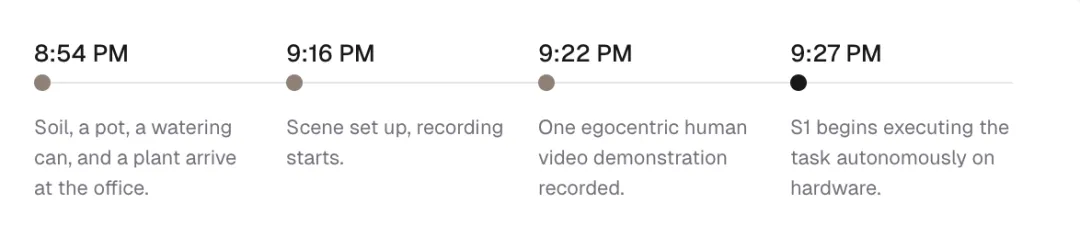
盆栽任务的时间线很能说明问题:晚上8:54材料送到办公室,大部分时间花在搬家具摆场景,9:22录完一段第一视角人类演示,9:27机器人开始自主执行。
从演示到真机跑起来11分钟。
传统流程下,这个任务先要几小时遥操作采集,再微调,再验证,至少是天级周期。
ICL缩放定律:未见任务上7倍差距
这是全文最硬核的量化部分。在1k到100k小时数据上,分别训练ICL策略和语言prompt策略,数据、架构、算力完全一致,只改prompt嵌入方式。
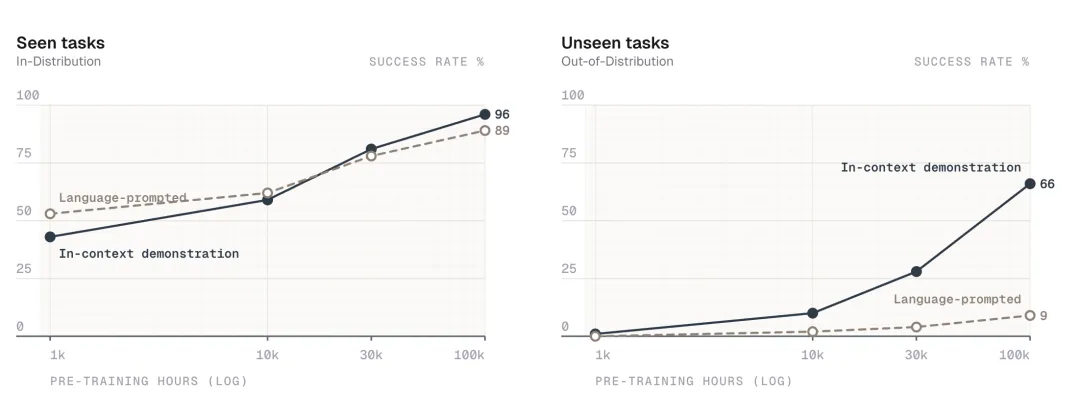
▲图 | 成功率随预训练规模变化,对比上下文演示与语言提示:左为已见任务,右为未见任务©【深蓝具身智能】编译
-
已见任务:
小数据(1k小时)时语言prompt反而领先(53% vs 43%),因为语言把任务压缩成token,ICL在小数据上容易过拟合高维条件信息。
但随着数据放大,ICL反超——语言指令允许多种合理执行方式,而演示直接指定了一种模式,歧义更少。
-
未见任务:
100k小时数据下,语言prompt成功率只有9%,ICL达到66%,7倍差距。原因有二:
一是新技能(比如翻煎饼)语言根本没有动作根基,ICL靠广泛视觉对应关系迁移更好;
二是长时序组合任务,语言太粗,没法精确描述一个从未要求过的技能链,演示直接把组合写清楚了。
不过这里的成功率是"每步平均成功率",评测时用人工介入从失败中恢复以确保所有步骤都被评分。66%不是端到端一次跑通的概率,而是平均每一步的成功比例。
另外评测集是内部基准,不是公开第三方榜单,数字的绝对值需要谨慎看待,趋势(ICL在未见任务上显著优于语言prompt)才是核心信息。
一次演示≈380次后训练样本
把差距换算成更直观的概念:
对一个新任务,语言prompt策略需要做多少次后训练遥操作,才能追上ICL策略看一次演示的效果?
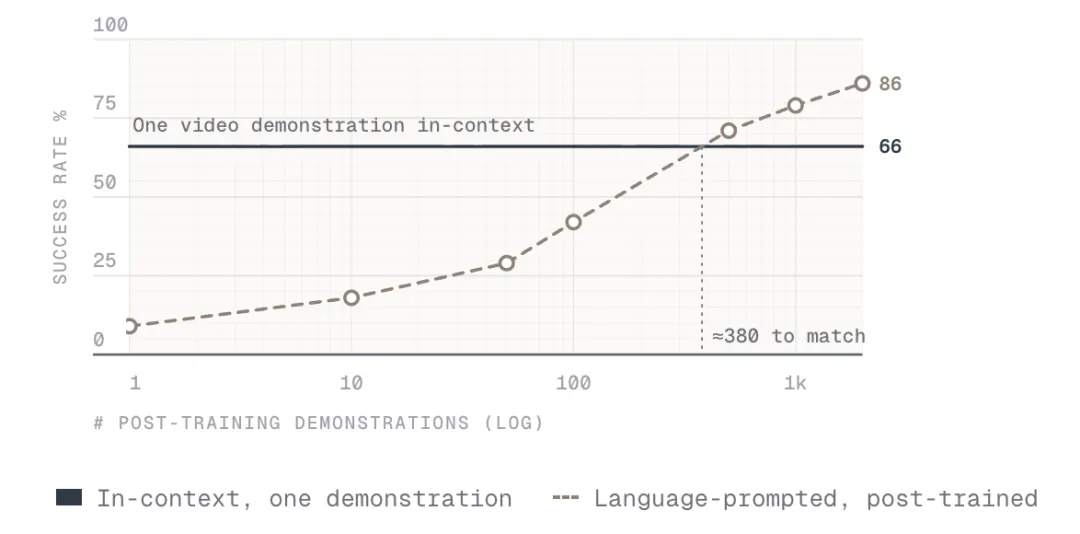
▲图 | 匹配一次上下文演示所需的后训练样本数量:一次视频演示约等于380次后训练样本©【深蓝具身智能】编译
答案是约380次。
ICL策略从不后训练,看一次演示就到66%;语言prompt策略后训练到2000次样本才到86%。
当然,后训练最终能超过ICL,但Skild预期随着ICL预训练继续放大,这个差距会缩小。
涌现出来的特性,以及横向行业定位
抗扰动、错误恢复、常识推理、甚至修正演示
S1表现出几个不是专门训练但自然涌现的行为:
-
抗扰动:执行中把物体滑走、换掉物体、改变光照,这些演示里没出现过,S1照样完成任务;
-
错误恢复:失败了会重试,而不是闷头继续——哪怕是滑板轮组装这种未见任务也能恢复;
-
常识推理:演示里用浇水壶浇花,但现场只有一杯水,S1直接用杯子代替;演示里往杯子倒果汁,但杯子已经快满了,S1只补到满;
-
修正演示:演示者自己有时会犯错(比如打鸡蛋太早弄洒),S1执行时用更稳的动作完成同一步——它把演示当成目标规格,而不是要复刻的轨迹。
分布偏移鲁棒性:五级扰动测试
选一个已知任务,从L1到L5逐级加大部署场景和训练条件的偏移:
L1同物体同位置,L2物体随机偏移15cm/30°,L3偏移30cm/45°,L4换成功能相似但不同的物体,L5迫使一半动作换到另一只手臂执行。
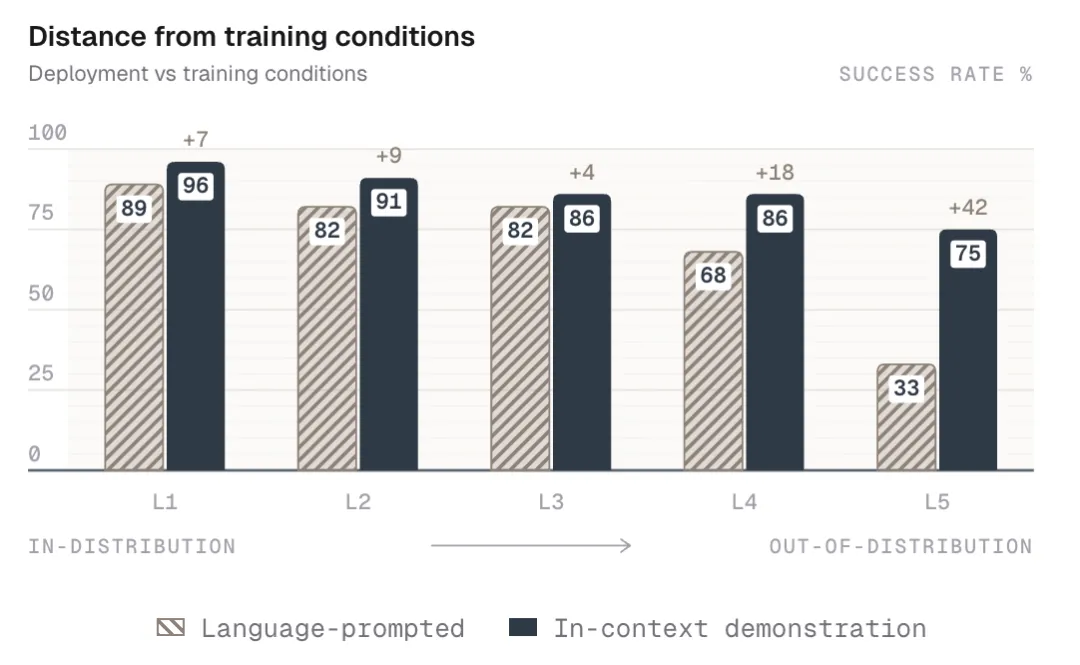
▲图 | 部署场景偏离训练条件时的成功率:L5强扰动下语言prompt策略退化幅度是ICL的三倍©【深蓝具身智能】编译
L5强扰动下,语言prompt策略退化幅度是ICL的约三倍。
VLA对物体姿态小变化还行,但一旦需要新动作(新物体或新位置迫使新执行计划)就崩;ICL可以直接用一个适配部署条件的演示来提示,灵活度高得多。
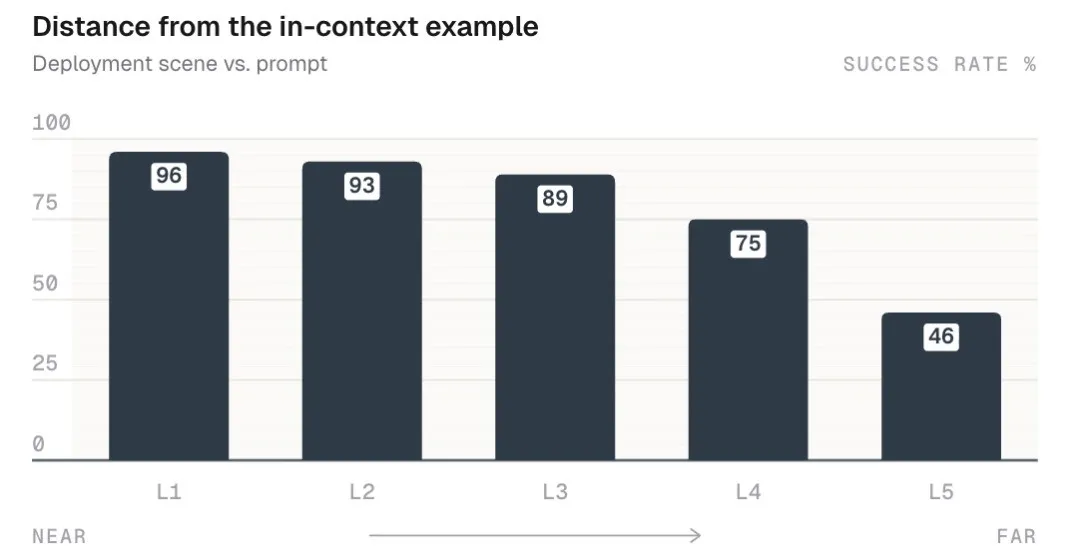
▲图 | 部署场景偏离上下文演示时的成功率:ICL对物体位置偏移甚至物体替换都鲁棒,只有执行计划被迫大变时才明显下降©【深蓝具身智能】编译
写在最后
机器人可以像大语言模型一样,通过预训练获得"从一段演示里立刻学会新任务"的能力,而不是每个任务都从零采集微调。
一次演示约等于380次后训练样本,从录演示到真机执行11分钟——这两个数字如果能在更多场景、更多硬件上复现,机器人部署的经济模型会被根本改变。
过去机器人落地慢,不是算法不够好,而是每个新场景、新任务都要重复一遍数据采集-微调-验证的闭环,成本和周期压得商业化走不动。上下文学习如果真的成立,机器人就能像人一样,看一遍就上手,不行再看一遍。
当然,现在还早。
内部基准、桌面场景、每步成功率而非端到端成功率,这些都是需要继续夯实的地方。
编辑|小小怪博士
审编|具身君
Ref:
Introducing S1: In-Context Learning for Robotics
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
