

从 VLA 闭环到多物理场耦合的全栈实战
——Exploration in 4 stages
做具身智能,最贵的或许不是模型,而是验证。
为啥这么说?模型侧其实越来越便宜:开源 VLA 一大把,权重直接下,单卡推理成本也可控,训练或下载一次就归你用了。
但"它到底行不行"这个问题,只能靠反复测来回答,而真实机器人上的每一次评估都在持续烧钱。
模型是买断的,验证却是持续计费、还没上限的。
这篇文章,我们把仿真验证本身做成一个标准化的、高吞吐的工程底座。
记录了用 Genesis World 把 VLA、强化学习和多物理场仿真都跑到同一张 A800 上的全部过程:
从 Franka 的单场景闭环,到 Go2 的 2048 环境并发训练,再到布料、海绵、水流的刚柔耦合。
把这条从 0 跑通的路径,和一路踩过的坑和各位分享。
本文全文15000字,建议收藏分享~
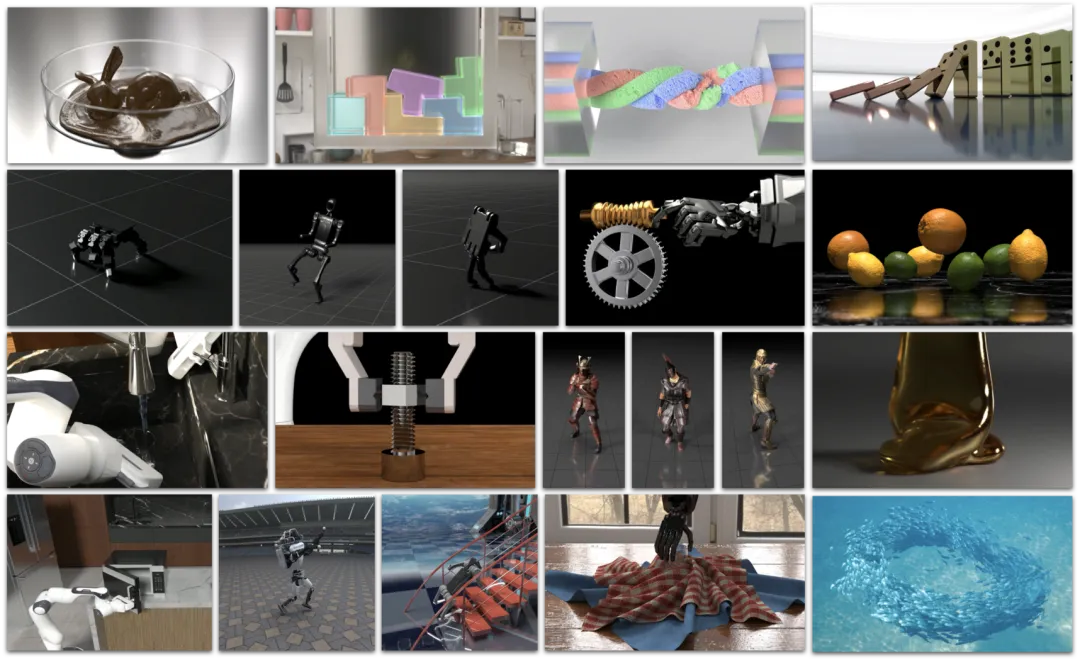
Stage 1:基于 Genesis World 与 OpenVLA 的具身智能闭环仿真测试
在具身智能(Embodied AI)研究中,Vision-Language-Action(VLA)大模型是连接高层语义理解与低层物理控制的核心桥梁。传统的仿真测试往往面临环境搭建繁琐、渲染与物理解算效率低下等问题。
作为新一代物理仿真平台,Genesis World 提供了轻量级的 GPU 加速物理引擎与高质量渲染器,为 VLA 模型的闭环评估提供了极具吸引力的基础设施。
在项目的第一阶段(Stage 1),我们的目标是在无图形界面的云服务器环境上,跑通“视觉输入 VLA 模型推理 动作反归一化与逆运动学(IK)解算 仿真步进 视频渲染导出”的端到端闭环测试。
实验环境与基础配置
由于项目运行在无 GUI 的云端 Headless 服务器上,环境的显卡驱动与 CUDA 配置具有较强的约束性。
为确保物理引擎(基于 Taichi CUDA)与 PyTorch 深度学习框架能够稳定共存,部署环境参数如下:
-
操作系统:Ubuntu 22.04 LTS (x86_64, glibc 2.35) -
计算显卡:NVIDIA A800-SXM4-40GB(显存 40 GiB,Compute Capability 8.0) -
显卡驱动:NVIDIA Server Driver 580.159.03(云服务器固定版本) -
CUDA 环境:CUDA Toolkit 11.8 ( nvcc V11.8.89) -
Python 环境:Python 3.12.13, PyTorch 2.10.0+cu128 -
核心工具链: genesis-world 1.2.2+gs-nyx 0.1.3(渲染器)
算法模型与机器人本体选型及获取
在机器人本体与 VLA 模型组合的选择上,我们选用了开源社区中具有代表性的 Franka Emika Panda 机械臂,配合开源微调模型 tshiamor/openvla-mcx-card 进行闭环评测。
-
VLA 模型来源与规格
tshiamor/openvla-mcx-card 是基于斯坦福等机构开源的 OpenVLA-7B 在 NVIDIA Isaac Sim 环境中针对 Franka Panda 机械臂微调得到的 8B 参数量视觉-语言-动作模型。
该模型专门针对桌面抓取与放置任务(例如针对蓝块的“Pick up the blue block and place it on the target”)进行了参数优化。
该模型使用 torch.bfloat16 精度加载时约占用 14~15 GB 显存,A800 40GB 显存足以同时容纳模型推理与 Genesis 仿真器的运行。
-
机器人本体构型
仿真场景中的机器人选用标准的 Franka Emika Panda,包含 7 个臂部旋转关节(7-DOF)与 2 个平行夹爪手指关节(2-DOF,行程 0.0m ~ 0.04m)。
在 Genesis 中,机器人本体直接通过 Genesis 官方资产库中预置的 URDF 文件加载,路径位于 genesis/assets/urdf/panda_bullet/panda.urdf。
末端执行器(EEF)选定为 panda_link7,夹爪两指分别为 panda_leftfinger 和 panda_rightfinger。
端到端闭环测试跑通过程与代码示例
闭环测试的核心逻辑包含一个每秒 100 步()的仿真循环。
在循环的每一帧中:
-
视觉采集:利用场景中的相机渲染当前桌面的 224×224 RGB 图像。 -
VLA 推理:将图像与文本指令(例如 "Pick up the blue block and place it on the target")输入 OpenVLA 模型,预测出 7 维相对动作向量()。 -
动作映射与 IK 解算:对预测的相对位移进行反归一化与缩放,计算出末端执行器的目标三维位置与姿态四元数;随后调用 Genesis 内置的逆运动学(IK)求解器,将其解算为 Franka 的 7 个臂部关节角度。 -
控制与步进:使用 PD 控制器将目标关节角下发给机器人,并步进物理引擎;同时通过宽视角相机捕获画面并实时写入 MP4 视频文件。
以下为简化后的闭环测试关键代码结构:
import os
import cv2
import numpy as np
import torch
from PIL import Image
from transformers import AutoModelForVision2Seq, AutoProcessor

# 【关键点 1】:必须在 Genesis 初始化之前加载 PyTorch VLA 模型,避免显存分配冲突
model_path = "/mnt/robot/models/openvla-mcx-card"
processor = AutoProcessor.from_pretrained(model_path, trust_remote_code=True, local_files_only=True)
model = AutoModelForVision2Seq.from_pretrained(
    model_path,
    torch_dtype=torch.bfloat16,
    trust_remote_code=True,
    device_map="auto",
    local_files_only=True
).eval()

# 【关键点 2】:模型加载完毕后,再初始化 Genesis 物理引擎
import genesis as gs
gs.init(backend=gs.gpu)

# 搭建场景
scene = gs.Scene(show_viewer=False, sim_options=gs.options.SimOptions(dt=0.01))
plane = scene.add_entity(gs.morphs.Plane())

# 加载 Franka 机械臂、桌面与目标蓝块
franka_urdf = os.path.join(os.path.dirname(gs.__file__), "assets", "urdf", "panda_bullet", "panda.urdf")
franka = scene.add_entity(gs.morphs.URDF(file=franka_urdf, pos=(0.0, 0.0, 0.0)))
table = scene.add_entity(gs.morphs.Box(pos=(0.6, 0.0, 0.1), size=(0.6, 0.8, 0.2), fixed=True),
                         surface=gs.surfaces.Plastic(color=(0.6, 0.6, 0.6)))
blue_block = scene.add_entity(gs.morphs.Box(pos=(0.71, 0.01, 0.22), size=(0.04, 0.04, 0.04)),
                             surface=gs.surfaces.Plastic(color=(0.0, 0.0, 1.0)))

# 设立双相机:cam 供 VLA 推理输入 (224x224),wide_cam 供人类视角的 MP4 导出 (640x480)
cam = scene.add_camera(res=(224, 224), pos=(1.0, 0.0, 0.5), lookat=(0.57, -0.08, 0.22), up=(0, 0, 1))
wide_cam = scene.add_camera(res=(640, 480), pos=(2.2, 1.6, 1.7), lookat=(0.4, 0.0, 0.35), up=(0, 0, 1), fov=45)

scene.build()

motors_dof = np.arange(7)
fingers_dof = np.arange(7, 9)
end_effector = franka.get_link("panda_link7")

# 配置高刚度 PD 增益以实现精确的关节追踪
franka.set_dofs_kp(np.array([4500, 4500, 3500, 3500, 2000, 2000, 2000]), motors_dof)
franka.set_dofs_kv(np.array([450, 450, 350, 350, 200, 200, 200]), motors_dof)

# 闭环推理控制循环
instruction = "Pick up the blue block and place it on the target"
prompt = f"In: {instruction}\nOut:"

for step_idx in range(500):
    # 1. 采集 VLA 视角图像并预处理
    img_vla = cam.render(rgb=True)[0] if isinstance(cam.render(rgb=True), tuple) else cam.render(rgb=True)
    pil_img = Image.fromarray(img_vla.astype(np.uint8))

    inputs = processor(prompt, pil_img)
    inputs = {k: v.to("cuda", dtype=torch.bfloat16) if v.is_floating_point() else v.to("cuda") for k, v in inputs.items()}

    # 2. VLA 推理预测动作
    with torch.inference_mode():
        raw_action = model.predict_action(inputs["input_ids"], unnorm_key="bridge_orig", do_sample=False, pixel_values=inputs["pixel_values"])
    raw_action = raw_action.cpu().float().numpy() if isinstance(raw_action, torch.Tensor) else np.array(raw_action, dtype=np.float32)

    # 3. 动作反归一化与 IK 求解
    pos_scale = 0.08
    delta_pos = raw_action[:3] * (pos_scale / 0.05)
    current_pos = end_effector.get_pos().cpu().numpy()
    current_quat = end_effector.get_quat().cpu().numpy()

    target_ee_pos = current_pos + delta_pos
    # 调用 IK 求解器获取广义坐标 qpos (16,),并截取前 7 个臂部关节角
    qpos_target = franka.inverse_kinematics(link=end_effector, pos=target_ee_pos, quat=current_quat)
    joint_targets = qpos_target[motors_dof]

    # 4. 执行控制与物理步进
    franka.control_dofs_position(joint_targets, motors_dof)
    scene.step()
实践过程中的“坑”与经验总结
在将 Genesis 与 OpenVLA 结合的过程中,遇到并解决了几处关键的底层兼容性问题:
-
框架初始化顺序冲突(Taichi CUDA vs. PyTorch CUDA)
-
现象:若先调用 gs.init(backend=gs.gpu)初始化 Genesis,再调用AutoProcessor或AutoModelForVision2Seq,会导致底层张量类型转换崩溃(如报错RuntimeError: can't convert cuda:0 device type tensor to numpy)。 -
原因:Genesis 内部使用的 Taichi 编译器在 GPU 初始化时会拦截/改变默认的 CUDA context 状态。 -
解决方案:在代码逻辑中,必须确保先加载 PyTorch VLA 模型并完成 GPU 挂载,随后再初始化 Genesis。
-
Genesis 1.2.2 API 命名与结构约束
-
API 变动: gs.morphs.Franka()在 1.2.2 版本中已被弃用或不存在,必须通过gs.morphs.URDF显式加载物理文件。 -
材质传参位置:物体颜色与材质( surface)不能直接作为参数写在gs.morphs.Box()中,而必须在scene.add_entity(morph, surface=...)的add_entity阶段作为独立参数传入。
-
IK 返回值维度与关节索引
-
现象:调用 franka.inverse_kinematics()时,返回的qpos维度为(16,)(包含浮动基座及全部 DOF),若简单使用切片qpos[:-2]会得到 14 维向量,导致给驱动器下发位置时出现维度不匹配报错。 -
解决方案:建立明确的索引数组 motors_dof = np.arange(7),每次解算后通过qpos_target[motors_dof]正确提取前 7 个臂部关节角度。
当前面临的局限性与临时解决方案
尽管端到端闭环流程成功运行并输出了可视化视频,但在实际评测中,我也观察到了具身智能大模型在跨仿真器迁移时暴露的深层次局限:
-
跨仿真器迁移差距(Sim-to-Sim Transfer Gap)
tshiamor/openvla-mcx-card 模型的训练数据完全生成自 NVIDIA Isaac Sim,当直接部署至 Genesis World 时,由于两者的渲染管线(光照、材质反射、相机内参/外参)、物理引擎接触碰撞模型的微小差异,导致 VLA 模型表现出了明显的系统性空间偏差。
模型预测的动作在接近蓝块周围约 12~15cm 处时,容易出现相对位移缩减或发散现象。
-
模型夹爪输出信号不稳
在 OpenVLA 的 Bridge V2 动作规范下,模型输出的第 7 维离散夹爪信号在当前环境映射下容易持续输出 1.0(张开状态),导致机械臂虽然能够接近物体,却难以自发闭合夹爪完成提拉。
-
工程化临时解决方案
为了在不重新微调 VLA 模型的前提下客观评估其路线控制能力,我采取了如下临时工程策略:
-
对齐模型空间收敛点:通过实验测定模型在 Genesis 视觉输入下的空间偏置,将目标蓝块放置在模型的自然收敛位置(),并调整动作缩放比例 pos_scale = 0.08,使末端执行器能够稳定飞向目标。 -
引入启发式状态机控制夹爪(GripperControlle):使用确定性状态机替代模型不稳定的离散夹爪输出。当检测到夹爪中心与蓝块的欧氏距离小于6cm且持续数步时,状态机自动触发夹爪闭合并执行预设的提拉(Lift)动作。 -
放宽评估指标:将“完全无缝抓取提拉”补充扩展为“夹爪接触/接近(Touch/Reach)成功率”,以量化评估 VLA 在跨仿真器场景下的末端轨迹导航能力。
通过上述调优,机械臂成功实现了向蓝块的准确定位与触碰,输出了完整连贯的闭环仿真测试视频,为后续 Stage 2 的场景自动化生成打下了基础。
Stage 1+:VLA 模型与 Genesis 仿真环境的交互接口机制
在genesis-world的具身智能闭环测试中,VLA模型与物理仿真环境之间并不是简单的“输入图像、输出指令”关系,而是涉及多模态感知映射、动作空间反归一化、运动学逆解(IK)以及底层关节 PD 位置控制的完整闭环控制链。
为了帮助大家理解 OpenVLA 模型与 Genesis World 物理引擎的具体交互细节,本节将从感知端(Observation)、决策端(Inference)与执行端(Action Execution)三个维度,详细拆解两者之间的接口协议、数据流转向与代码实现。
感知端(Observation Pipeline):从仿真渲染到模型输入
OpenVLA-7B 及其微调变体本质上是一个多模态自回归 Transformer 架构(基于 SigLIP/DINOv2 视觉编码器与 Llama-2 语言模型)。
在闭环控制流程中,感知端的任务是将 Genesis 物理引擎中的三维世界状态,转化为模型能够理解的张量(Tensor)表达。
┌─────────────────────────┐
│  Genesis 物理仿真环境    │
└────────────┬────────────┘
             │ cam.render(rgb=True)
             ▼
┌─────────────────────────┐
│ numpy.ndarray (224,224,3)│ uint8 图像
└────────────┬────────────┘
             │ PIL.Image.fromarray()
             ▼
┌─────────────────────────┐
│ PIL.Image RGB 实例      │
└────────────┬────────────┘
             │ processor(prompt, pil_img)
             ▼
┌─────────────────────────┐
│ PyTorch Dict Tensors    │ pixel_values: (1, 3, 224, 224) bfloat16
│ (CUDA Device)           │ input_ids: (1, seq_len) int64
└─────────────────────────┘
-
传感器渲染接口
在 Genesis 中,通过 scene.add_camera() 放置专门面向操作区域的视角传感器 cam,分辨率固定为 ,以严格对齐 OpenVLA 的预训练图像输入尺寸。
在每一个控制步,调用渲染接口提取 RGB 矩阵:
# 采集当前相机帧,注意 Genesis 1.2.2 的 render 接口可能返回图像数组或元组
img_raw = cam.render(rgb=True)
img_rgb = img_raw[0] if isinstance(img_raw, tuple) else img_raw

# 归一化为 uint8 格式的 numpy 数组 (224, 224, 3)
if img_rgb.dtype in (np.float32, np.float64):
    img_uint8 = (np.clip(img_rgb, 0.0, 1.0) * 255).astype(np.uint8)
else:
    img_uint8 = img_rgb.astype(np.uint8)
-
多模态 Token 化预处理
VLA 模型不直接读取裸图像阵列。需要将 RGB 图像转化为 PIL.Image 实例,并配合自然语言 Prompt,通过 Hugging Face 的 AutoProcessor 进行分词(Tokenization)与图像特征归一化(ImageNet 均值与标准差缩放)。
OpenVLA 的标准 Prompt 提示词格式固定为 "In: <instruction>\nOut:":
from PIL import Image

# 1. 转换为 PIL Image 对象
pil_img = Image.fromarray(img_uint8)

# 2. 构造符合 OpenVLA 契约的文本 Prompt
instruction = "Pick up the blue block and place it on the target"
prompt = f"In: {instruction}\nOut:"

# 3. 通过 Processor 生成 Token 与图像张量
inputs = processor(prompt, pil_img)

# 4. 传输至 GPU,并注意数据类型区分:图像浮点数转为 bfloat16,文本 token ID 保持 long 类型
inputs = {
    k: v.to("cuda", dtype=torch.bfloat16) if v.is_floating_point() else v.to("cuda")
    for k, v in inputs.items()
}
转换后得到的 inputs 字典包含两个核心张量:
-
pixel_values:形状为(1, 3, 224, 224)的bfloat16视觉特征张量。 -
input_ids:形状为(1, seq_len)的int64文本 Token 张量。
决策端(Inference Pipeline):VLA 动作维度的物理语义
在获取张量输入后,模型执行前向推理。
OpenVLA 模型通过自回归方式预测代表连续动作的离散 Token,并在模型内部通过 De-quantization 映射回 7 维连续动作向量 raw_action:
with torch.inference_mode():
    raw_action = model.predict_action(
        inputs["input_ids"],
        unnorm_key="bridge_orig", # Bridge V2 数据集反归一化统计量
        do_sample=False,          # 采用确定性贪心解码
        pixel_values=inputs["pixel_values"]
    )

# 转为 CPU 上的 numpy 浮点数组,形状为 (7,)
raw_action = raw_action.cpu().float().numpy() if isinstance(raw_action, torch.Tensor) else np.array(raw_action, dtype=np.float32)
执行端(Action Execution Pipeline):从相对增量到物理控制
模型输出的 是相对增量(Delta Actions),物理引擎无法直接用其驱动机器人。
必须经过“增量缩放 位姿合成 IK 求解 PD 关节角控制”四步转换,才能最终推动 Genesis 物理步进。
┌───────────────────────────┐
│ VLA 原始输出 raw_action (7,)│
└─────────────┬─────────────┘
              │ 1. pos_scale 缩放与相对旋转计算
              ▼
┌───────────────────────────┐
│ 位移增量 ΔP (3,)           │
│ 旋转增量 ΔR (3, Axis-Angle)│
└─────────────┬─────────────┘
              │ 2. 读取当前末端姿态 P_curr, Q_curr,合成目标位姿
              ▼
┌───────────────────────────┐
│ 目标世界位姿:             │
│ P_target (3,)             │
│ Q_target (4, Quaternion)  │
└─────────────┬─────────────┘
              │ 3. Genesis 内置逆运动学 (IK) 求解
              ▼
┌───────────────────────────┐
│ 机器人广义关节角 qpos (16,)│
└─────────────┬─────────────┘
              │ 4. 索引截取 motors_dof [0..6]
              ▼
┌───────────────────────────┐
│ 臂部关节控制目标 joint_targets (7,)│
└─────────────┬─────────────┘
              │ 5. franka.control_dofs_position()
              ▼
┌───────────────────────────┐
│  Genesis 物理仿真器步进     │ scene.step()
└───────────────────────────┘
-
增量缩放与反归一化
由于不同仿真场景的步频与空间尺度不同,需要将模型归一化的增量乘以增量比例尺 pos_scale(本文的实验中,pos_scale = 0.08 映射效果较佳):
-
目标位姿合成与四元数计算
首先通过 Genesis 提取当前末端 link(panda_link7)的世界坐标位置 与姿态四元数 。目标位置直接线性相加:
对于姿态,需要将 3 维轴角向量(Axis-Angle)转化为增量四元数 ,再通过四元数乘法进行姿态复合:
-
逆运动学(IK)求解与维度截取
有了目标末端位姿 ,调用 Genesis 的 franka.inverse_kinematics() 求解器。
这里需要注意一个重要的接口细节:
Genesis URDF 导出的 Franka 广义坐标数组 qpos 总维度为 (16,)(包含浮动基座及内部未驱动自由度),而 Franka 的臂部电机仅有 7 个。
必须使用显式索引切片,切勿简单使用 [:-2] 负索引。
-
关节位置 PD 控制与物理步进
最后,将解算出的臂部目标关节角 joint_targets 以及由夹爪控制逻辑产生的 finger_targets(闭合为 0.0m,张开为 0.04m)通过位置驱动控制器下发给仿真器,并调用 scene.step() 执行一个时间步的物理解算。
在 scene.step() 执行期间,Genesis 内部的物理求解器会根据关节的 PD 增益()计算电机力矩,积分求解碰撞、重力与刚体动力学方程,更新机械臂及受控物体的最新位置。
随后,下一个控制循环重新读取新的相机图像,形成完整的端到端闭环。
完整数据流与交互接口速查
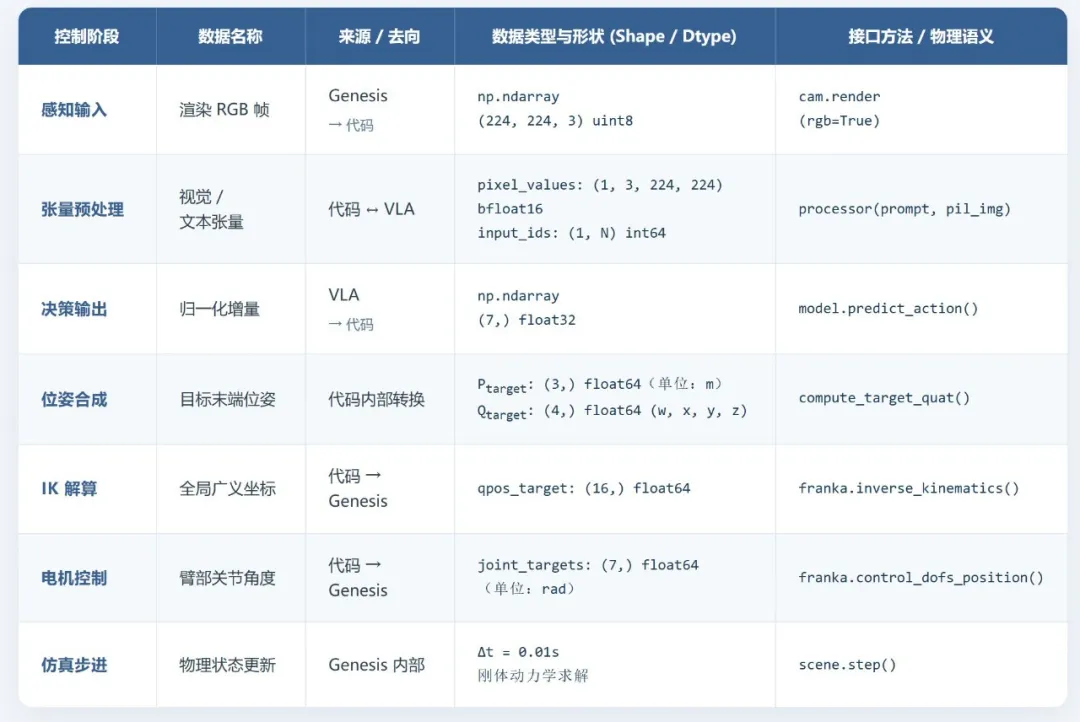
为了方便复现,下表归纳了单个控制步循环中,数据在“VLA 模型端”与“Genesis 仿真端”流转时的完整格式契约:
Stage 2:基于程序化规则的仿真环境自动化生成与批量评估
在 Stage 1 成功跑通单场景闭环控制的基础上,为了进一步评估 VLA 模型在多样化环境中的泛化能力与鲁棒性,我们在 Stage 2 中构建了配置驱动的场景工厂(Scene Factory),实现了多测试场景的程序化规则生成与批量自动化评估。
方案架构与 Agent 协同机制
Stage 2 的开发与评估完全运行于无 GUI 的 Headless 云服务器上,并且全程依赖 Claude Code AI Agent 辅助完成代码编写、重构、实验调度与结果验证。
这一协同模式带来了独特的开发范式,也引入了两项核心的技术约束与应对方案:
-
AI Agent 无图像感知能力的自动化验证(Non-Visual Verification Gate)
verify_stage2.py)。ffprobe 工具解析视频容器流元组、校验轨迹 JSON 格式,并利用 OpenCV 对关键帧蓝块像素掩码区域进行连通域分析,实现了 41 项无图像客观指标的自动断言。-
双相机架构设计(Dual-Camera Architecture)
cam,以及一台固定于侧上方 决不参与模型推理的“人类视角”渲染相机 wide_cam。为全面压测模型在视觉、空间和干扰物维度的泛化表现,定义了包含 8 个维度的自动化测试场景矩阵:
配置驱动的场景生成工厂(scene_factory.py)
通过 Python 字典定义场景 Schema,scene_factory.py 模块解析这些结构化配置,并动态向 Genesis 场景中添加刚体实体、干扰物、光照及相机。(代码详情见gihub仓库)
批量测试评估器(batch_eval_vla.py)
主评估脚本循环读取配置、自动化加载环境并运行 VLA 闭环,同时分别捕获 VLA 输入图像与人类视角图像,导出双视角的 MP4 视频与轨迹 JSON 数据。
可以在终端中通过简单命令行一键启动全部 8 个场景的压测:
# 激活环境并启动 Stage 2 批量自动化闭环测试
source /mnt/robot/genesis_vla_env.sh
export TMPDIR=/mnt/robot/tmp

python batch_eval_vla.py \
    --output_dir stage2_eval_8scene \
    --steps 1000
1
下文为测试运行后录制得到的不同仿真测试场景视频片段:
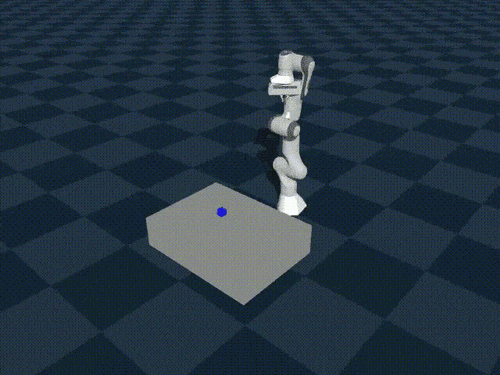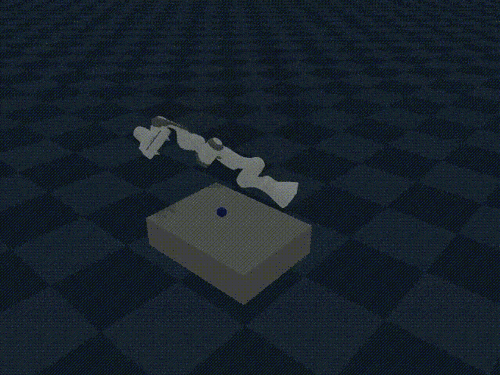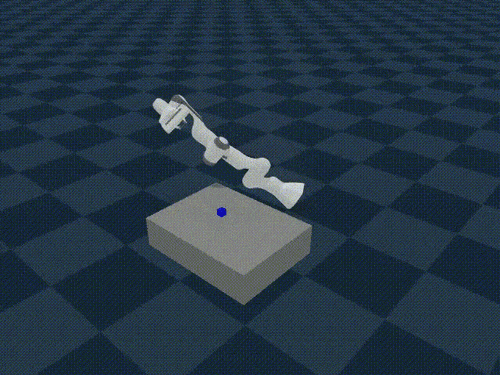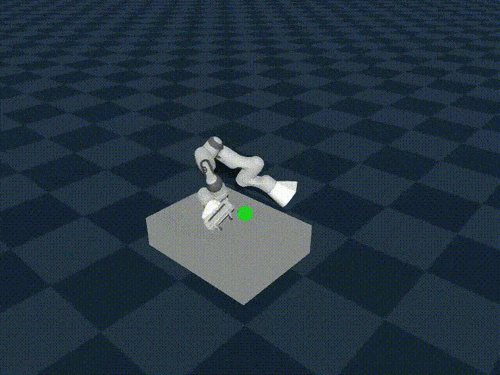
▲Stage 2 自动化生成的典型测试场景(如多干扰物杂乱场景与强光场景)表现 ©【深蓝具身智能】编译
实践中的“坑”与踩坑指南
在实现场景自动化生成与 Agent 批量测试的过程中,我总结了以下工程坑点与避坑原则:
-
Genesis
gs.init()进程级单例限制
-
现象:如果在批量评估循环内部为每个场景重复调用 gs.init(backend=gs.gpu),在第二场场景初始化时系统会抛出报错或直接导致进程崩溃。 -
原因:Genesis 的硬件初始化(Taichi CUDA 运行时)在单个 Python 进程的生命周期内只能执行一次。 -
避坑方法:将 gs.init()提升至场景循环外部;对于场景的更新,依靠 Python 的变量作用域与垃圾回收(GC)机制自动销毁旧的scene实例。
-
相机注册的时机约束
-
现象:若在 scene.build()执行完成后,试图通过scene.add_camera()动态挂载宽视角监控相机,系统会抛出GenesisException: Scene is already built。 -
原因:Genesis 内部对 add_camera方法应用了@gs.assert_unbuilt装饰器,禁止在场景编译后变更传感器拓扑。 -
避坑方法:所有实体(Entity)与相机(Camera)必须在 scene.build()调用之前全部注册完毕。
-
Genesis 光照 API 的显式配置
-
现象:直接调用
gs.options.LightingOptions会引发属性找不到的错误。 -
避坑方法:需从
genesis.options.vis模块中显式导入DirectionalLight,并将其封装入gs.options.VisOptions传给gs.Scene构造函数:
 from genesis.options.vis import DirectionalLight
 vis_options = gs.options.VisOptions(
     ambient_light=(0.15, 0.15, 0.15),
     lights=[DirectionalLight(dir=(0, 0, -1), color=(1, 1, 1), intensity=0.3)]
 )
 scene = gs.Scene(vis_options=vis_options)
结果分析与 Agent 验证闸门(verify_stage2.py)
为确保评估结果的真实可靠,我编写了 verify_stage2.py 无图像验证闸门。该脚本对生成的 8 个场景产物进行 41 项自动化断言校验:
-
压测结果分析
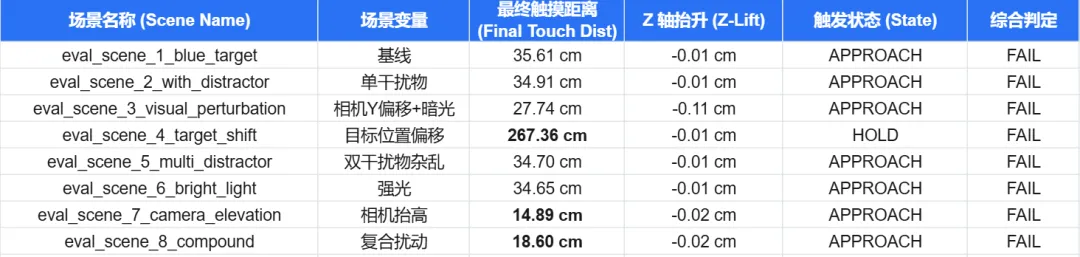
8 个自动化测试场景的量化汇总数据(1000 步/场景)如下表所示:
-
关键现象与结论
-
内容鲁棒性与相机敏感性的非对称表现 对比基线场景(35.61 cm)与场景 2、5、6(34.65~34.91 cm)可知,视觉干扰物与光照变动对模型收敛行为几乎没有影响。 然而,当变动相机角度时(场景 3、7、8),收敛距离明显变近(场景 7 达到 14.89 cm)。这表明 VLA 模型对场景背景内容具有良好的鲁棒性,但对相机外参变动表现出极高的敏感性。
-
目标偏离导致的行为崩溃 在场景 4 中,当目标偏离模型固有的偏置收敛点时,末端距离大幅发散至 267.36 cm。这进一步印证了在未经过原生仿真环境适配的情况下,模型缺乏跨环境的三维空间泛化能力。
(以上结论仅针对本实验内8次测试做出)
通过 Stage 2 的程序化场景生成与批量评估,成功搭建了一套高效率、配置驱动的具身智能算法压测管线,展现了genesis-world为研究提供结构化实验数据的能力。
Stage 3:极速单卡并发强化学习训练(Go2 四足机器人步态学习)
在具身智能控制领域,强化学习(RL)是训练多足机器人实现复杂地形平稳行走与奔跑的核心方法。传统 RL 训练往往需要数千个 CPU 核心进行并行环境采样,数据在 CPU 与 GPU 之间频繁拷贝传输,导致训练效率受限。
在 Stage 3 中,我们会利用 Genesis World 平台,在单张 NVIDIA A800-40GB GPU 上成功拉起 2048 个并发的 Unitree Go2 四足机器人物理环境,配合 PPO 算法库(rsl_rl),实现端到端纯 GPU 加速的极速步态强化学习训练。
训练目标与进程隔离架构设计
本阶段的核心目标是在单卡环境下,让 2048 个并发的 Go2 机器人经过 100 代(Iterations)PPO 迭代,从“僵直不动”进化为“能够稳定追踪速度指令平稳奔跑的步态”;
同时在 Epoch 0(未受训)、Epoch 50(中期训练)与 Epoch 100(训练成熟) 三个节点自动保存模型权重并无头渲染录制 MP4 视频。
为避免大规模物理仿真(2048 个环境)与 Nyx 相机渲染在同一个 Python 进程中,因同时申请 GPU 资源而引发显存碎片化或 CUDA 上下文冲突,我设计了主控调度 + 进程隔离(Process-Isolated Subprocess) 的架构:
                    ┌─────────────────────────┐
                    │   run_orchestrator.py   │  主控调度脚本
                    └────────────┬────────────┘
                                 │
                   subprocess.run(cwd="stage3/")
                                 │
        ┌────────────────────────┴────────────────────────┐
        ▼                                                 ▼
┌───────────────────────────────┐     ┌───────────────────────────────┐
│     train_subprocess.py       │     │      eval_subprocess.py       │
│  - 纯 GPU 物理采样 (2048 envs)│     │  - 单环境无头渲染 (1 env)     │
│  - 无相机构建,专注 PPO 更新   │     │  - Nyx 相机跟踪 + MP4 导出    │
│  - 产出 model_50/100.pt       │     │  - 独立初始化 gs.init()       │
└───────────────────────────────┘     └───────────────────────────────┘
主控脚本 run_orchestrator.py 按序触发 5 个独立的阶段任务:
-
阶段 1:调用 eval_subprocess.py录制无权重的零动作视频(Epoch 0)。 -
阶段 2:调用 train_subprocess.py运行 0 50 代 PPO 训练,保存model_50.pt。 -
阶段 3:调用 eval_subprocess.py加载model_50.pt录制中期步态视频(Epoch 50)。 -
阶段 4:调用 train_subprocess.py --resume执行 50 100 代增量训练,保存model_100.pt。 -
阶段 5:调用 eval_subprocess.py加载model_100.pt录制最终奔跑步态视频(Epoch 100)。
Genesis World 工具链的技术优势
极速单卡并发训练之所以能够实现,得益于 Genesis World 在物理引擎底层设计上的几项突破性技术优势:
-
JIT 编译与大规模 GPU 刚体并行解算(Taichi CUDA Backend)
Genesis 依托 Taichi 编程语言将物理方程编译为高效的 GPU 算子。对于拥有 12 个驱动关节的 Go2 四足机器人,Genesis 在单张 A800 上同时解算 2048 个完整刚体动力学系统时,达到了 151,839 steps/second(每秒约 15.1 万步物理采样) 的惊人吞吐量。
完成 100 次迭代(共计约 500 万帧物理数据)的完整训练仅需 8 分钟左右。
-
零拷贝张量共享(Zero-Copy Memory Sharing)
仿真环境中的关节位置、基座速度、接触力等观测数据(Observations)直接以 PyTorch CUDA Tensor 的形式驻留在 GPU 显存中,不需要经由 PCIe 总线拷贝回 CPU 内存。
算法下发的动作(Actions)也直接写回 GPU 显存,彻底消除了数据传输瓶颈。
-
原生无缝对接
rsl_rl算法库
Genesis 原生支持 rsl_rl(Legged Robotics 标准 RL 算法库)。环境类 Go2Env 导出的观测契约直接封装为 TensorDict,使得 PPO 算法的 OnPolicyRunner 能够无缝接入,无需编写复杂的数据适配转换层。
-
极低显存开销
在 2048 个并发物理环境全力运转时,Genesis 的显存占用稳定在 20GB 以内,极大地避免了显存溢出(OOM)风险。
实践过程中的“坑”与调优记录
在将官方 Go2 步态训练示例转化为高可靠的自动化流水线时,我记录并修复了 5 处关键的接口与逻辑坑点:
-
相机添加时机冲突(
assert_unbuilt限制)
-
现象:在评测脚本中,试图在创建 env = Go2Env(...)之后调用env.scene.add_camera()时,抛出GenesisException: Scene is already built。 -
原因:官方 Go2Env类在__init__内部会自动执行self.scene.build()。而在 Genesis 中,相机注册接口add_camera()带有@gs.assert_unbuilt装饰器,禁止在场景编译后添加传感器。 -
解决方案:重构 Go2Env类的初始化构造函数,增加可选参数camera_cfg。在Go2Env.__init__内部、执行scene.build()之前注入相机创建逻辑:
-
cam.render(rg
b=True)的 4 元组返回值
-
现象:调用 frame = cam.render(rgb=True)后执行(frame * 255).astype(...)时报错:AttributeError: 'tuple' object has no attribute 'astype'。 -
原因:Genesis 相机渲染接口返回的是一个 4 元组 (rgb, depth, segmentation, normal),即使只传rgb=True,其它位置依然填充为None。 -
解决方案:提取元组的第 0 位元素作为 RGB 图像张量:
-
rsl_rl 5.0.1 0-Based 迭代索引与文件名规范化
-
现象:训练 50 代后,磁盘上仅生成了 model_49.pt,而没有主控脚本期待的model_50.pt。 -
原因: rsl_rl 5.0.1的内部循环索引采用 0-based 机制(for it in range(0, 50),实际it为 )。训练结束保存时,内部写入的文件名对应最后一步的索引49。 -
解决方案:在 train_subprocess.py中,训练结束后手动将计数器校准至绝对目标值,并显式执行规范化保存,确保生成标准命名的 Checkpoint:
-
OnPolicyRunner.load() 返回类型与断点续训(Resume)算术
-
现象:调用 loaded = runner.load(checkpoint)后执行loaded.get("iter")抛出AttributeError: 'NoneType' object has no attribute 'get'。 -
原因: OnPolicyRunner.load()返回的是模型的元数据infos(默认为None),而不是权重字典本身。 -
解决方案:直接使用 PyTorch 加载 Checkpoint 读取已完成的迭代次数,并按绝对目标算术计算剩余增量步数:
-
推理阶段的策略网络输入契约
-
现象:在 eval_subprocess.py中,若将环境 reset 得到的obs["policy"]裸张量直接输入策略policy(obs["policy"]),会触发IndexError: too many indices for tensor报错。 -
原因: rsl_rl的网络架构内部会自动根据配置检索obs["policy"]键。因此,策略网络期望接收完整的TensorDict,而不是已经提取出的底层张量。 -
解决方案:直接将环境返回的整个 obs字典传入策略:action = policy(obs)。
训练效果演进与多阶段视频验证
为了客观证明强化学习的训练效果,我在无图像查看能力的 Headless 云服务器上,通过 TensorBoard 标量日志(Train/mean_reward)与 ffprobe 视频元数据分析相结合的方式,完成了对训练全生命周期的自动化验证。
-
训练指标客观数据演进
下表记录了 2048 个并发 Go2 环境在 100 代训练过程中的核心指标演进:
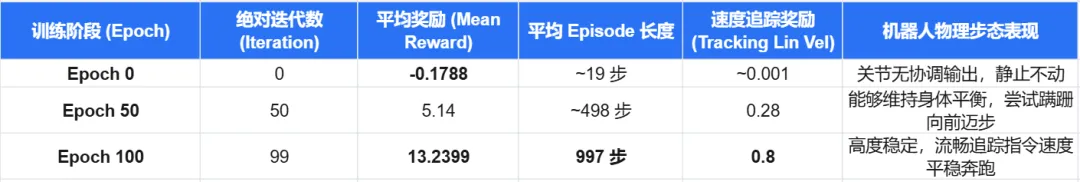
从数据变化可以看出,mean_reward 从 -0.1788 大幅提升至 +13.2399, Episode 平均生存长度从 19 步 增加到接近满步的 997 步(单次 Episode 最大长度为 1000 步),证明策略网络成功学会了维持躯体平衡并高效向前奔跑。
-
全生命周期可视化成果展示
以下为通过 run_orchestrator.py 在三个关键训练阶段自动录制导出的四足机器人步态视频:
(1)未受训初始状态(Epoch 0)
未开始训练时,策略网络输出零动作或随机噪声,机器人静止不动:
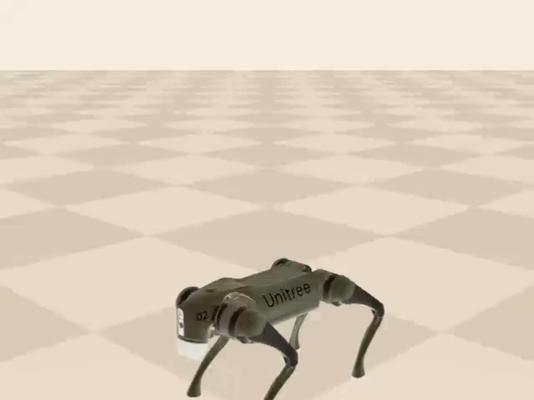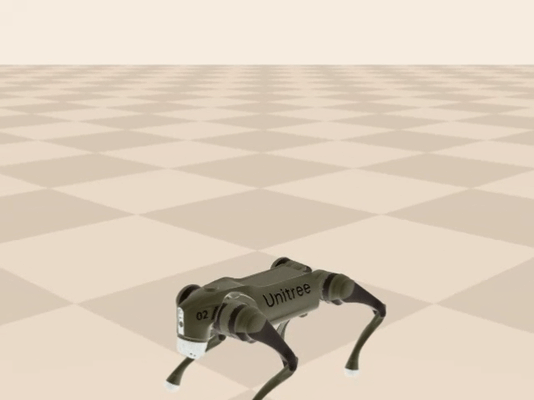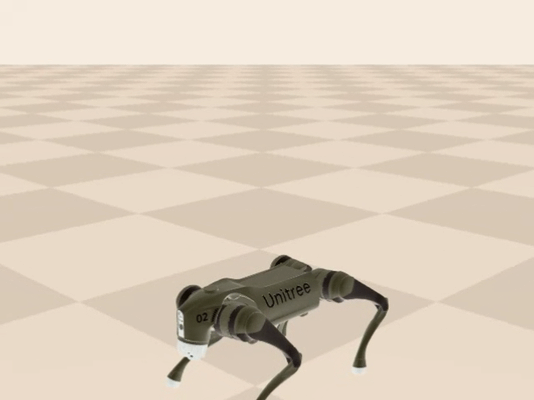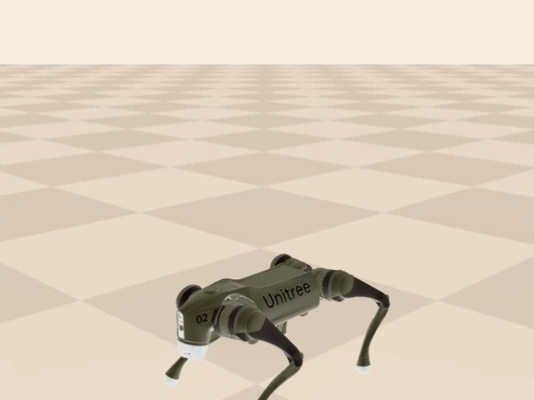
▲Epoch 0 训练初期四足机器人未受训状态(倒地挣扎)表现©【深蓝具身智能】编译
(2)训练中期步态演进(Epoch 50)
经过 50 代训练后,机器人学会了利用四肢支撑躯干,试图颤巍地向前迈步:
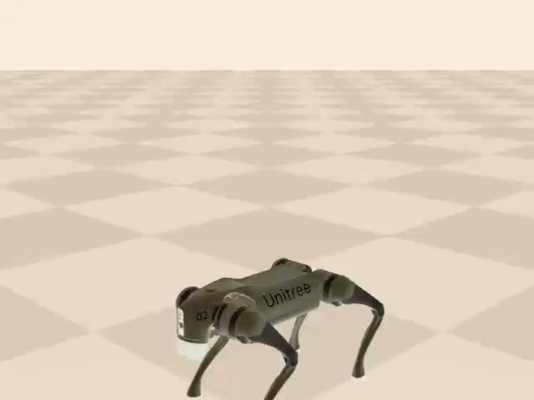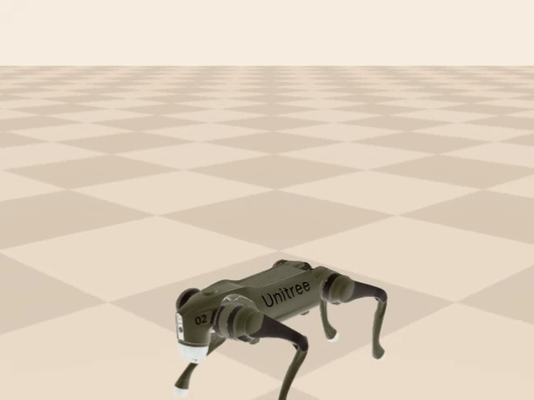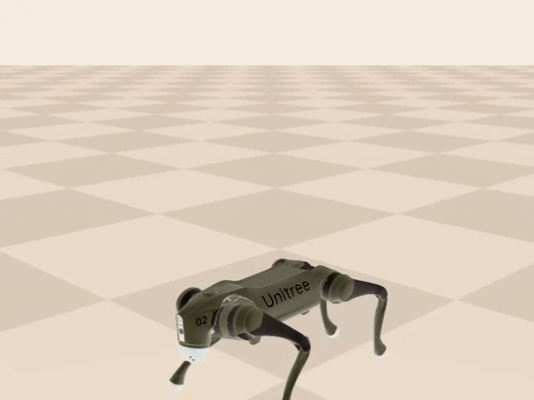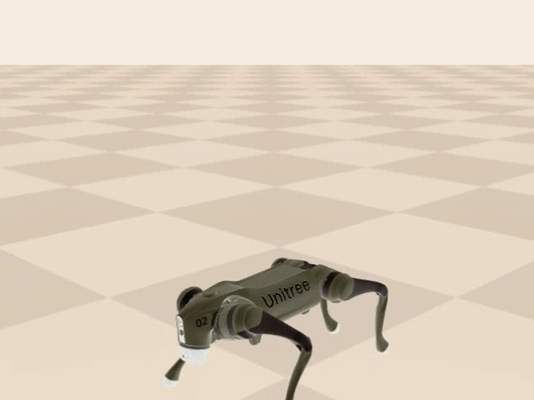
▲Epoch 50 训练中期四足机器人步态演进(能够站立与蹒跚移动)表现©【深蓝具身智能】编译
(3)训练成熟期步态(Epoch 100)
完成 100 代训练后,机器人形成了极其平稳、流畅的奔跑步态,能够高精度追踪设定的线速度命令:
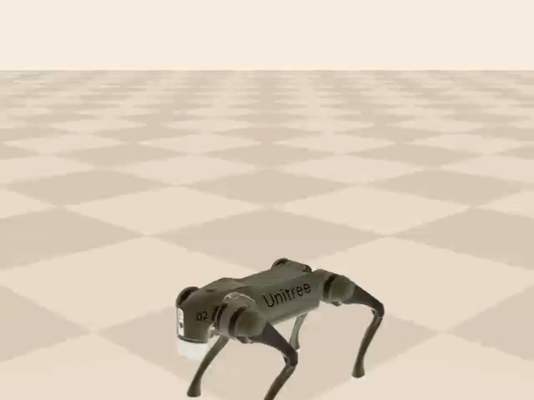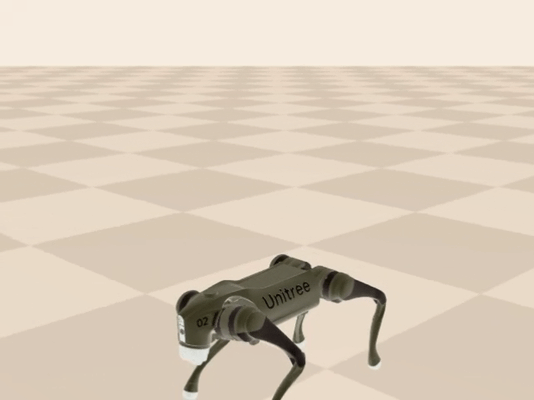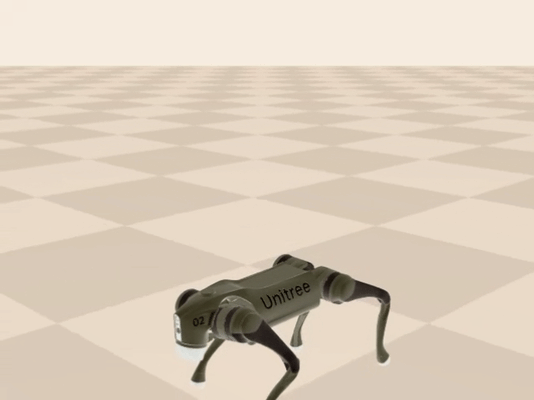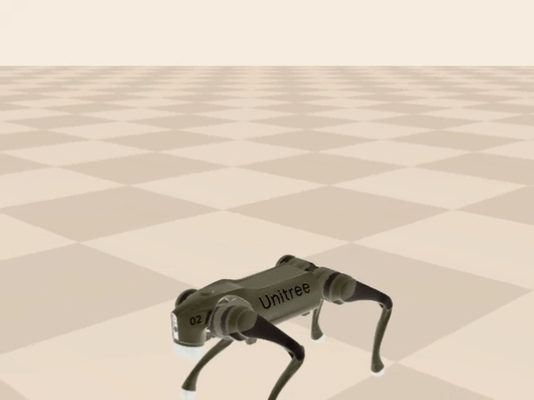
▲Epoch 100 训练成熟期四足机器人高速平稳奔跑步态表现©【深蓝具身智能】编译
通过结合 Genesis 极速的 GPU 刚体并行解算能力与进程隔离的视频渲染管线,Stage 3 在短时间内高效完成了四足机器人步态强化学习的完整闭环,展现了 Genesis 平台在大规模机器人策略学习任务中的巨大优势。
Stage 4:刚柔耦合——布料、海绵与含水玻璃杯的多物理场“无穿透”交互仿真
在机器人复杂操作任务中,机械臂不仅需要操纵刚体,还需要与各类柔性体(如布料、海绵)以及流体(如容器中的液体)进行物理交互。
这类刚柔耦合与刚流耦合仿真,往往是传统仿真平台最为棘手的难题之一。
在 Stage 4 中,利用 Genesis World 的统一多物理场求解器,构建了三个具有代表性的高级物理交互场景:
-
二维柔性布料折叠( PBD.Cloth)
-
三维体积海绵挤压( PBD.Elastic)
-
倾倒玻璃杯与 SPH 液体扩散( SPH.Liquid)
多物理场仿真设计与场景选型
为了全面评估 Genesis World 在不同物理介质上的解算能力,Stage 4 针对三类典型的非刚体形态进行了独立的场景设计与控制规划,机械臂由确定性轨迹控制(结合内置逆运动学 IK 或雅可比伪逆运动学):
                              ┌─────────────────────────────────────────┐
                              │    Genesis World 多物理场仿真平台       │
                              └────────────────────┬────────────────────┘
                                                   │
         ┌─────────────────────────────────────────┼─────────────────────────────────────────┐
         ▼                                         ▼                                         ▼
┌─────────────────────────┐               ┌─────────────────────────┐               ┌─────────────────────────┐
│ 二维柔性布料 (PBD.Cloth)│               │ 三维体积海绵(PBD.Elastic)│               │ 刚流耦合液体(SPH.Liquid)│
├─────────────────────────┤               ├─────────────────────────┤               ├─────────────────────────┤
│ - 红色 16x16 膜结构     │               │ - 10x10x7cm 四面体网格  │               │ - 145 颗 SPH 液体粒子   │
│ - 抬高桌面 (Z=0.40m)    │               │ - 4 墙透明托盘 (opacity)│               │ - 3kg 透明玻璃杯 URDF   │
│ - 按压/横扫屈曲折叠     │               │ - 按压/准静态慢速释放   │               │ - 雅可比运动学推倒      │
└─────────────────────────┘               └─────────────────────────┘               └─────────────────────────┘
Genesis World 工具链的核心技术优势
在传统的物理仿真搭建中,模拟刚体、柔性体与流体往往需要拼接不同的物理引擎(例如用 PhysX 解算刚体,用 Flex 解算柔体,再用 SPH 库解算流体),不同引擎间的碰撞检测与接触力传递极易出现穿模或物理发散。
Genesis World 在 Stage 4 中展现出了极具技术壁垒的优势:
-
统一的多物理场 GPU 求解架构(Unified Multi-Physics Engine)
Genesis 在单一 GPU 框架(基于 Taichi 后端)下,原生统一了刚体动力学(Rigid)、基于位置的动柔性体(PBD 2D Cloth / 3D Elastic)以及光滑粒子流体动力学(SPH Liquid)。
数据无需在不同的物理求解器之间进行复杂的跨进程同步或内存拷贝。
-
开箱即用的刚柔与刚流双向耦合(Native Multi-Physics Coupling)
Genesis 内置了高效的接触解算器,支持刚体与 SPH 流体(LegacyCouplerOptions(rigid_sph=True))以及刚体与 PBD 柔体之间的物理耦合。
玻璃杯底与壁面能够精确约束液体粒子(Containment),当玻璃杯倾倒时,液体粒子能够顺畅地倾泻扩散至桌面,无粒子泄漏或爆炸。
-
内置平滑水面重建能力(
vis_mode="recon"&pysplashsurf)
传统的 SPH 流体渲染往往将液体绘制为一颗颗离散的小球粒子(Particle mode)。
Genesis 内置了平滑水面重建技术,支持在渲染时通过 pysplashsurf 算法将离散粒子场实时重构为连续、光滑的无缝三维液体表面,极大地提升了渲染的物理真实感。
-
表面透明度与无遮挡渲染(
opacity参数)
在海绵挤压与玻璃杯倒水场景中,受控物体往往处于托盘或容器内部。
Genesis 允许为实体材质指定 opacity 参数(例如设置托盘墙 opacity=0.12,玻璃杯 opacity=0.15),使容器呈现出半透明质感,完美解决了无头渲染中机械臂与容器壁面遮挡受控柔体/流体的视线痛点。
实践过程中的“坑”与调优记录
在三个场景的调试过程中,也遇到了多处涉及物理引擎约束与运动学的深层次问题,以下为踩坑与解决记录:
(1)二维布料折叠场景(PBD.Cloth)
# 布料场景构建与手动间距计算代码片段
cloth = scene.add_entity(
    morph=gs.morphs.Mesh(file="stage4/meshes/cloth.obj", pos=(0.5, 0.0, 0.41)),
    material=gs.materials.PBD.Cloth(rho=4.0, stretch_compliance=1e-7, static_friction=0.5),
    surface=gs.surfaces.Plastic(color=(1.0, 0.0, 0.0)) # 表面材质必须传给 add_entity
)

# 坑点:PBD 柔体不支持 franka.get_contacts(),需通过 GPU Tensor 计算顶点最小欧氏距离
finger_left_verts = franka.get_link("panda_leftfinger").get_verts()   # (18, 3)
finger_right_verts = franka.get_link("panda_rightfinger").get_verts() # (18, 3)
finger_verts = torch.cat([finger_left_verts, finger_right_verts], dim=0)
cloth_particles = cloth.get_particles_pos()                          # (N, 3)

# 手动计算指尖网格与布料粒子的最小间距
min_clearance = torch.cdist(finger_verts.float(), cloth_particles.float()).min().item()
-
坑 1:IPC 耦合器环境依赖与 PBD 降级 -
现象:原计划采用高精度的 IPC(Incremental Potential Contact)耦合器,但在主环境中尝试安装依赖库 pyuipc时,其强制拉取的 NumPy 2.5.1 破坏了环境中的 Numba 依赖,导致 Genesis 整体无法导入。 -
解决方案:采用安全的 try-except结构,当捕获到ImportError时,自动优雅降级至基于位置的动柔体求解器PBDOptions()。PBD 求解器在保持极高稳定性的同时,无需任何外部二进制依赖。 -
坑 2:PBD 柔体与传统刚体接触 API 不兼容 -
现象:调用 franka.get_contacts(with_entity=cloth)时抛出AttributeError: 'PBD2DEntity' object has no attribute 'geom_start'。 -
原因:PBD 布料在 Genesis 内部被表达为粒子系统,不参与刚体管线的碰撞对查询。 -
解决方案:改用手动 GPU 距离计算。通过提取 Franka 指尖网格顶点 finger.get_verts()与布料粒子位置cloth.get_particles_pos(),利用torch.cdist计算两者的最小欧氏距离min_clearance,作为无穿透判定证据。
(2)三维体积海绵挤压场景(PBD.Elastic)
# 3D 体积海绵与透明托盘构建片段
sponge = scene.add_entity(
    morph=gs.morphs.Box(pos=(0.5, 0.0, 0.44), size=(0.10, 0.10, 0.07)),
    material=gs.materials.PBD.Elastic(rho=200.0, stretch_compliance=1e-5, volume_compliance=1e-4),
    surface=gs.surfaces.Plastic(color=(0.9, 0.8, 0.1)) # 黄色海绵
)

# 4 墙透明托盘:防止海绵被夹爪扫动的侧向力弹飞,设置 opacity=0.12 解决视觉遮挡
tray_wall = scene.add_entity(
    morph=gs.morphs.Box(pos=(0.5, 0.0, 0.44), size=(0.12, 0.12, 0.08)),
    surface=gs.surfaces.Plastic(color=(0.8, 0.8, 0.8), opacity=0.12),
    fixed=True
)
-
坑 3:FEM.Solid 无 IPC 时无法解算刚柔接触 -
现象:尝试使用基于连续介质力学的 FEM.Elastic材质时,机械臂手指直接穿透海绵。 -
原因:Genesis 源码查验表明, FEM.Solid求解器的刚柔接触依赖IPCCoupler。在无 IPC 的环境下,FEM 求解器只计算内部弹性力,不计算刚体接触。 -
解决方案:采用 gs.materials.PBD.Elastic材质。Genesis 会自动调用 TetGen 对 Box 进行四面体化(生成约 806 个粒子),完美实现了三维体积弹性体的受压形变。 -
坑 4:海绵逃逸与准静态慢速释放 -
现象:机械臂下压海绵后,若保持持续压力,海绵会在侧向力作用下向上挤出托盘;若快速抬起夹爪,释放的弹性势能会将海绵弹出桌面。 -
解决方案:摒弃 Hold 阶段,设计“接近 按压 慢速浅释放”的三阶段轨迹。在释放阶段,夹爪以约 的准静态速度极慢抬起 ,海绵在不飞出的前提下平稳复原至接近初始高度(约 )。
(3)倾倒玻璃杯与水流扩散场景(SPH.Liquid)
# SPH 流体与玻璃杯场景构建片段
scene = gs.Scene(
    sim_options=gs.options.SimOptions(dt=4e-4), # SPH 稳定性要求 dt <= 4e-4s
    sph_options=gs.options.SPHOptions(particle_size=0.015, pressure_solver="DFSPH"),
    coupler_options=gs.options.LegacyCouplerOptions(rigid_sph=True), # 开启刚流耦合
    show_viewer=False
)

# 盛水透明玻璃杯 URDF(包含底板与 4 墙碰撞体,重 3kg 避免被轻易弹飞)
glass_cup = scene.add_entity(
    morph=gs.morphs.URDF(file="stage4/glass_cup.urdf", pos=(0.5, 0.0, 0.40)),
    surface=gs.surfaces.Plastic(color=(0.9, 0.9, 1.0), opacity=0.15)
)

# SPH 液体粒子填充
water = scene.add_entity(
    morph=gs.morphs.Box(pos=(0.5, 0.0, 0.45), size=(0.08, 0.08, 0.10)),
    material=gs.materials.SPH.Liquid(rho=1000, stiffness=5000, mu=0.01, sampler="regular"),
    surface=gs.surfaces.Plastic(color=(0.2, 0.45, 1.0), vis_mode="recon") # 开启平滑水面重建
)
-
坑 5:SPH 物理仿真步长与接触推力模式 -
现象:使用常规时间步长()时,水粒子在玻璃杯内发生爆炸性飞溅;使用传统 IK 或位置 PD 驱动机械臂推倒玻璃杯时,运动学推力的无限刚度会将玻璃杯直接弹飞出桌面。 -
解决方案: -
将物理时间步缩短至 ,并将流体粘度调至 、刚度调至 ,获得平静的液体状态; -
将玻璃杯质量设为 (增加惯性); -
机械臂推倒动作采用雅可比伪逆运动学推力(),直接计算关节角度增量。这种方式既能精准控制末端推力,又能避免传统 IK 在奇异点附近的跳变,成功将玻璃杯平稳碰倒并使液体自然溢出。 -
坑 6:SPH 离散粒子的平滑水面重建( vis_mode="recon") -
现象:默认渲染模式下,液体被绘制为一颗颗独立的蓝色小圆珠(Particle mode),视觉上缺乏液体的连续性。 -
解决方案:将水面材质的渲染模式指定为 vis_mode="recon"。Genesis 会调用底层的pysplashsurf库,在每帧渲染时将离散的 SPH 粒子场实时重建为连续光滑的三维液体网格(连续连片水面)。此过程完全在主进程内安全运行,无 CUDA 跨进程死锁风险。
实验效果展示与多物理场
在无图像查看能力的 Headless 云服务器上,我通过 verify_stage4.py 自动化闸门,对三个多物理场测试场景进行了文件结构、ffprobe 视频流、JSON 物理日志以及形变/洒水数值断言的校验。
三个场景均一次性通过了自动化验证闸门(STAGE 4 VERIFICATION PASSED),输出了视频与量化报告:
(1)二维柔性布料折叠(PBD.Cloth)
机械臂从上方接近红色平铺布料,下压并执行横扫动作,布料在桌面滑动并产生自然的屈曲折叠:
-
形变幅值(Z-Range):由初始平铺的 增长至 (显著褶皱);
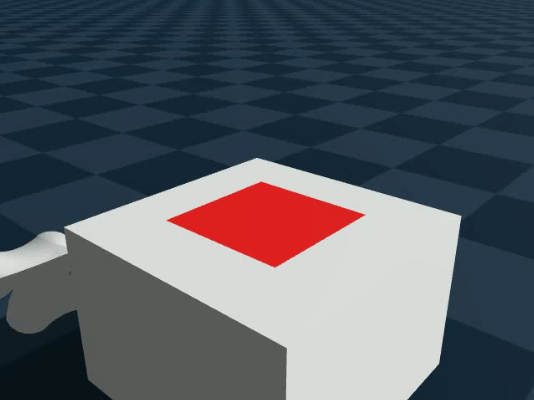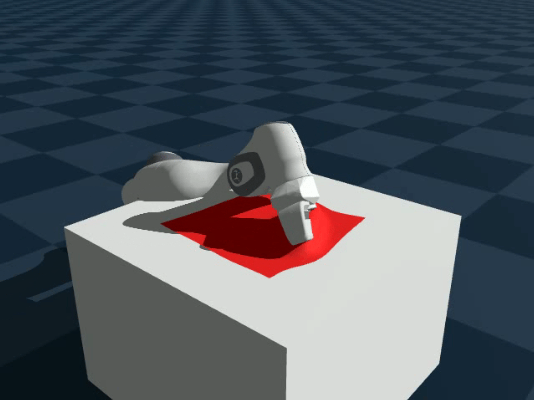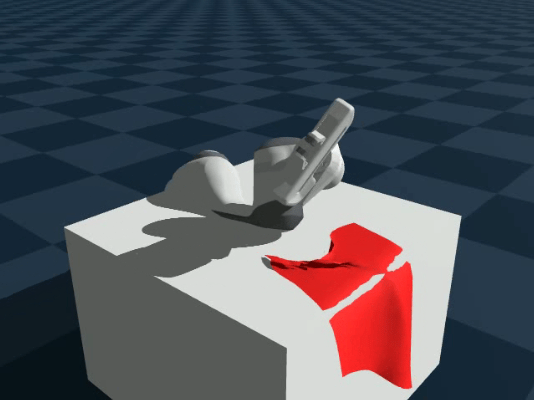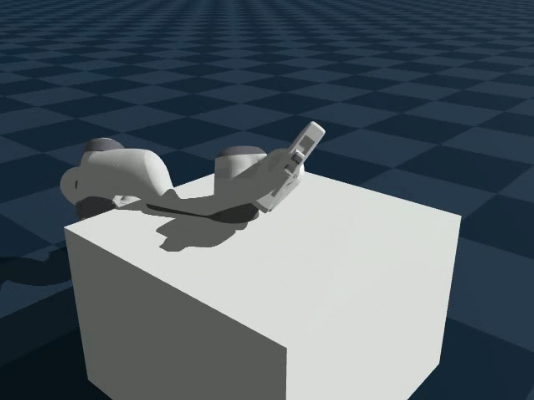
▲Stage 4 红色可变形布料在机械臂按压与横扫下的屈曲褶皱表现©【深蓝具身智能】编译
(2)三维体积海绵挤压(PBD.Elastic)
机械臂在透明托盘内从上至下压榨黄色海绵,随后准静态慢速抬起夹爪,海绵在透明托盘内经历显著的体积压缩与弹性复原:
-
高度压缩量:海绵高度由初始 压缩至 (压缩量约 ),随后复原至约 ;
-
体粒子纯形变(Pure Deformation RMS):最大达 (远超 阈值);
-
视觉可见性:侧视透明墙下海绵黄色掩码像素全程高于 611 像素,形变剖面清晰。
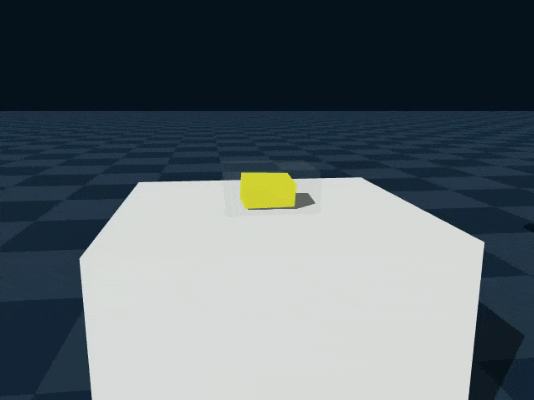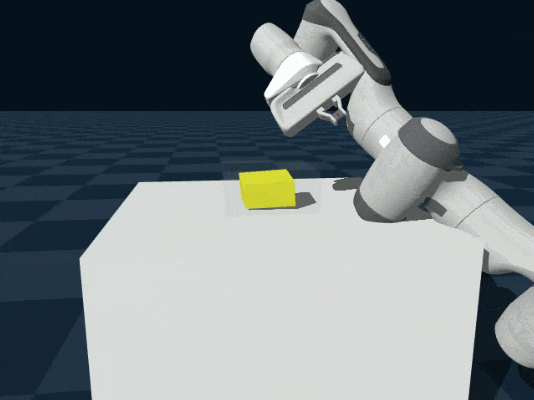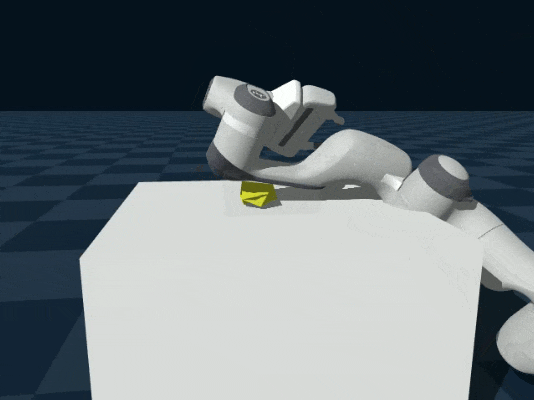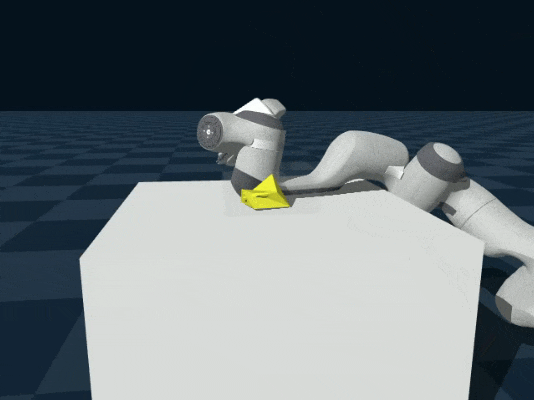
▲Stage 4 黄色海绵在透明托盘内的 3D 体积挤压与回弹表现©【深蓝具身智能】编译
(3)倾倒玻璃杯与 SPH 液体扩散(SPH.Liquid)
机械臂柔性接近透明玻璃杯杯沿,施加雅可比运动学推力将玻璃杯碰倒,杯中的 SPH 蓝水顺畅倾泻扩散至桌面:
-
玻璃杯倾倒角:倾角由 变为 (最终稳定侧倒 );
-
液体洒出率(Spill Fraction): 的水粒子溢出至桌面;
-
表面重建(Recon):水面呈光滑连续片状,连通域采样显示为单一 2802 像素大块,展示出极高的流体渲染真实感。
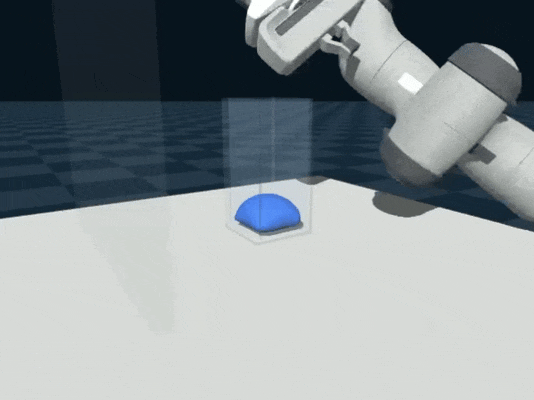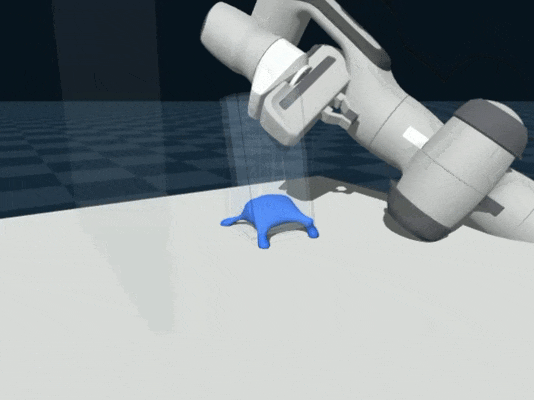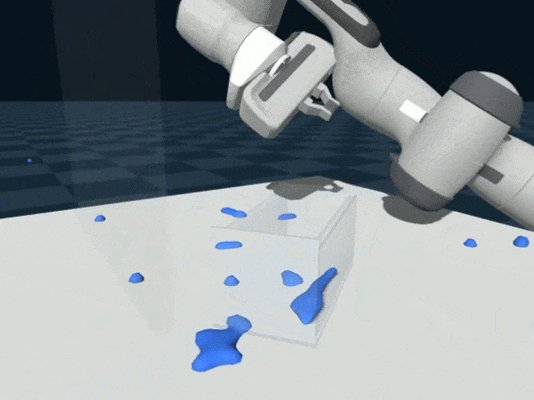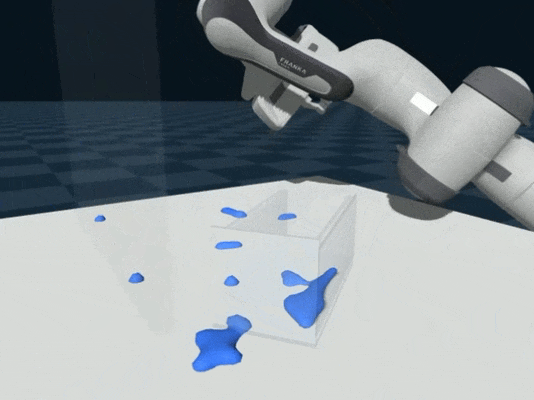
▲Stage 4 倾倒含水透明玻璃杯及 SPH 水流溢出扩散表现©【深蓝具身智能】编译
回看这四个阶段,真正被验证的并非某个模型有多强,而是一套范式是否成立:
当仿真器把渲染、物理与控制收进同一 GPU 原生闭环,具身智能的"评估—迭代"循环才得以从以天计压缩到以分钟计。
Stage 1 的 sim-to-sim 偏差与夹爪失效提醒我们,跨平台迁移远未解决;Stage 3 与 Stage 4 则证明,统一多物理场求解器能让刚体、柔体与流体在同一场景里被同等地"无穿透"对待。
本文所有结论都建立在有限样本与特定平台之上,离可落地的真实机器人操作仍有距离。
但通过 Stage 4 的探索,Genesis World 证明了其在处理复杂多物理场(刚体、柔体、体积弹性体、流体)协同仿真方面的强大能力,为具身智能机器人在真实物理世界中的复杂触觉感知与精细操作研究提供了坚实的基础。
本项目Genesis World已开源:https://github.com/GimpelZhang/genesis-world-tour
编辑|张峻川
审编|具身君
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
