

JEPA世界模型不只有稠密潜变量,稀疏编码可以让动力学建模更简单
——小网络也能学好预测
近日,图灵奖得主Yann LeCun团队又一篇JEPA方向工作LpWM发布。过去绝大多数JEPA类世界模型,例如LeWM,都依靠匹配各向同性高斯分布,学习稠密非零潜表征。
这套方案能很好避免表征坍缩,但一直缺少一个答案:稠密表征是不是建模动力学最优的潜空间几何?
LpWM给出了另一条路线:使用RDMReg整流分布匹配正则,训练得到非负稀疏编码。
理论层面证明,足够高维one‑hot独热稀疏表征可以用条件线性动力学逼近非线性Lipschitz动力学;在PushT机器人操作任务上,中等复杂度规划器下,相比稠密基线LeWM规划成功率最高提升57%。
同时学到的稀疏编码具备模式分解特性:激活的特征集合代表离散动力学模式,特征幅值代表模式内部连续状态,把黑盒潜空间拆开一部分,得到可解释结构。
这套工作证明稀疏表征是世界模型一条值得重视的备选路径。
JEPA世界模型的固有两难:稠密表征是不是最优解
现在主流JEPA类具身世界模型,以LeWM为代表,依靠SIGReg将编码器输出对齐各向同性高斯,产出全部维度几乎非零的稠密潜表征。
稠密方案确实解决了表征坍缩,但是工程上会遇到两个现实痛点。
第一,稠密潜空间的动力学本身复杂度高,想要做好规划,必须用容量很大的预测器。如果把预测器做小、变简单,规划成功率就会断崖下跌,嵌入式机器人硬件上部署压力大。
第二,稠密表征几乎全部维度参与编码,很难区分哪一部分对应环境的离散动力学切换、哪一部分对应连续状态变化,潜向量整体接近黑盒,可解释性很差。
此前理论已经知道,one‑hot独热编码可以把非线性动力学转化为潜空间的线性转移。但完全one‑hot在现实训练不可行,维度爆炸,无法落地。
LpWM的出发点就是用分布式稀疏编码作为one‑hot的工程松弛版本,保留稀疏的优势,避开独热编码的现实缺陷。
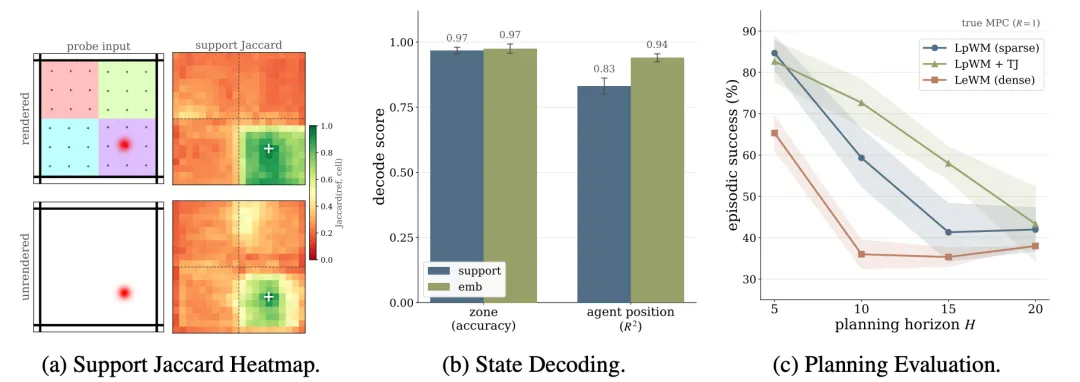
▲图 | 稀疏支撑集合恢复动力学分段结构、状态解码、规划评估结果©深蓝具身智能编译
现有相关工作分为三类:
-
稠密JEPA(LeWM、VICReg‑JEPA)
训练稳定,防止坍缩成熟;但是动力学学习压力全部压给预测器,小模型很难学好,潜空间可解读能力弱。
-
离散/类别世界模型(DreamerV2)
使用离散隐变量,具备稀疏特性;但是离散单元固定,缺少连续幅值表达,灵活性受限。
-
早期稀疏正则世界模型
大多聚焦于降低激活值,没有研究稀疏几何对动力学建模难度本身带来的改变,也没有观察模式分解现象。
LpWM核心要解决的问题是:稀疏能不能降低预测器需要的模型容量,同时得到具备可分解结构的潜表征?
LpWM完整方案:RDMReg正则+分布式稀疏JEPA
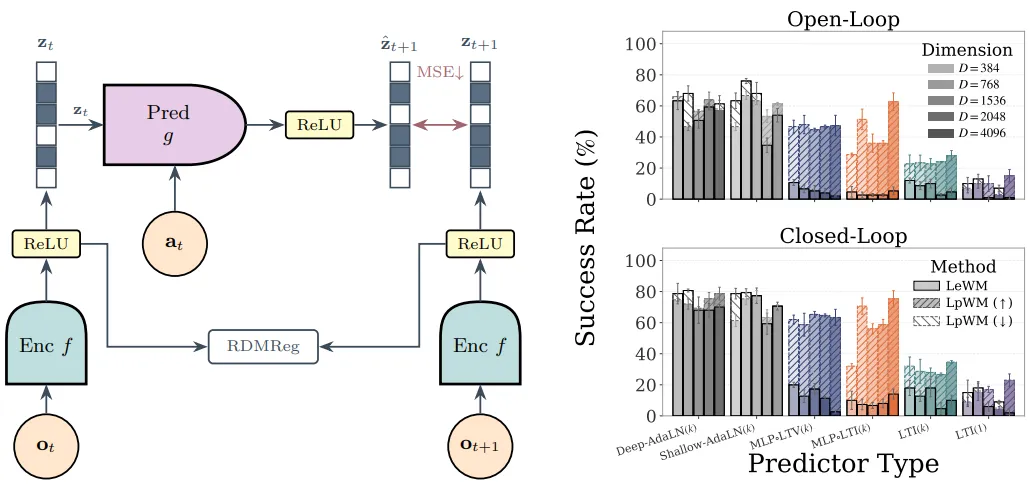
整套LpWM建立在JEPA联合嵌入预测架构之上,核心改动是把SIGReg稠密高斯正则替换为RDMReg整流分布匹配正则,产出非负稀疏编码,搭配RepReLU重参数化ReLU算子,得到大量维度严格等于0的潜向量。
损失函数主体依旧是JEPA预测损失,最小化预测潜向量与编码器真值潜向量距离,额外增加RDMReg正则项。
公式总损失:
第一项为JEPA潜态预测损失;第二项RDMReg为整流分布匹配正则,是正则权重超参。
RDMReg核心逻辑:
对潜向量做大量随机单位球面投影,把投影后的一维分布对齐整流广义高斯分布(RGG)。研究默认参数(p=1),对应整流拉普拉斯分布,天然鼓励大量维度置零,实现稀疏。
RepReLU算子用于前向产生精确零值,反向传播借用GeLU梯度,缓解死亡ReLU,它属于训练优化保障,不是方法必不可少组件。
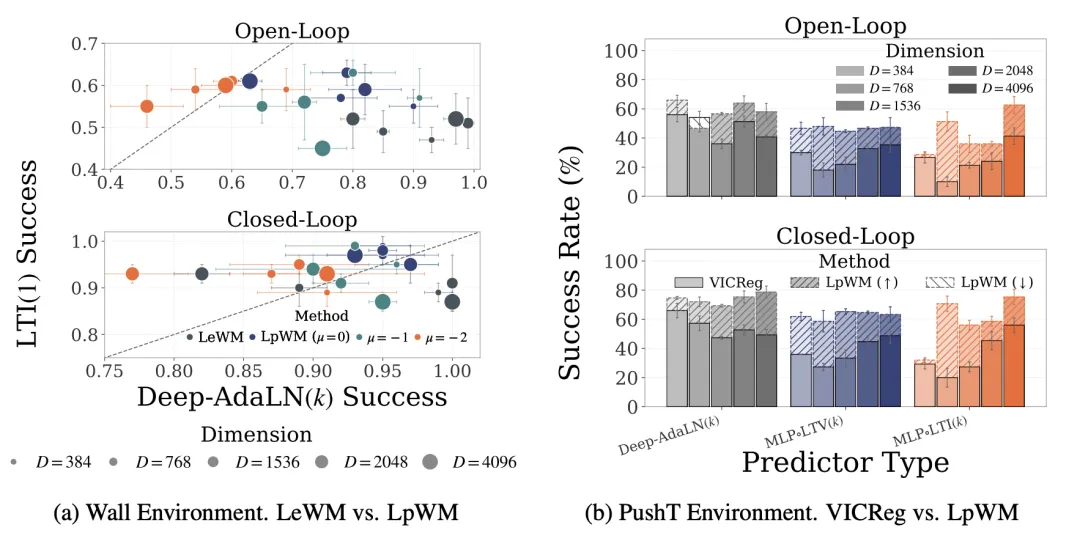
▲图 | 不同环境下多模型对比结果©深蓝具身智能编译
理论动机:高维稀疏可将非线性动力学近似线性化
紧致状态空间上满足Lipschitz条件的受控非线性动力学,存在足够高维one‑hot编码器,使得潜空间内可以用动作条件线性转移矩阵逼近真实动力学,并且随着维度升高,单步推演误差趋于0。
如果状态被映射到one‑hot独热编码,复杂非线性物理,在潜空间就变成简单的矩阵乘法。
但是真正one‑hot需要极高维度,现实不可实现,于是退一步,采用分布式稀疏编码作为折中。
不过该理论是渐近性质,不是说现实有限维稀疏潜空间就一定变成纯线性,只是动力学会被简化,让低能力预测器更容易拟合。
实验设计:一套预测器复杂度阶梯做对照
研究设计了一套从高能力Transformer到纯线性LTI的预测器阶梯,用来验证稀疏能不能降低预测器的能力门槛:
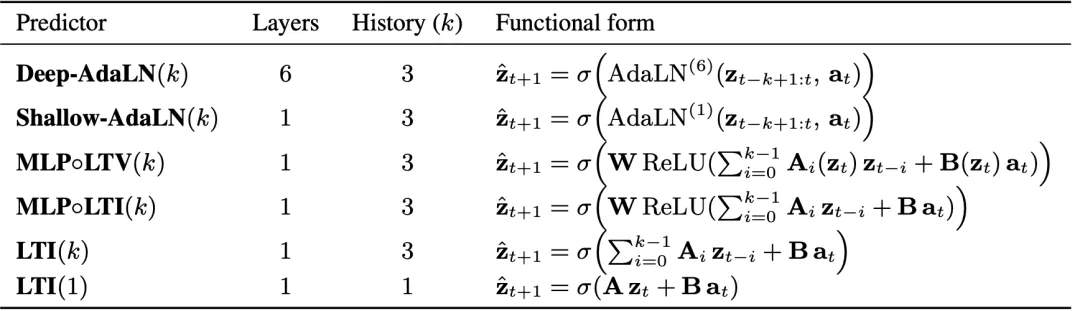
▲表 | 具备不同复杂度层级的预测器配置表©深蓝具身智能编译
包含Deep‑AdaLN(k)、Shallow‑AdaLN(k)、MLP◦LTV(k)、MLP◦LTI(k)、LTI(k)、LTI(1)。
从6层Transformer一路降到单步无历史的纯线性模型。同时在D={384,768,1536,2048,4096}多种潜向量维度上对比LpWM(稀疏)与LeWM、VICReg‑JEPA(稠密)。
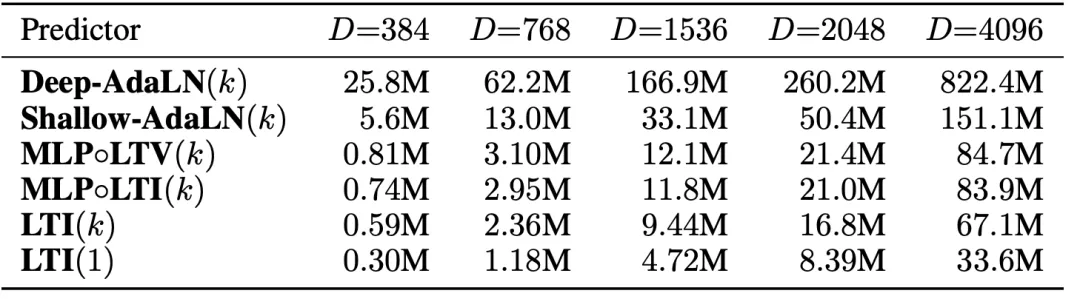
▲表 | 不同潜维度下各预测器参数量统计表©深蓝具身智能编译
简单的LTI系列预测器参数量只有几百K级别,远低于Deep‑AdaLN的几十到几百兆,更贴近嵌入式设备现实约束。
-
两套仿真环境实验差异
Wall环境:简单导航场景:
哪怕最简单的LTI(1)线性预测器,稠密、稀疏方案规划成功率都接近满分。环境动力学足够简单,稠密表征下线性模型也能搞定,稀疏带来的增益体现不出来。
PushT推方块环境(更贴近真实机器人操作):
高容量Deep‑AdaLN(k)预测器,稠密LeWM和LpWM性能接近,大模型能力足够掩盖表征几何差异;
-
差距集中在中等容量预测器区间
MLP◦LTI、MLP◦LTV、LTI(k)上,LpWM规划成功率相比稠密LeWM最高提升57%。但是当预测器降到最弱LTI(1),不管稀疏稠密,两者效果都很差。
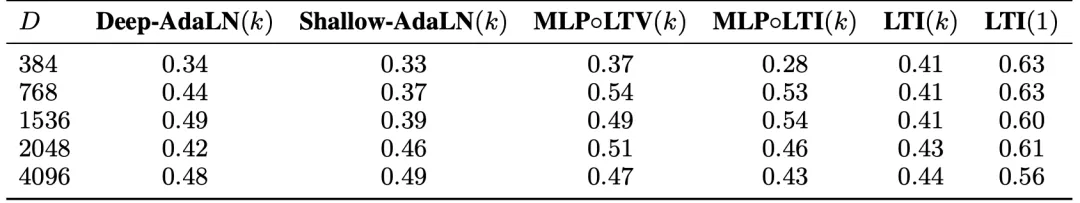
▲表 | 不同预测器、潜维度下LpWM编码的非零占比统计表©深蓝具身智能编译
稀疏的收益不是无条件:只有当任务动力学复杂度和预测器能力处于中间区间,稀疏表征收益最大。
预测器能力极强,稠密也能学好;预测器能力太弱,哪怕稀疏也解决不了问题。
研究也明确指出该边界,不要把结果泛化为“稀疏一定全面碾压稠密JEPA”。
同时消融对比VICReg作为稠密基线,LpWM依旧全面占优,证明收益不是对比SIGReg特例,是稀疏表征本身带来。
统计验证,LpWM特征保持30‑65%非零,确实是分布式稀疏,不是全零或者接近one‑hot。
可解释发现:模式分解(mode‑factored)稀疏表征
LpWM学到的稀疏编码出现很有意思的模式分解现象:
-
潜向量哪些维度激活(支撑集合support),编码离散动力学模式/区域;
-
激活维度上面的数值大小,编码该模式内部的连续状态。
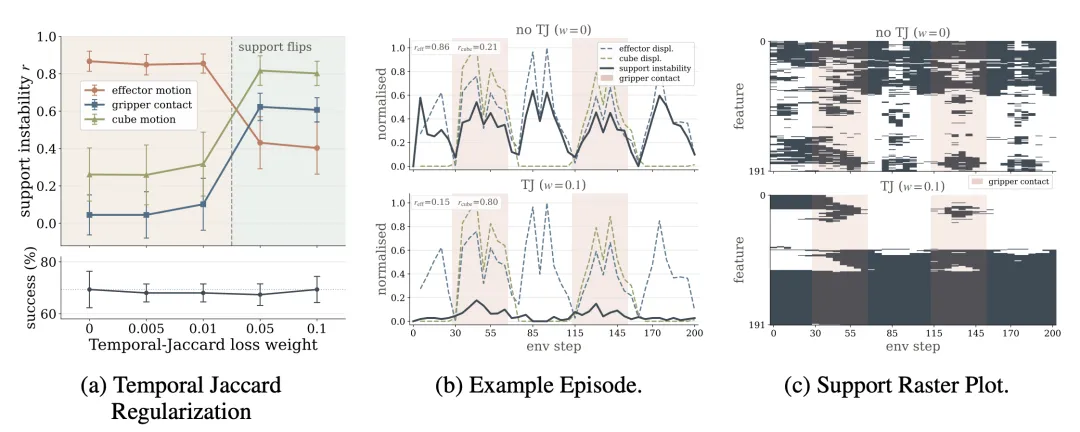
▲图 | 时间雅卡尔正则消融、片段示例、支撑集光栅可视化©深蓝具身智能编译
Piecewise仿真环境,空间被划分多个动力学区域,不同区域受力场不一样。
热力图显示,同一区域内部,支撑集合Jaccard相似度很高,跨区域边界相似度骤降。只用二进制的激活/不激活信息,就可以近乎完美解码所在动力学区域;而位置等连续状态,需要依靠特征幅值。
但是原生RDMReg只约束单帧分布,没有时序约束。在OGBench‑Cube接触操作任务发现,不加额外约束时,稀疏支撑集会跟着末端执行器快速抖动,而不是跟随物体接触这种真正的动力学切换事件。
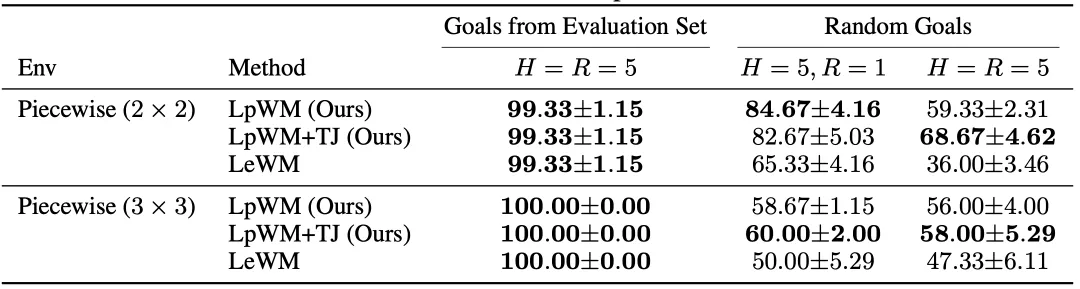
▲表 | Piecewise环境不同分区配置下成功率统计表©深蓝具身智能编译
研究提出了可选项时序Jaccard(TJ)损失,惩罚相邻帧支撑集合剧烈跳变。调高TJ权重之后,支撑集的变化不再跟随机械手运动,转而对齐方块接触、分离这类物理事件。
TJ是附加损失,不是LpWM本体组件。原生LpWM稀疏不会自动对齐有物理意义的时间事件,需要额外时序先验引导,这点是该方法的一处短板。
开放研究方向
LpWM抛出了一个值得思考问题:做世界模型,我们是否一定要追求稠密高斯潜表征?
论文从理论命题出发,证明高维one‑hot稀疏编码可以简化动力学,然后提出LpWM,依靠RDMReg正则得到分布式稀疏JEPA世界模型。
在中等预测器容量区间,PushT任务规划成功率最大提升57%,同时观察到模式分解可解释潜结构。
LpWM并非能够全面碾压稠密JEPA,而是开辟出稀疏表征这条有价值的探索分支。
它的增益高度依赖任务复杂度与预测器容量的匹配区间,不能无条件泛化到全部具身AI任务。
同时研究指出了一些待解决的问题,例如
时序正则怎么设计,才能让稀疏支撑集合自动对齐真实物理事件,不用人工调TJ权重;
稀疏表征在真实物理机器人上的sim2real迁移表现;
在更大规模数据集、更多样的具身任务上,完成稀疏与稠密JEPA的系统性对比。
编辑|小小怪博士
审编|具身君
Ref
LpWM: A Case for Sparse Representations in World Models
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
