

在仿真中使用VR采集的数据,可以作为真实世界灵巧操作策略的有效预训练来源
——低成本数据获取
在机器人灵巧操作赛道,绝大多数预训练成果都建立在简单平行夹爪之上。多指灵巧手受限于实体遥操作成本高昂,而互联网人类手部视频又存在本体形态差异、动作重定向噪声大等问题,很难拿到大规模、本体对齐的高质量训练数据。
斯坦福与MIT联合提出SPD(Simulation Pre‑training for Dexterity),探索一套以VR虚拟遥操作为核心的预训练范式:
操作员在VR内直接操控和真机完全一致的虚拟双手机器人,一周时间产出75小时多任务接触交互仿真数据;
基于这份数据预训练扩散Transformer策略,仅投入1‑2小时真机演示微调,就在5项真实双手灵巧任务中,全面超越从零开始训练的行为克隆基线。
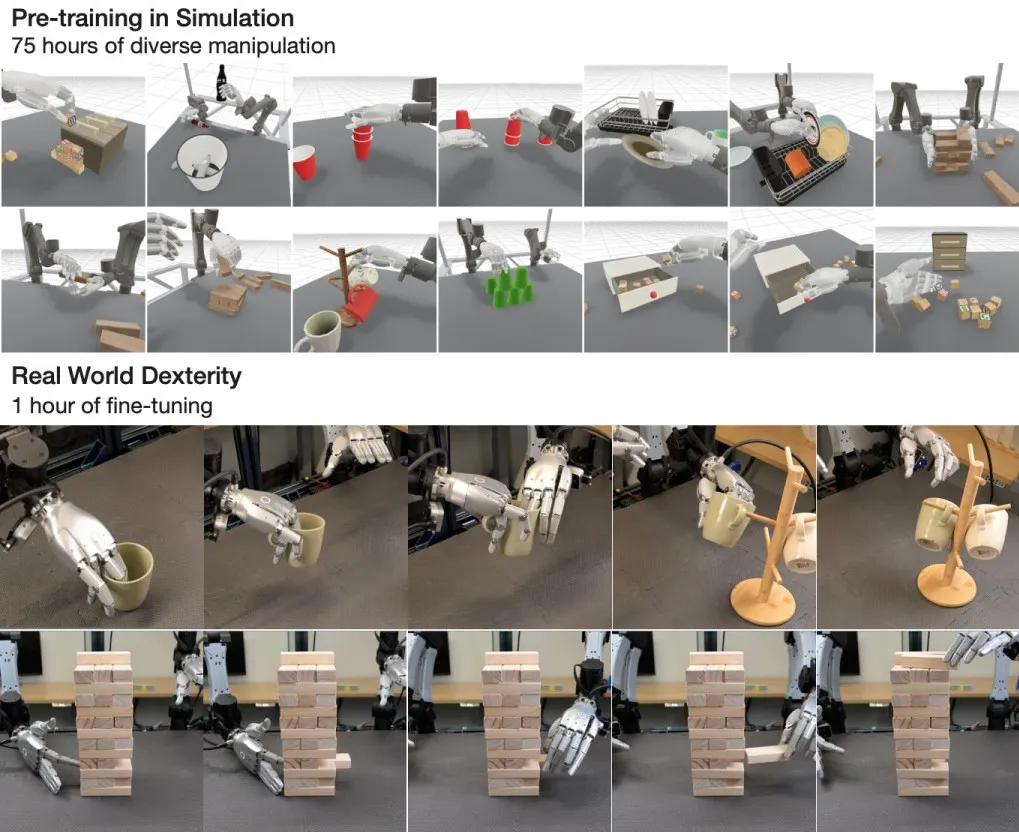
▲图 | 灵巧性仿真预训练:上方为75小时遥操作仿真数据,覆盖6种场景、数百个物体实例,包含大量接触型底层灵巧行为;下方为经过预训练的策略,仅使用1小时真实演示即可适配图中真实世界灵巧任务。©深蓝具身智能编译
这项工作验证了VR仿真遥操作可以成为灵巧手预训练的有效数据来源。
同时团队开源整套spd‑vr遥操作工具、spd‑75h数据集与调优完成的仿真场景,给后续灵巧手基础模型研究提供可复用的公开底座。
双系统协同:从VR仿真采集到真机微调落地
整套SPD框架由两套遥操作系统构成:spd‑vr负责产出仿真预训练大数据,spd‑teleop专门采集现实世界微调样本;
模型层面选用因果滑动窗口扩散‑Transformer作为核心策略。
spd‑vr:低成本规模化仿真数据生产管线
操作员通过Meta Quest3接入MuJoCo仿真环境。仿真以480Hz步进运行,头显以60Hz回传手腕、指尖位姿,依靠逆运动学驱动虚拟双臂与灵巧手;为减少视觉遮挡,机器人手臂设置为半透明渲染。
数据集覆盖积木拼写、餐具、马克杯等6类仿真场景。每一轮任务重置时,系统会随机化任务目标、物体资产、物理属性与摆放位置。5名操作员在一周内累计产出1930个episode,合计75小时操作数据。
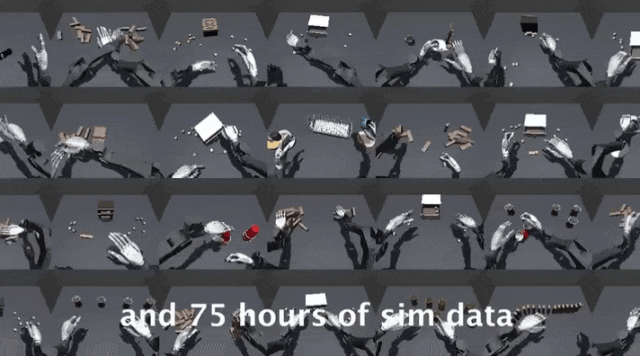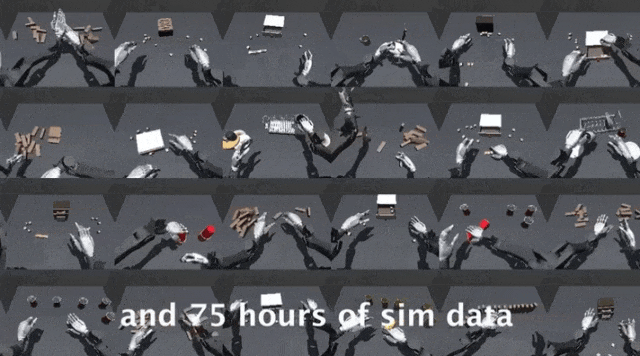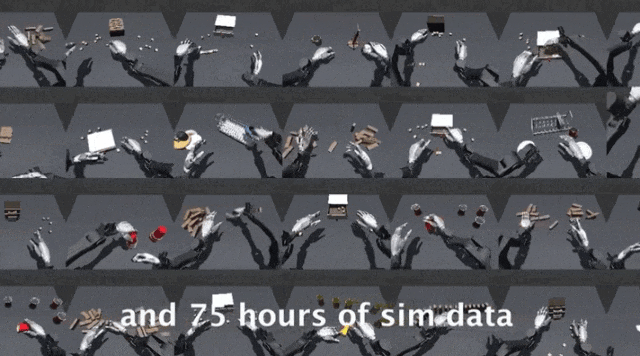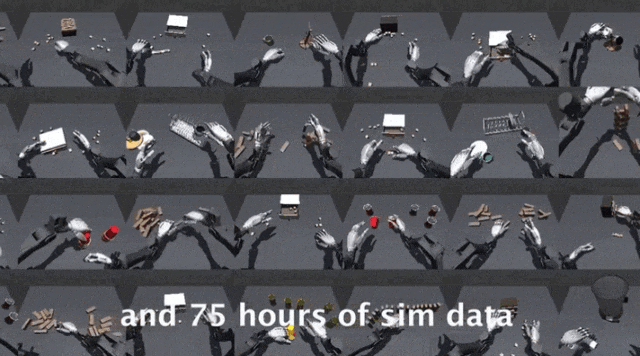
任务只给定最终目标,不约束中间操作步骤,同一任务会生成大量差异化操作路径,丰富交互行为的多样性。
数据完成采集后,过滤掉长时间无物体接触的无效片段,借助Madrona渲染器并行做画面渲染。
为提升视觉泛化能力,在GPU侧执行两类增强:随机修改物体色彩、桌面纹理;执行镜像对称增强,交换双臂同时翻转图像、本体感知与动作序列。
spd‑teleop:适配真机环境的遥操作方案
真机硬件采用两台升级后的YAM Pro机械臂,每台机械臂搭载22‑DoF Sharpa Wave灵巧手;为缓解高负载带来的电机过热问题,对部分关节电机齿轮比完成升级。
感知配置三台RealSense D405相机,包含1台顶部全局相机、2台手腕侧相机。
真机遥操作不再复用VR头显手部跟踪,改用Manus动捕手套捕捉手指运动,Quest控制器获取手腕位姿。
这套组合输出轨迹更加平滑稳定,能够应对真机场景下远距离作业、视觉遮挡等现实问题。采集得到的真机数据用于下游任务微调,单任务采集时长控制在44‑121分钟区间。
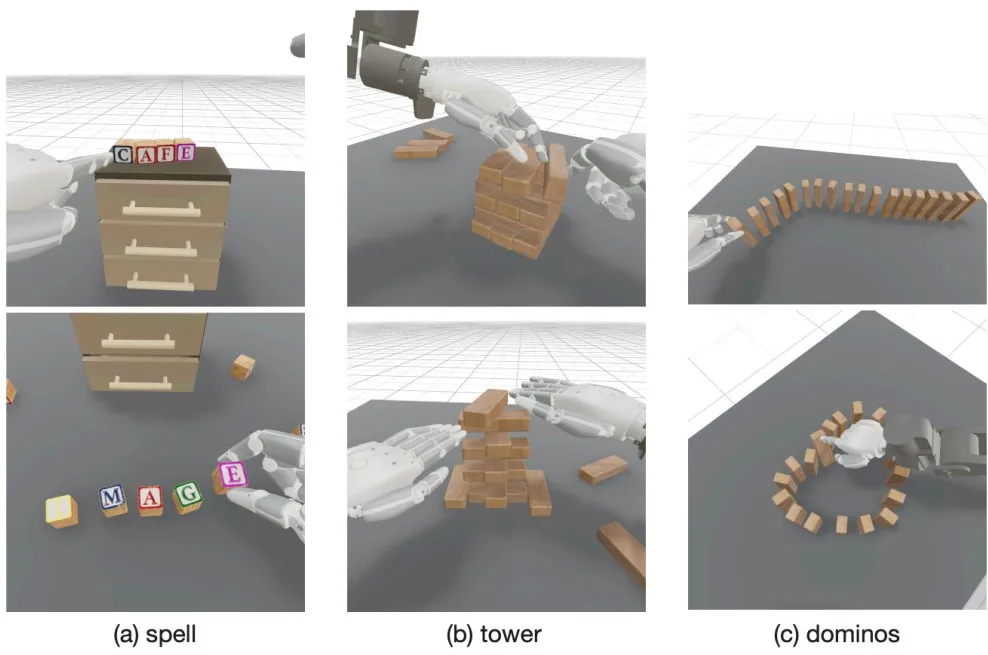
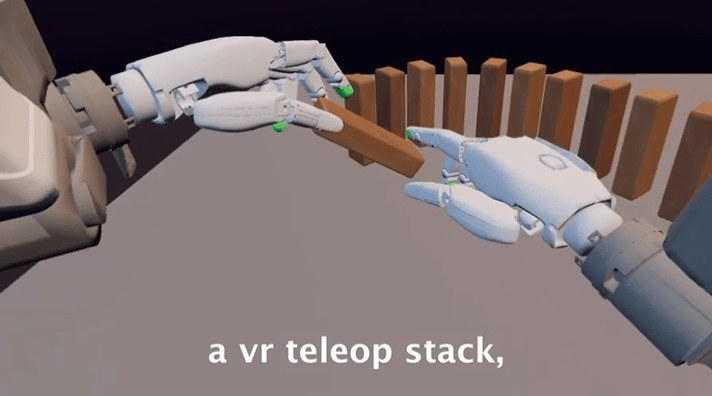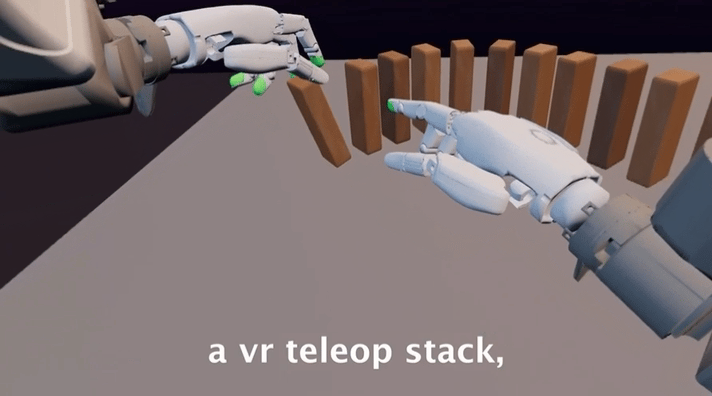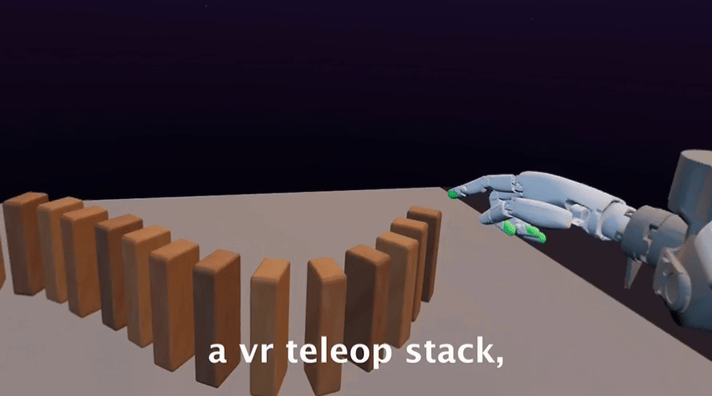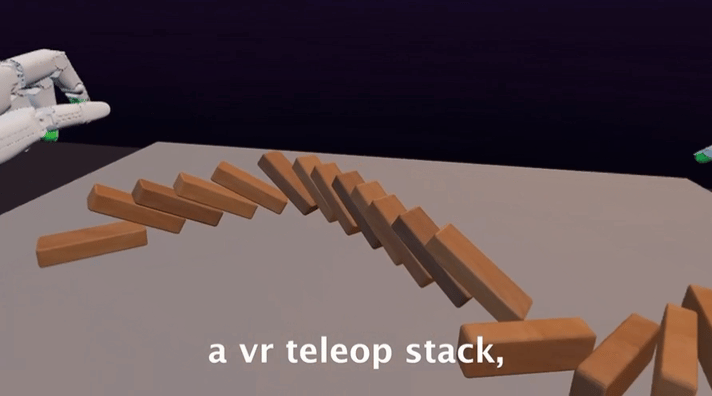
图 | 开放式仿真任务上操作员的多样策略:每组帧对展示同一长时序任务下同一批操作员产出的两种不同策略;(a)使用字母块拼写出目标单词,(b)堆叠积木搭建叠叠乐塔,(c)把骨牌摆成链条。©深蓝具身智能编译
适配灵巧交互的扩散‑Transformer策略
预训练数据包含大量接触级灵巧原语,任务分布多元,因此选用扩散Transformer建模多模态动作分布。
受限于数据集缺少文本标注,模型放弃语言条件,仅依靠视觉+本体感知历史作为输入条件。
模型输入由本体感知、动作、图像token、带噪声动作块交织组成。训练序列长度256步,采样频率30Hz;在因果掩码约束下,并行完成全部动作块去噪,提升训练效率。视觉端使用冻结DINOv3 ViT‑B/16编码器,依靠可学习query压缩图像特征,同时每两个Transformer块重新做交叉注意力回原始图像patch,保留精细视觉信息;为减少帧间信息冗余,图像输入每8步做一次降采样。
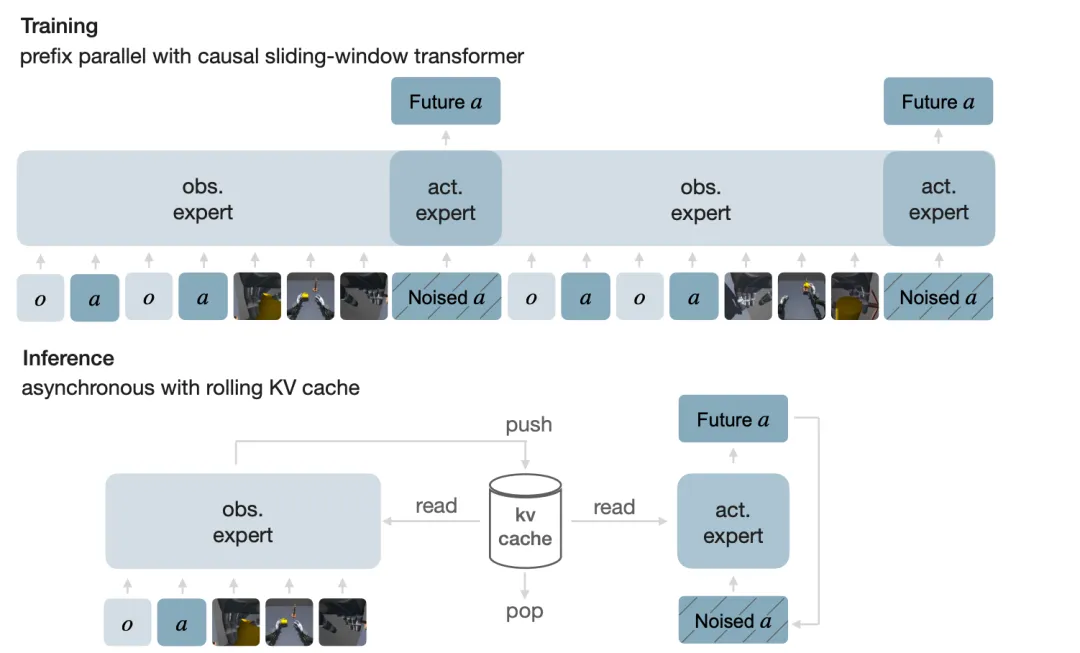
图3 | 策略架构:策略为扩散Transformer,输入本体感知(o)、动作(a)、多视角图像以及加噪动作块交织token序列。训练阶段采用因果掩码并行对全部动作块去噪;推理阶段搭配滚动KV缓存实现异步推理。©深蓝具身智能编译
全部注意力采用因果约束,RoPE旋转编码注入时序信息;滑动窗口注意力窗口固定32时间步,推理时配套滚动KV缓存,兼顾长时序上下文能力与真机部署推理速度。动作去噪分支使用独立权重,优化器选用Muon,推理采用EMA权重。训练时对本体感知、动作加入高斯噪声,提升对观测扰动的鲁棒性。
推理阶段使用增量推演,在块边界积分流ODE输出后续8步动作。
关键实验洞察:预训练红利,受模型配置约束
实验选取盘子上架、马克杯悬挂、叠叠乐游戏、杯子堆叠、瓶子投箱五项真实双手灵巧任务。测试物体和仿真数据集物体相似,但并非完全一致。
对照组使用完全相同网络结构,仅依靠真机演示从零训练行为克隆(BC)。每个测试点执行20次试验,统计任务完成进度与训练损失。
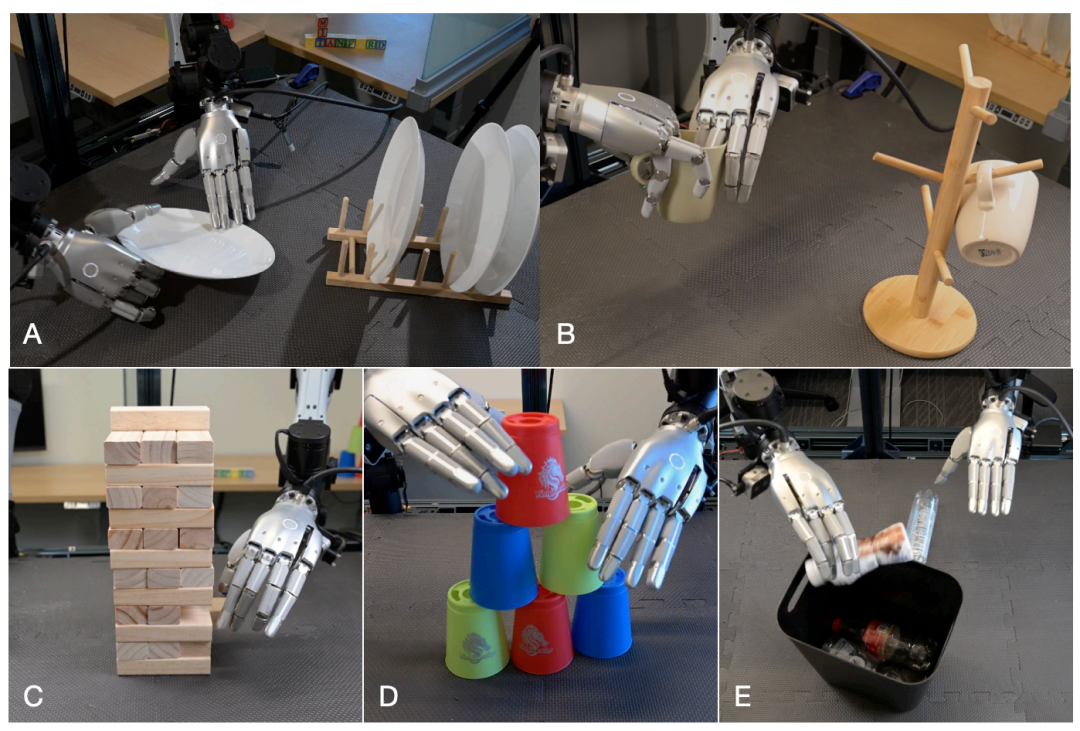
图4 | 五项任务自主执行结果:(A)盘子上架:抓取盘子放到盘架;(B)马克杯悬挂:双手交接后将马克杯挂到杯架;(C)叠叠乐游戏:一只手推出积木,另一只手取出堆叠到塔顶;(D)杯子堆叠:拆分嵌套杯子搭建金字塔;(E)向箱子内投掷瓶子。©深蓝具身智能编译
从结果可以看到,经过SPD仿真预训练再微调的模型,五项任务的完成进度全部优于从零训练的基线,训练损失也可以侧面印证预训练带来的初始化优势。
仿真预训练提供灵巧操作先验,并非实现sim‑to‑real零样本迁移,仍然需要1‑2小时真机演示微调;
如果现实物体和仿真差异过大,预训练带来的性能增益会快速衰减。
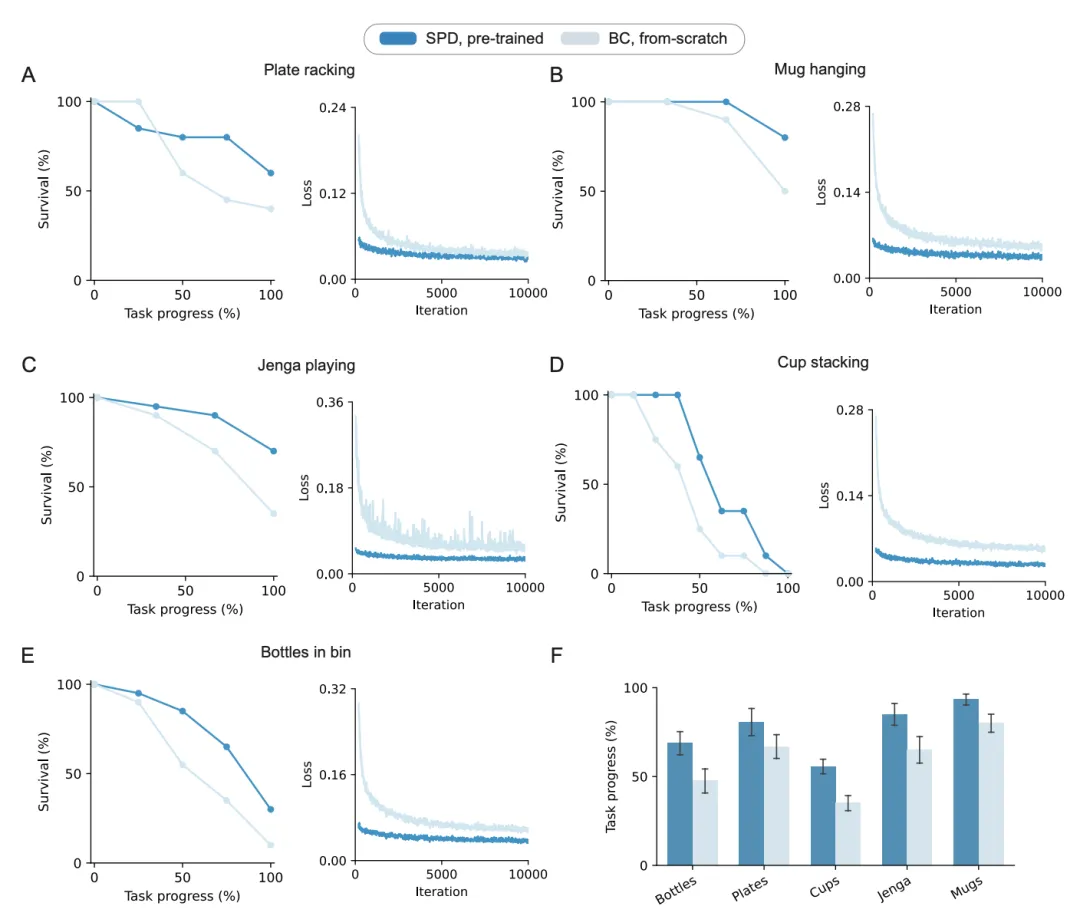
图5 | 仿真预训练提升真实世界灵巧能力:在真实机器人上评估五项双手灵巧任务,对比SPD预训练检查点和从零训练BC基线。(A‑E)展示能够到达各个操作阶段的试验占比以及训练损失曲线,(F)展示平均任务进度;误差棒代表标准误差。©深蓝具身智能编译
消融实验:时序窗口与动作块的组合魔法
研究设置了一组极具工程参考价值的消融实验,滑动窗口w取{1,32},动作块尺寸c取{8,32},四组配置分别执行「SPD预训练+微调」、「从零训练」两套流程。
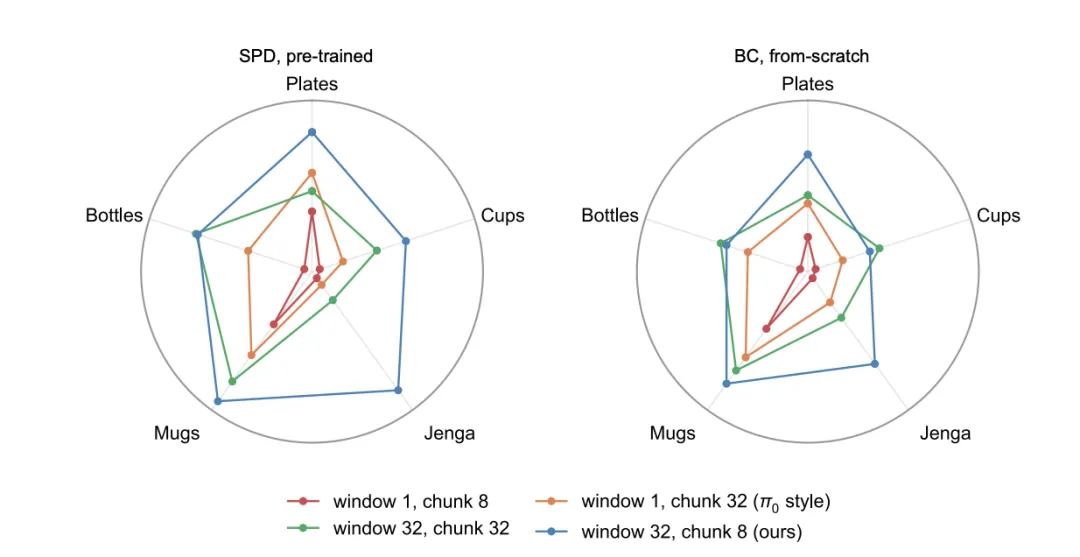
图6 | 历史条件与块大小消融实验:表1各项变体的平均任务进度可视化;左侧SPD预训练,右侧从零BC训练。©深蓝具身智能编译
实验现象很明确:只使用单帧上下文(w=1),动作块缩小到8步时策略输出剧烈抖动,时序连贯性直接失效。
当开启32步历史窗口之后,短动作块c=8成为最优配置:长窗口保障时序连贯性,小块尺寸带来高反应灵敏度。该配置下SPD预训练对比从零训练,平均任务进度提升18个百分点;其余配置增益普遍不足3%。
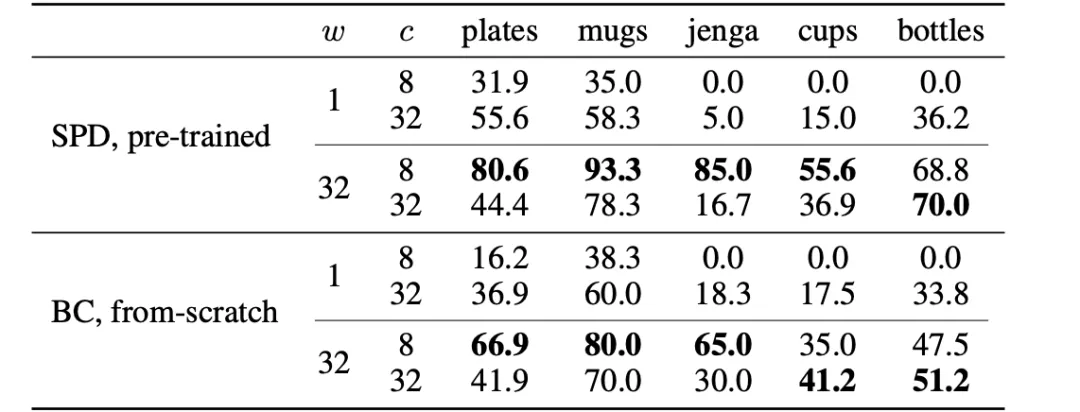
表1 | 全部变体的平均任务进度:每一种滑动窗口(w)、动作块(c)组合下的任务进度百分比;每个训练模式内每个任务最优值加粗,w=32、c=8为本论文选用配置。©深蓝具身智能编译
这揭示一个容易被忽略的现实:拿到大规模仿真数据不等于就可以吃满预训练收益,必须匹配合理的时序窗口,模型才能消化仿真中学到的长时序接触交互知识。
写在最后
数据匮乏一直是制约多指灵巧手向前推进的核心阻碍。
真机采集贵、网上人手视频本体不匹配,SPD提供了折中可行思路:把操作员放进VR虚拟世界,直接操控虚拟的目标机器人本体,快速构建大规模多任务灵巧交互数据集。
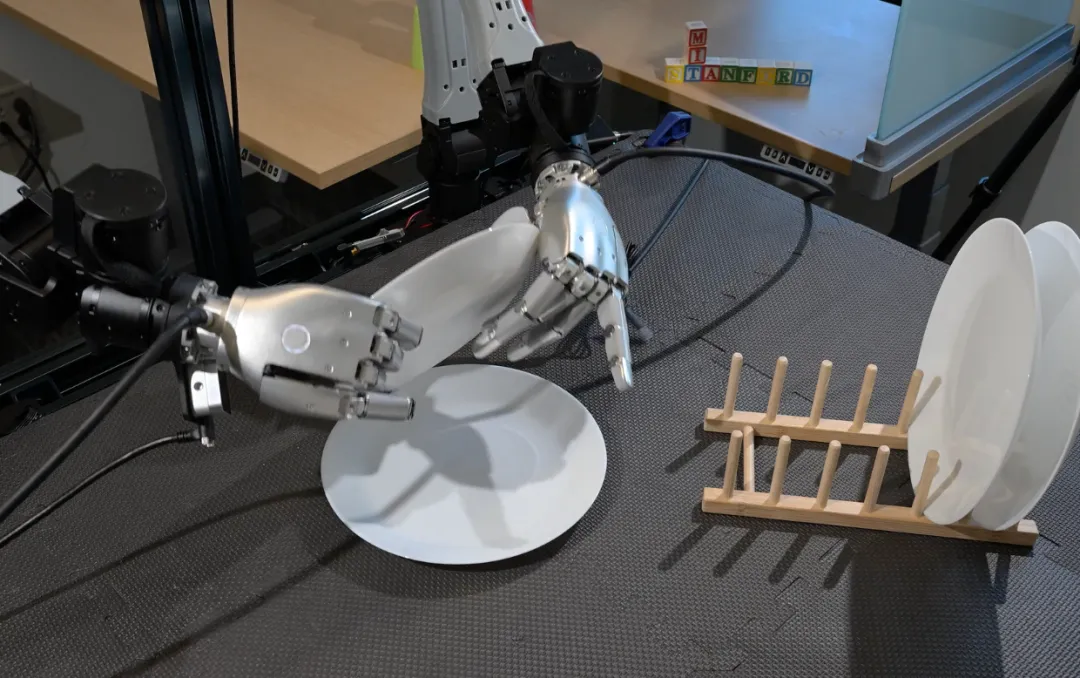
75小时仿真预训练之后,搭配1‑2小时真机微调,就在5项双手灵巧任务上显著优于从零训练基线。消融实验也给到非常务实的工程启示:大规模数据只是基础,模型时序结构配置不合理,预训练的收益会被直接锁死。
当然SPD并没有彻底抹平仿真现实鸿沟,仿真物理的保真度依旧是这套方案能力天花板。但不可否认,它为灵巧手基础模型开辟了低成本的数据获取范式。
编辑|小小怪博士
审编|具身君
Ref
论文标题:Pre‑training Visual Dexterity in Simulation
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
