

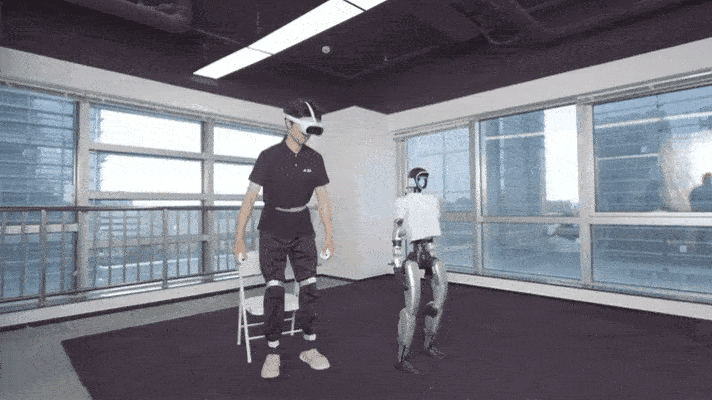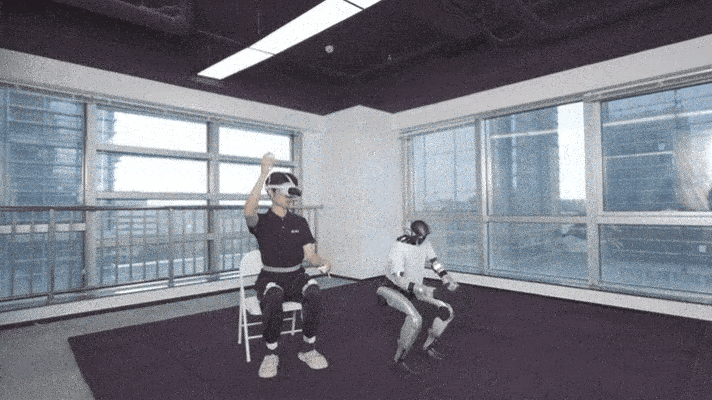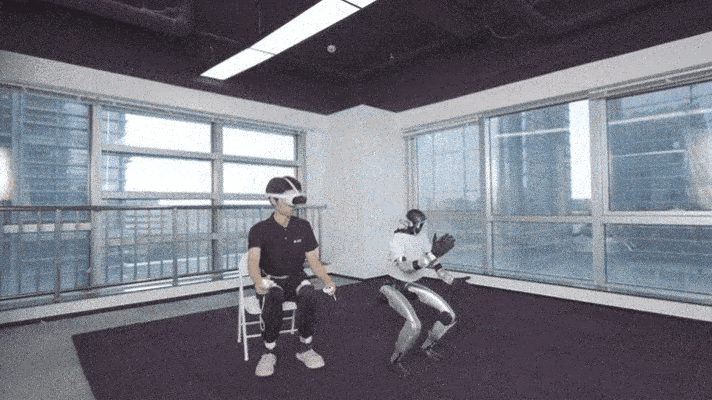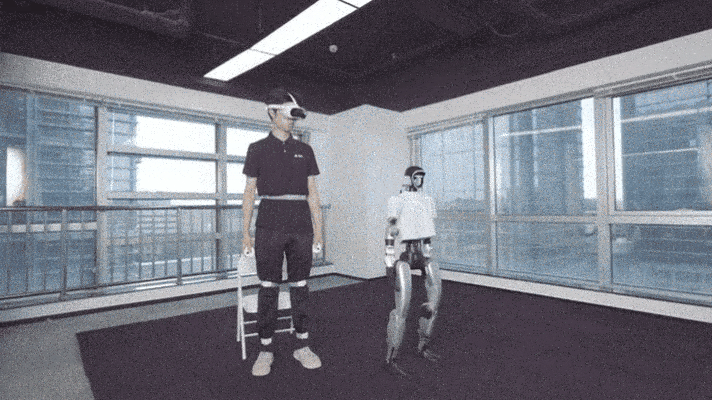
只有一套因果 Transformer,全程不换网络权重。
——BWM
人形全身跟踪器本质是个“控制接口”——上游只给粗糙运动意图,底层负责平衡和物理可行。
但大部分跟踪器都只停留在平地上:训练时空场景里只有一块地板,机器人从没踩过台阶、坐过椅子、搬过重物,根本不知道“脚下地面升高18厘米”会改变自己的动力学。
清华、GigaAI联合上海理工、北交大、中科院自动化所发布的GigaBrain-WBC-0.5,是业内第一个面向人形全身控制的行为世界模型(Behavior World Model)。
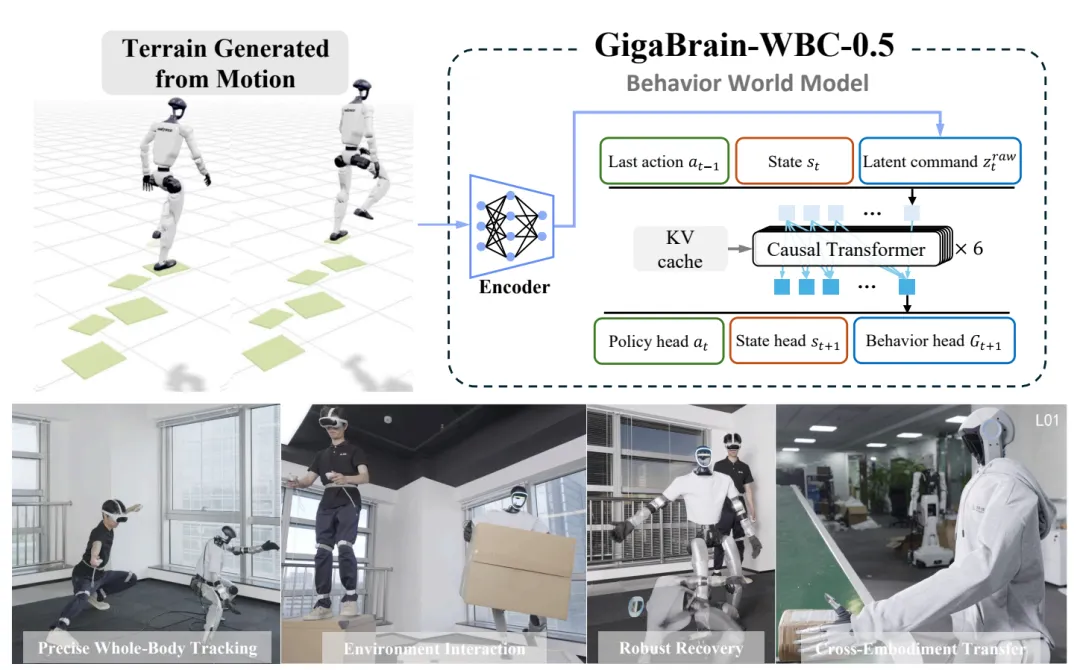
▲图 | GigaBrain-WBC-0.5:首个面向人形机器人全身控制的行为世界模型©【深蓝具身智能】编译
核心思路:别让控制器只预测下一个动作,而是让它同时预测“下一个本体状态”和“下一个潜在行为命令的分布”——
执行动作的网络同时建模当前环境允许它做什么,再配一套自动地形标注流水线,从普通重定向运动里恢复完整3D接触几何。
平地跟踪器的老路子,到了有地形的场景为什么失效
主流跟踪器(SONIC、HoloMotion-1、Humanoid-GPT)都是同一套配方:几十万小时重定向动作做模仿学习,空场景平地训练,靠扩大参考运动分布覆盖更多命令。
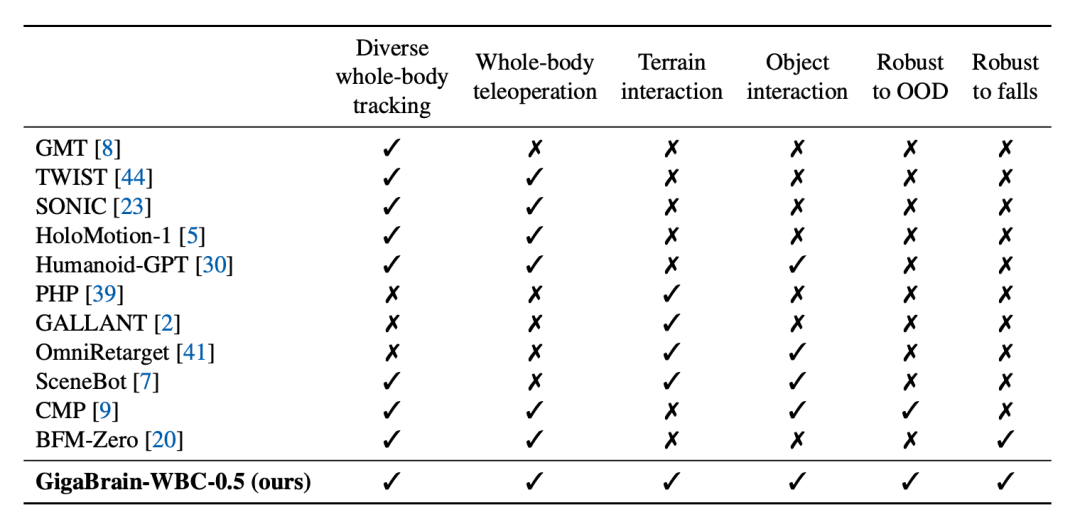
▲表 | 能力对比表:对比主流方案在遥操作、地形交互、物体交互、OOD鲁棒、跌倒鲁棒、多样全身跟踪六维度的能力覆盖©深蓝具身智能编译
-
环境交互数据稀缺
想让机器人学会踩台阶、坐椅子,需要"地形几何+对应运动"的成对数据且规模够。现有方案要么专门采集(SceneBot仅7.5小时),要么用2.5D高程图——
表达不了椅子下方悬空、桌子边缘、扶手这种“真3D几何”,还依赖逐连杆接触标签做命令通道,遥操作者根本给不出。
-
"扩大分布覆盖"的鲁棒性配方在地形上失效
可行行为集合变成“环境条件依赖”。RL策略收到分布外命令行为不可预测,地形把风险急剧放大。
需要的是在线机制:识别不合理命令,用"尽力而为"动作响应,而不是急停或僵立(楼梯上僵立比继续动更危险)。
还有互补问题:命令可能不可行,身体也可能已经倒地。现有方案切到专门站起控制器,但切换就中断任务,和跌倒本身一样破坏性。
GigaBrain-WBC-0.5把跌倒初始化直接训练进跟踪器,让“站起来”成为行为之一。
行为世界模型:执行网络同时预测"自己下一步会怎样"和"下一步能做什么"
基于Unitree G1(29自由度,50Hz),核心是6层因果Transformer带KV缓存。
每步输入本体状态、上一帧动作、潜在行为命令,三个头分别输出:
-
动作头:PD关节目标(29维),策略本身;
-
状态头:预测下一帧本体状态(67维),强迫网络内化当前接触动力学——踩上箱子、搬起负载时这个预测就变;
-
行为头:输出下一帧潜在命令的高斯混合分布(4分量,64维),强迫网络建模"当前情境下哪些行为可行"——楼梯上的可达命令集合和平地不一样。
总损失 = PPO损失 + 0.01×重建损失 + 1.0×循环一致性损失 + 0.01×状态预测MSE - 0.005×下一命令对数似然。
后两个辅助项就是把策略变成世界模型的关键。
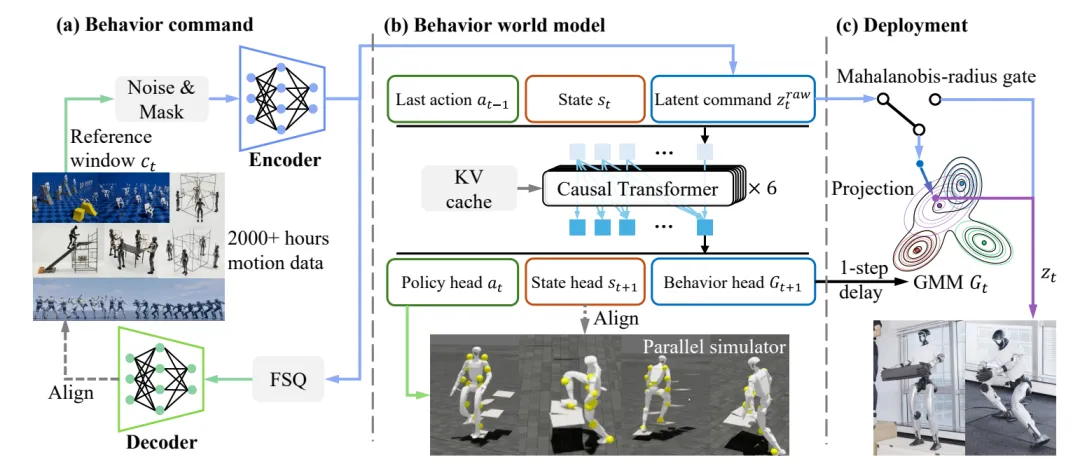
▲图 | GigaBrain-WBC-0.5方法总览©深蓝具身智能编译
为什么用高斯混合而非单高斯?
不同行为模式(不同速度方向的行走、不同风格起跳)在潜在空间占不同区域,压成单高斯会糊在一起,后面OOD过滤时"可执行区域"就会 spanning 当前情境根本不允许的行为。
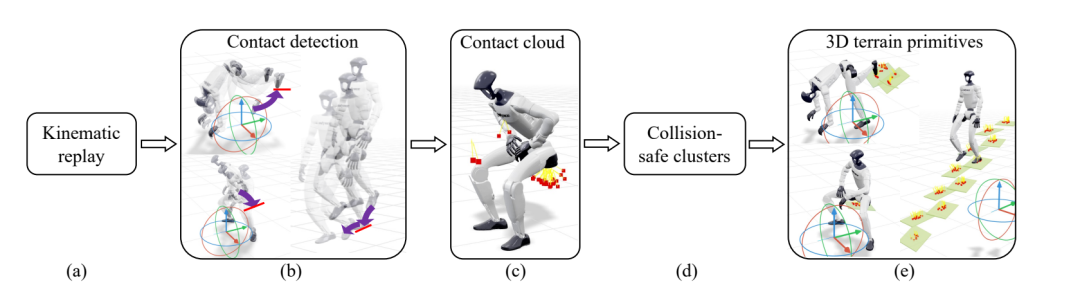
▲图 | 从运动到空间地形的自动标注流水线©深蓝具身智能编译
自动地形标注:从普通运动数据里"反推"3D地形
这是把地形交互训练规模拉上去的关键。普通动捕数据不带场景,但一段在楼梯上拍的运动,运动学里就藏着楼梯在哪里。
流水线五步:
-
运动学重放:MuJoCo里重放重定向轨迹,获取脚踝(可选扩展到手、膝、肘等)采样点的世界位置和外法向;
-
接触检测:平滑后用状态机标记——法向速度<0.2m/s、切向速度<0.3m/s,且前10帧至少2帧法向减速>1m/s²(减速特征才是支撑事件和"碰巧慢下来"的区别);
-
点云+穿透过滤:低于10cm或法向朝下的点当地板扔掉,1mm体素去重,每个幸存点做全身穿透测试——只有放一个向外偏移≥5cm的支撑体全程不穿身体才保留,防止重建出假几何;
-
聚类+基元拟合:按法向一致性(40°内)和法向偏移(10cm内)DBSCAN聚类,不同高度台阶踏板即使横向相邻也能分开,每个簇拟合成1cm厚定向盒子,L形/环形支撑递归拆分;
-
横向扩展:穿透安全二分搜索横向扩展,给原始足迹周围留余量。
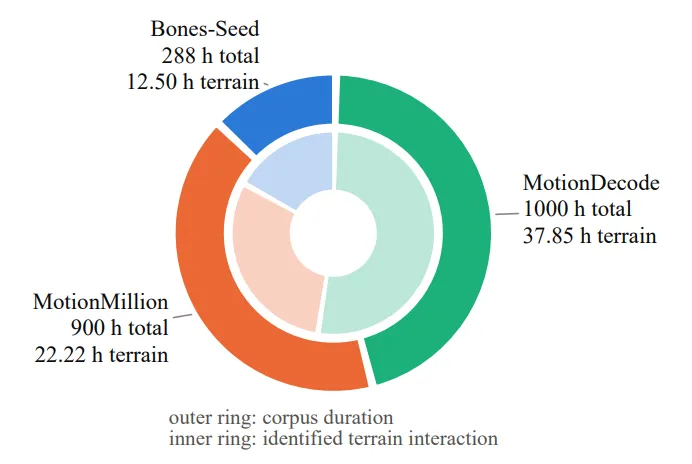
▲图 | 源语料库与识别的地形覆盖©深蓝具身智能编译
人工审核200条,整体准确率92%:箱子/平台98%(长而急剧减速接触),楼梯92%、椅子94%(脚或躯干太快模糊减速特征),其他类84%(主要是手支撑动作,手腕重定向误差干扰速度信号)。
所有失败都是保守的——缺支撑或位置偏,绝不会多出障碍物。
OOD命令过滤:用世界模型自己的预测,把不合理命令"拉回"可执行边界
这是把行为世界模型变成"鲁棒控制器"的关键。推理时,上一步输出的高斯混合,就是在看到当前命令前对"当前情境下哪些命令符合训练经验"的预测。把它当训练分布的一步近似来检查 incoming 命令。
顺序严格:当前命令先编码成,再用上一步的检查和投影,最后才进策略。用当前步混合检查当前命令等于把命令泄露进自己的可接纳性测试。
具体做法:
-
选分量:MAP风格规则选最可能行为模式k*——混合对数权重保持原生量级,高斯对数密度在64维取平均,行为模式先验权重更大,不会被协方差最松的无关分量"捡漏";
-
马氏距离测试:到k*的平方马氏距离超过 ² 就算OOD;
-
径向回缩:不替换成均值(均值是分布中心不是动作),沿"从均值指向原始命令"的射线缩回到椭球边界——闭式解,每步O(1),耗时<1ms(控制周期20ms)。
回缩后命令仍从可信模式指向操作者想要的方向,机器人继续尝试任务而非僵住。过滤器无记忆,每帧重新选分量重新评估,可接纳区域随情境演化。只有一个运行时可调旋钮,不用重训就能在精度和鲁棒性间滑动。
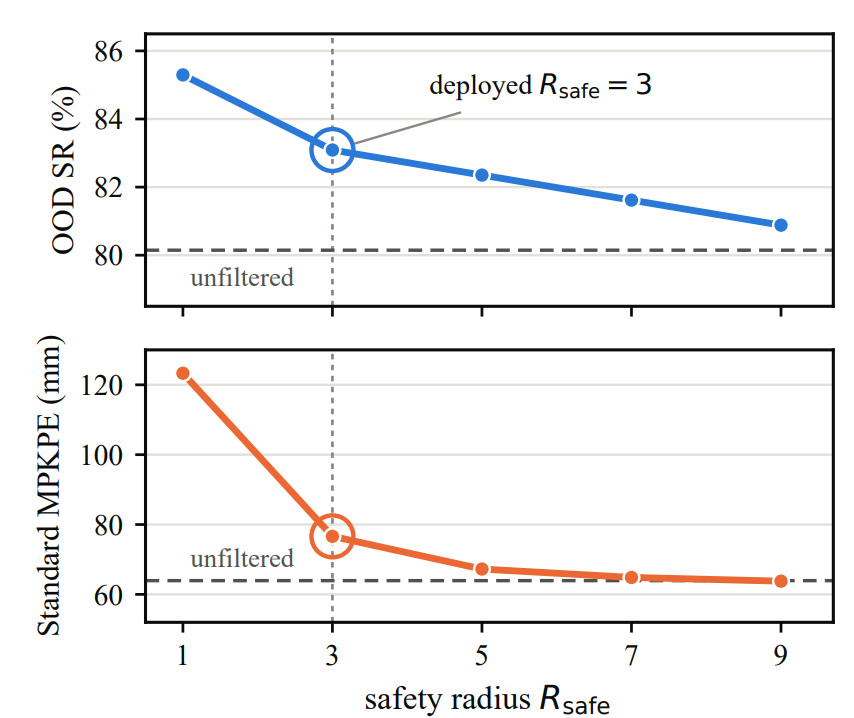
▲图 | 鲁棒性与精度随安全半径变化的权衡曲线©深蓝具身智能编译
是部署拐点:从不过滤收紧到3,OOD生存率涨2.9点,Standard MPKPE只多12.7mm;继续收到1,再涨2.2点但付出46.7mm。
这个曲线不是设计时定死的,操作者可在运行中机器人上用一个标量滑动。
实验
仿真对比:MuJoCo四组测试全面领先
在MuJoCo里和SONIC、HoloMotion-1、Humanoid-GPT三个最强公开跟踪器做sim-to-sim对比,统一失败判据、全长rollout,所有方法都不用硬件拿不到的信号。
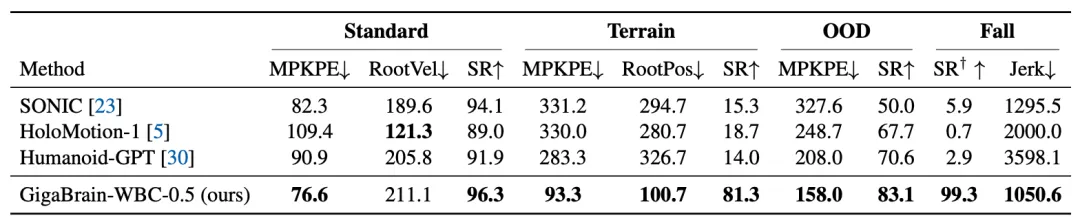
▲表 | MuJoCo中sim-to-sim对比结果©深蓝具身智能编译
5.2 硬件验证:真实环境交互与抗扰动
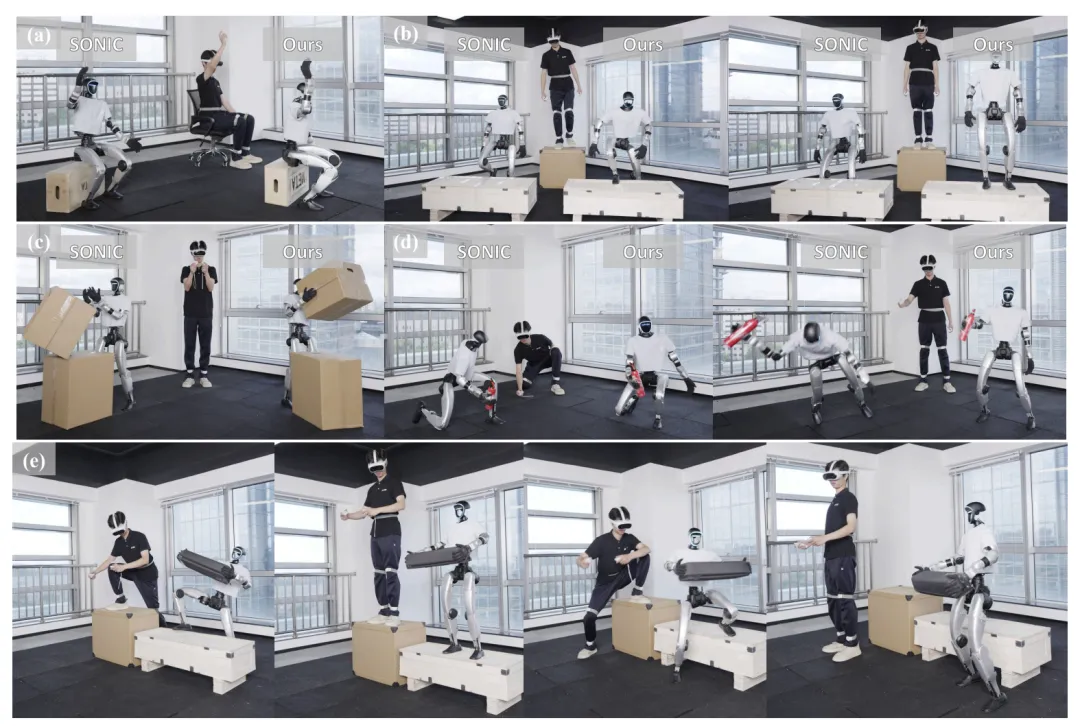
▲图 | 硬件上的环境交互对比©深蓝具身智能编译
硬件实验更有说服力:同一操作者同时驱动SONIC和本文,本文能坐箱子、踏平台、举箱子、跪站搬灭火器、搬长箱上下平台,SONIC要么半蹲不加载、要么爬不上、要么摔倒。
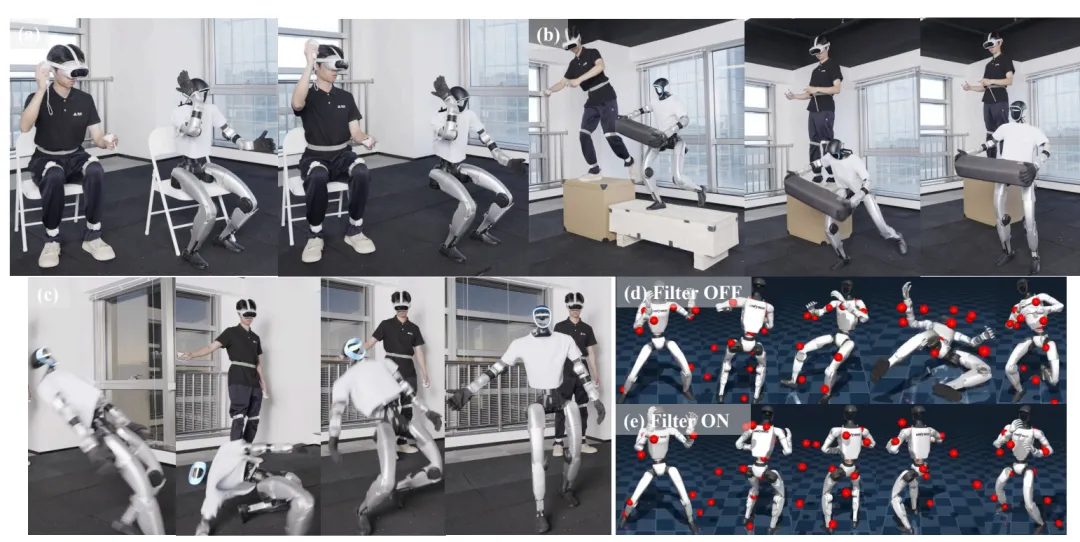
▲图 | 对不安全命令和物理扰动的鲁棒性©深蓝具身智能编译
本文还能在预期支撑缺失时给稳定尽力而为响应(不摔东西),被踢倒后同一跟踪策略自己站起恢复控制,不用切专门模式。
仿真中同一自干扰旋转踢参考,关闭过滤器机器人尝试踢腿然后摔倒(虽后续恢复),开启过滤器保留命令转向、抑制困难踢腿、保持直立——这种预判式修正直接来自世界模型。
跨本体迁移与全身能力展示
跨本体迁移:G1 checkpoint在Maker L01上简单微调(单节点8GPU)即恢复全身跟踪,从零训练L01收敛很慢,行为世界模型似乎携带了"人形如何与环境交互"的结构,不特定于某套连杆长度。
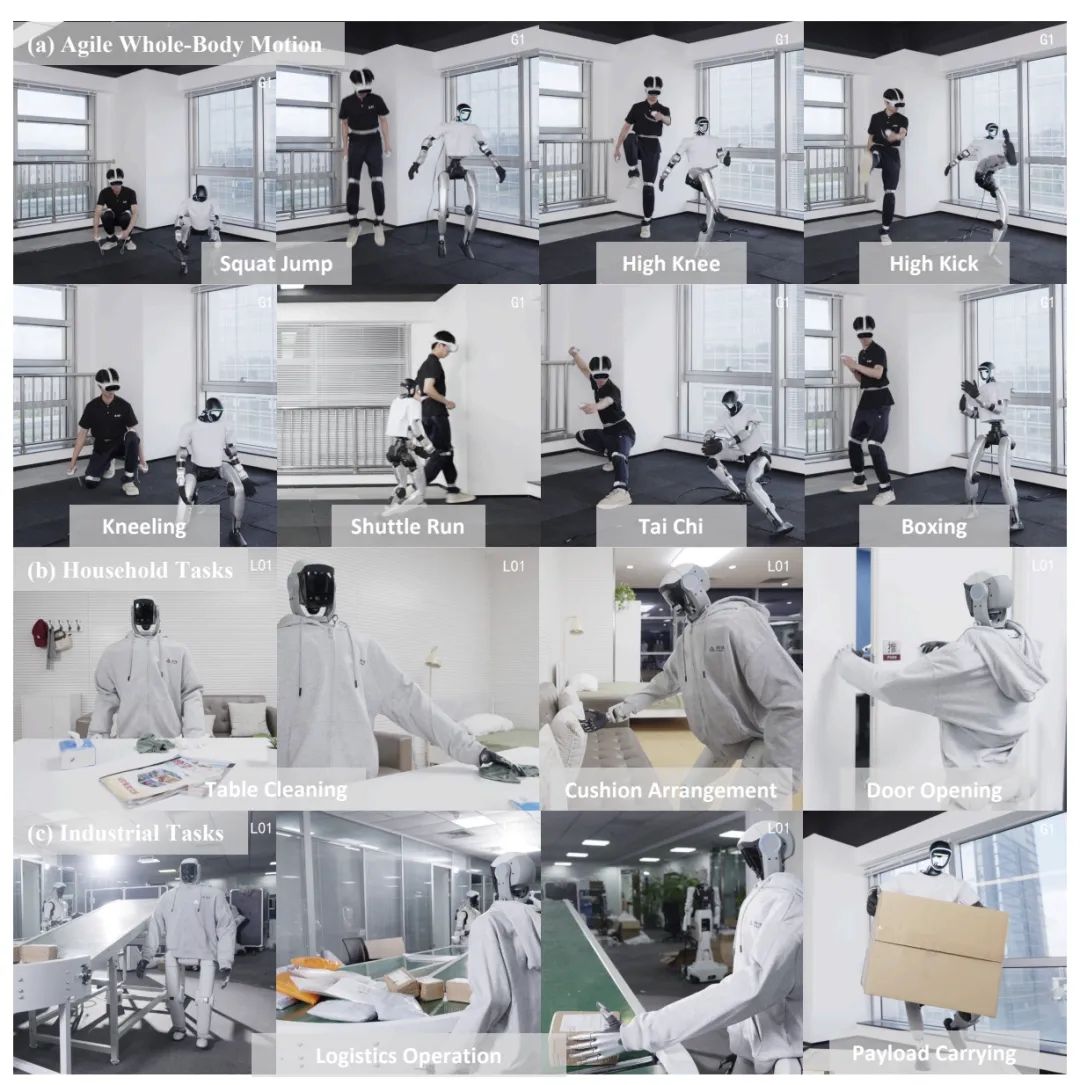
▲图 | 全身运动能力展示©深蓝具身智能编译
同一策略在实时全身命令下完成敏捷运动(深蹲跳、高踢、太极、拳击)、家务任务(擦桌、整理靠垫、开门)、工业任务(物流操作、负载搬运),G1和微调后的L01均有录制。
一个能力的两个方面
GigaBrain-WBC-0.5的一个判断是:
人形跟踪器缺的两个能力:与环境交互、被要求做环境不允许的事时保持得体。
其实是同一个能力的两面,都来自让控制器预测自己的未来,而不只是下一个动作。
状态预测强迫网络内化接触动力学,命令分布预测强迫网络建模环境允许的行为集合——这两个辅助项把纯反应式跟踪器变成行为世界模型。
再加上自动3D地形标注把交互数据规模拉上去、无记忆闭式OOD过滤把鲁棒性做成运行时可调旋钮、跌倒初始化内建让恢复不中断任务,整套方案在四个测试维度全面领先三个最强基线。
这还是0.5版本。
过滤器的物理可解释性、地形重建完整性、硬件大规模量化验证,都是后续要补的课。
编辑|小小怪博士
审编|具身君
参考论文:
论文标题:GigaBrain-WBC-0.5: A Behavior World Model for Robust Whole-Body Control with Environment Interaction
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
