

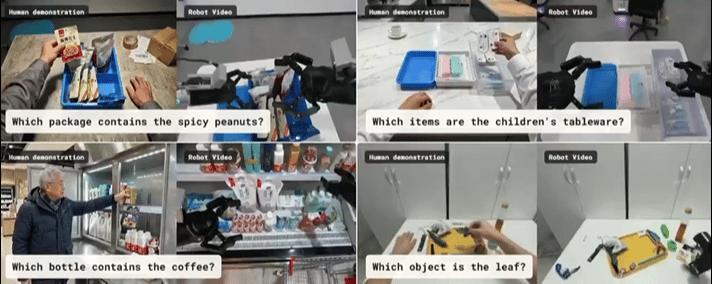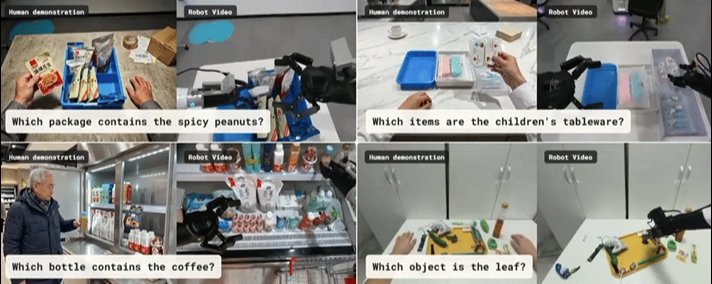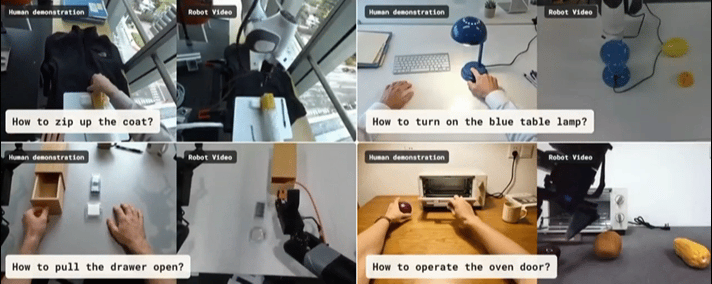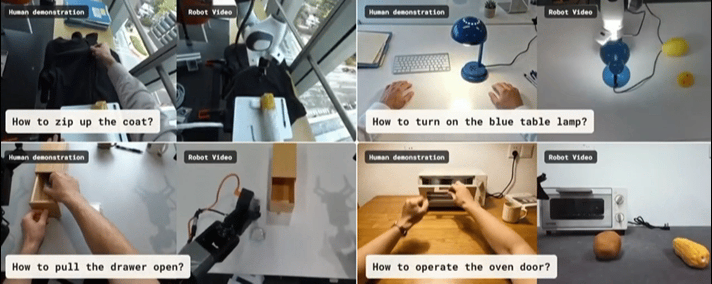
把大模型上下文学习搬到机械臂,给一段人类操作视频,无需微调,机器人直接复现陌生任务
——Zero‑WAM
在大语言模型中,上下文学习只靠提示文本就能完成全新任务,不需要改动模型权重。但放到机器人操纵领域,只用语言指令会遇到明显短板:语言很难精准描述物体空间约束、中间状态变化、时序操作流程,很多精细的动作,文字说不清楚。
香港科技大学(广州)等团队提出的 Zero‑WAM ,就是把人类演示视频作为机器人的上下文提示。不用给机器人收集对应任务的机械手轨迹,只输入一段人的操作视频,模型就推理出任务应该发生怎样的视觉变化,再映射成机器人本体可执行动作。
现有路线的两大现实卡点
世界行动模型(WAM,World‑Action Model)核心逻辑是先预测未来世界画面,再从预测画面解码机器人动作。
但想要实现“看人类视频做新任务”,现存方案被两道现实门槛卡住:
第一,缺少大规模、语义对齐的人‑机器人配对数据。
想要模型学会看懂人类视频、转换成机器人动作,需要大量“人类操作视频 + 对应机器人执行轨迹”的成对样本。人工采集这套数据成本极高,现有的公开数据集大多样本量小、任务种类少,很难支撑大模型预训练。很多数据集还要求人类视角、背景、物体必须和机器人场景高度一致,泛化能力弱。
第二,模型容易学捷径,不去看视频提示。
如果直接拿成对数据训练,模型会偷懒:仅仅依靠机器人自身历史观测、文本指令就预测下一步,直接忽略输入的人类视频提示。训练集见过的任务效果尚可,但是测试遇到全新任务的时候,本该依赖视频提示,模型却依旧只看历史观测,视频提示形同虚设。
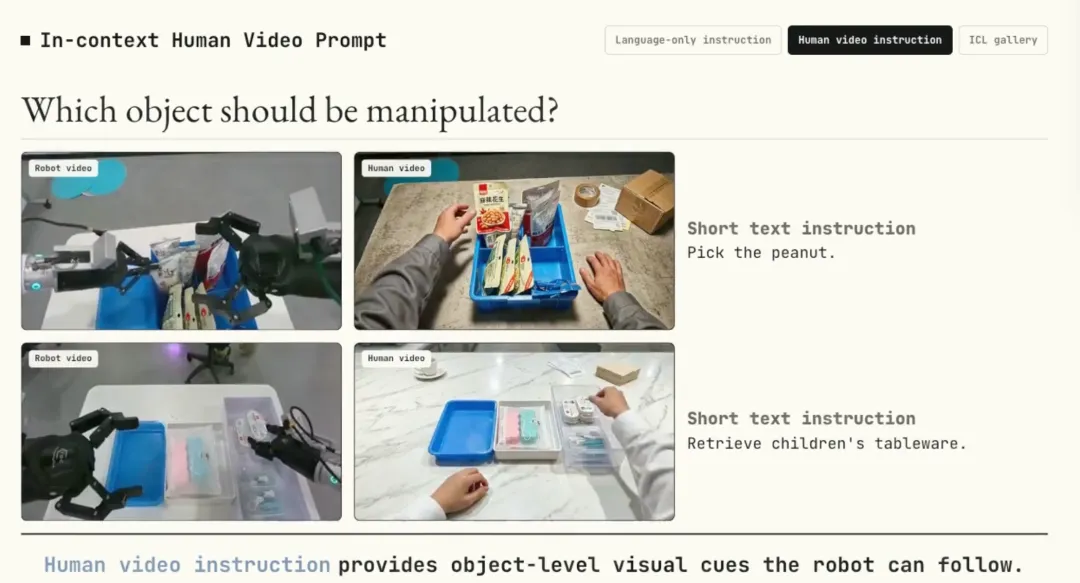
Zero‑WAM整套工作,就是围绕解决上面两个痛点展开:一套自动生成人‑机器人配对数据流水线,再搭配专门的训练目标,强制模型真正读取视频提示的信息。
整套技术链路:数据、模型架构、IFP训练目标
整套系统由三块核心部分构成:
任务均衡机器人数据集Task‑diverse VA、自动生成人‑机器人配对的HumanGen数据集、Zero‑WAM因果视频‑动作模型,搭配IFP辅助损失抑制捷径学习。
Task‑diverse VA:按任务做均衡采样,拒绝重复轨迹泛滥
公开机器人数据集往往存在大量重复遥操作轨迹,少数任务占据绝大多数样本。
直接拿来训练,模型容易过度拟合高频任务,任务多样性被浪费。
Task‑diverse VA会把原始数据集按照“操作动作+操作对象”重新划分任务,每个任务限制采样轨迹数量。研究一共处理5套公开机器人数据集,划分出6000+不同任务,每个训练epoch采样约40万条机器人轨迹。
这套任务级采样,一方面给后续HumanGen流水线提供丰富源数据;另一方面,即便是只用语言指令的模式,也能提升跨任务泛化能力。
HumanGen数据集:不用人工拍视频,由机器人轨迹自动生成人类演示视频
这是本篇工作一大核心贡献,不再人工录制人类视频,从已经存在的机器人轨迹出发,全自动生成语义匹配的人类操作视频,形成人‑机器人ICL配对样本。
最终HumanGen拥有74.2K组人‑机器人配对,覆盖8.6K种任务。
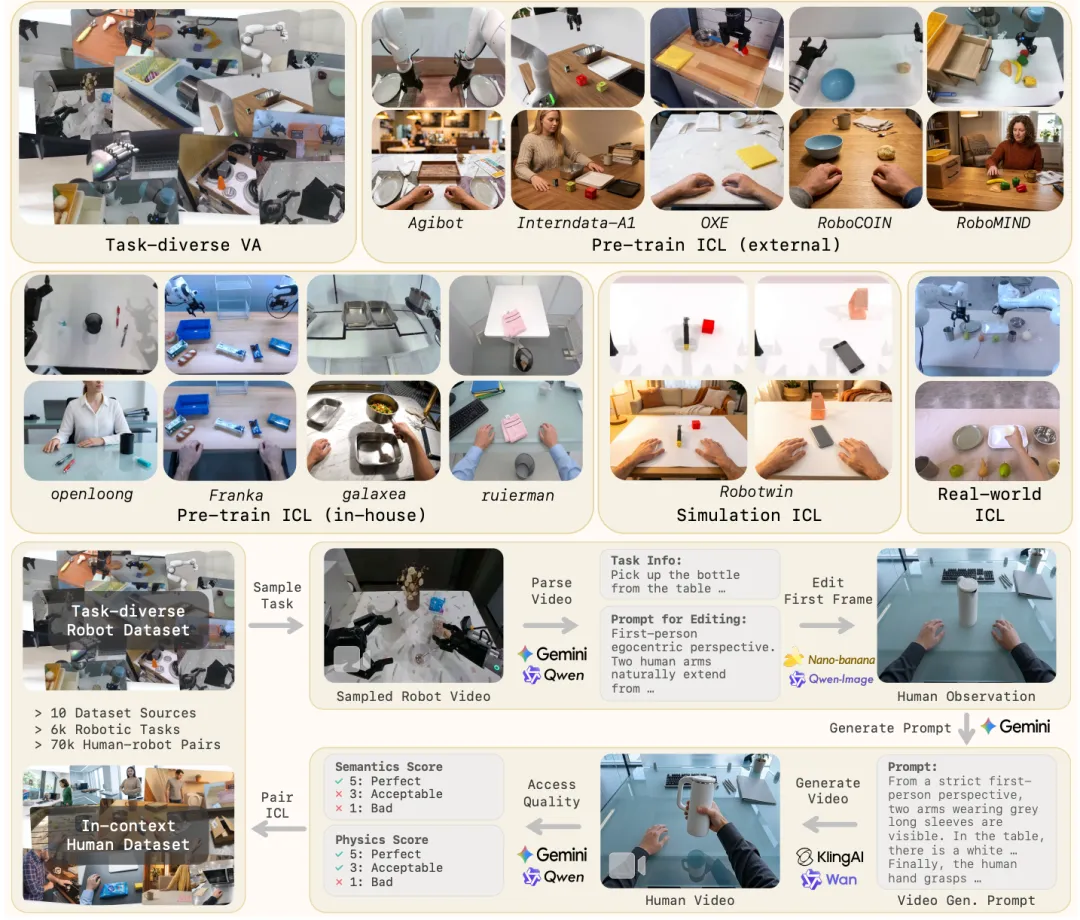
▲图 | 数据构建与上下文人类视频生成©深蓝具身智能编译
流水线执行流程:
-
对采样得到的机器人视频,调用多模态大模型解析任务信息:
任务名称、物体初始状态、状态变化、最终状态;同时产出图像编辑提示词,把机器人第一帧画面改写成人类操作场景的初始画面;
流程会主动做多样化改动:背景、视角、物体实例、摆放位置发生变化,但是任务语义不变,迫使模型学习语义对齐,而不是匹配画面像素。
-
图像编辑模型生成人类操作场景的初始观测图;再由多模态模型结合物体状态变化,产出视频生成prompt。
-
文生视频模型生成完整人类操作演示视频。
-
再次调用大模型做双重校验:
评估任务语义保留程度、物理合理性,过滤不合格样本。合格样本,将人类视频与原始机器人轨迹绑定,成为一组ICL训练样本。
对比传统MIME、RH20T这类数据集,它们全部依靠人工采集人类视频,任务数只有几十到一百多;HumanGen全自动生成,任务规模提升两个量级,同时允许人类视频和机器人画面视觉上差异巨大,训练出来的模型不会被画面像素绑架,只关注任务语义。
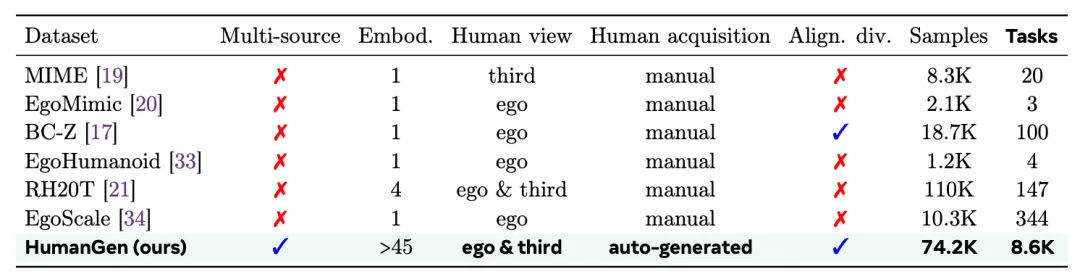
▲表 | 与现有任务级人‑机器人数据集对比©深蓝具身智能编译
Zero‑WAM模型架构:统一支持文本 / 人类视频两种任务提示
Zero‑WAM基于Wan‑2.2‑TI2V‑5B视频生成基座改造,采用Mixture‑of‑Transformers(MoT)混合Transformer架构,视频分支和动作分支拥有独立QKV、前馈网络和输出头,共享注意力层交互信息。
整体遵循因果视频‑动作建模范式:
输入观测、任务条件,自回归分块预测未来机器人视频块,再基于预测视频解码对应的可执行动作块。
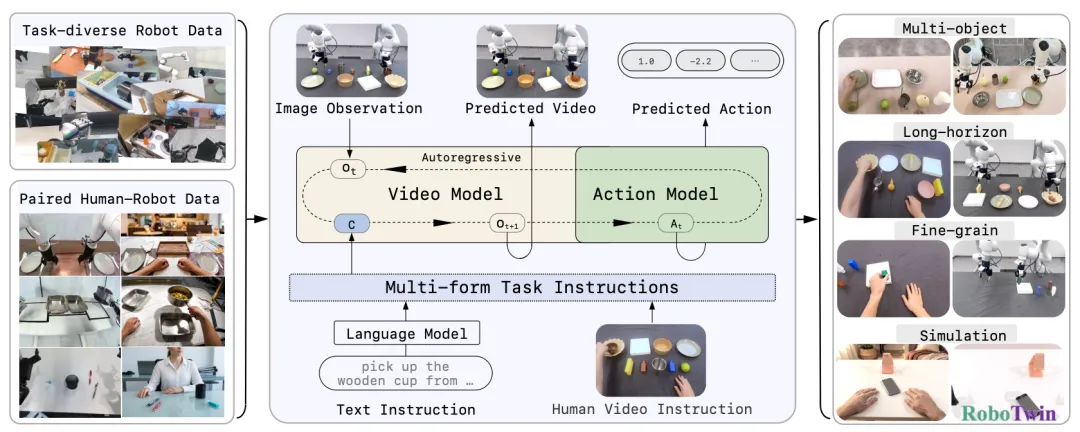
▲图 | Zero‑WAM总览:Zero‑WAM可以根据上下文人类视频提示或者语言指令,预测未来机器人视频与可执行动作©深蓝具身智能编译
任务条件c存在两种模式:
语言模式:c=语言指令,只用文字描述任务。
ICL视频提示模式:c = 人类视频 + 语言指令(语言可以关闭),人类视频序列直接拼接放在机器人观测序列最前面,作为上下文记忆。
为了区分序列里的人类视频latent和机器人视频latent,研究对人类视频的RoPE旋转位置编码施加高度维度偏移,两套表征处在不同坐标区间,避免表征混淆。
可以这样理解:
人类视频只给视频分支看,用来推演未来世界会发生什么状态变化;
动作分支不会直接读取人类视频,它只接收预测出来的机器人未来视频,再做逆动力学解码输出电机动作。
这样做的逻辑:人类手的运动轨迹不能直接复制给机械臂,机器人需要先理解“世界应该变成什么样”,再输出适配自己本体的动作。
IFP上下文未来分块预测:专治模型捷径学习
这部分的作用是用来解决模型绕开人类视频提示、依赖历史观测偷懒的问题。
传统训练只监督紧挨着的下一个视频块,模型可以靠机器人历史观测直接预测,不去看人类视频。
IFP(In‑Context Future chunk Prediction)新增辅助训练目标:基于当前的特征,同时预测未来多个间隔步长的视频块。
重点设计细节:IFP模块不能直接看到人类视频提示,它只能读取主视频Transformer输出的融合特征。
这就强制主分支必须把人类视频里面的任务演化信息编码进自身特征,否则IFP模块就无法预测未来多步画面。推理阶段IFP模块直接被移除,不会增加推理开销。
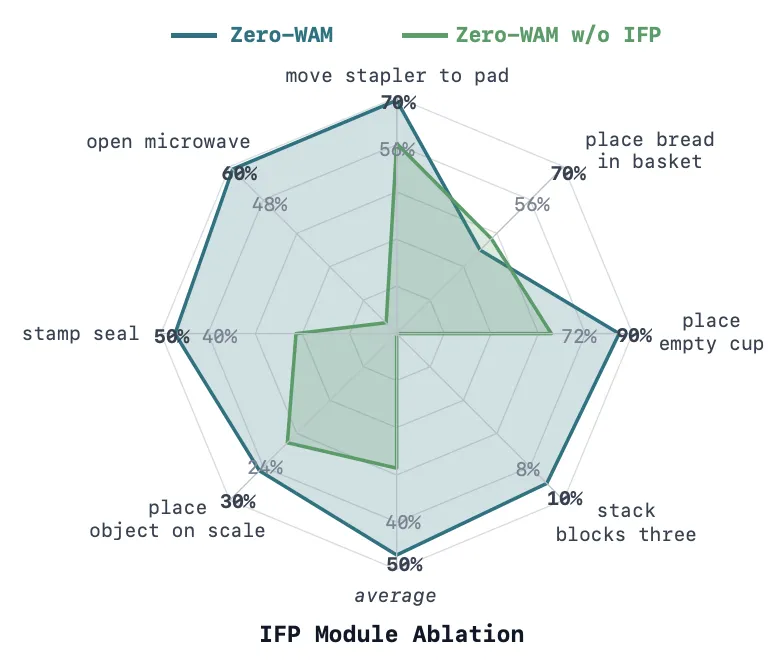
▲图 | FP模块消融:完整Zero‑WAM对比去掉IFP的版本,7项仿真未见任务平均成功率从28.55%提升到46.95%,长时序堆叠积木任务从0%提升至9%,在铰接物体操作任务提升尤为明显。©深蓝具身智能编译
损失函数整体由三部分组成:视频流匹配损失、动作流匹配损失,HumanGen样本额外加权IFP损失。
在推理的时候,模型二选一:输入语言指令;或者输入人类演示视频,缓存人类视频token作为前缀记忆,自回归逐块生成视频和动作。
实验
实验分为RoboTwin 2.0仿真零样本跨任务、Franka双臂机器人真机未见配置两大块。
RoboTwin2.0仿真零样本跨任务
数据集严格按任务做切分:43个任务参与后训练,7个任务完全没有出现机器人演示轨迹,用来做零样本评测。7项任务包括放置物件到秤、盖章、打开微波炉、移动订书机、放面包进篮子、放空杯子、堆叠三块积木,覆盖未见物体、铰接物体操作、长时序任务。
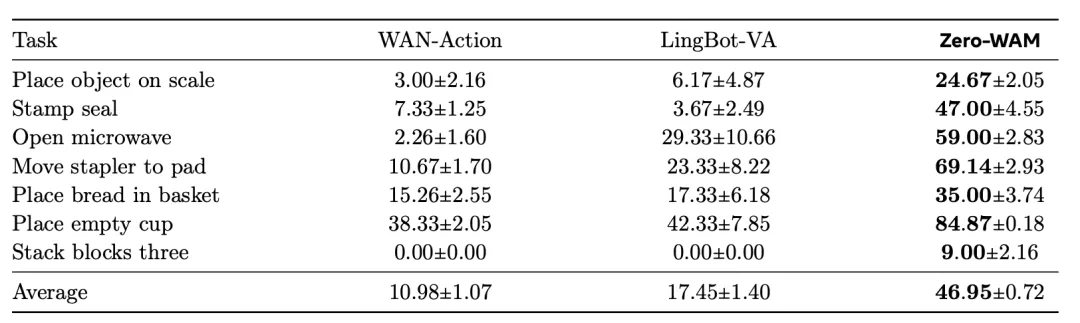
▲表 | RoboTwin 2.0七项未见任务上的零样本跨任务结果©深蓝具身智能编译
Zero‑WAM平均成功率46.95%,相比LingBot‑VA高出29.5个百分点,全部7个任务上全面领先基线。最难的长时序堆叠积木,两个基线完全为0,Zero‑WAM拿到9%成功率。
这是完全零样本跨任务,训练过程从来没有见过这7个任务的机器人轨迹。47%的平均成功率证明:仅凭一段人类视频提示,模型确实可以推断全新任务的时序物理演化,而不是死记训练集任务。堆叠三块积木依旧只有9%,说明超长时序多步骤操纵,依旧是世界行动模型的“硬骨头”。
真实Franka双臂机器人实验
真机评估三类任务:物体‑容器放置、三物体顺序操纵、桌腿精密插入:训练见过同类任务,但是测试时物体、容器、目标组合全部没见过;Zero‑WAM输入人类视频提示;基线LingBot‑VA使用详细语言文本指令。
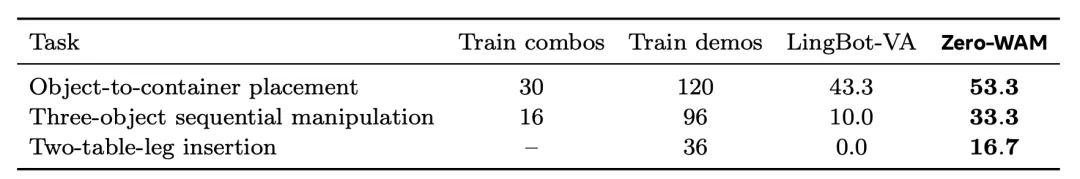
▲表 | 真实世界未见配置评估结果:在30次真实机器人试验上报告任务成功率。©深蓝具身智能编译
真机可以看到明显趋势:越是依赖时序顺序、精细空间约束,人类视频提示带来的增益越大。
三物体长时序顺序操作:文本基线仅10%,Zero‑WAM达到33.3%;精密桌腿插入,语言基线完全失败,Zero‑WAM实现16.7%成功率。
真机局限也要客观看待:真机试验每一类任务只有30次测试,样本量不大;精密插入整体成功率依旧不高。
但现象很明确:对于语言很难描述的时序流程、精细空间约束,人类视频作为提示,确实比纯语言指令更加可靠。
拿人类视频当提示词
Zero‑WAM做了一次很有价值的探索:把大模型的上下文学习范式迁移到机器人操纵,任务指令不一定非得是文字,一段人类操作视频也可以作为提示词。
过去想让机器人做新任务,要么写一大段复杂prompt,要么收集一大堆机器人示教数据。
Zero‑WAM指向另一种可能性:未来实际部署场景,用户只需要录一段自己动手操作的短视频,不用写繁琐的描述,机器人看一遍视频,就尝试复现整套任务,不需要重新训练。
人工采集海量人‑机器人配对数据成本高到难以规模化;而Zero‑WAM的HumanGen流水线,复用存量机器人轨迹自动生成人类演示视频,为解决“人类演示数据规模化”给出了可行的工程方案。
但同时,长时序多步骤操纵、亚厘米级精密装配,依旧是世界行动模型共同的难题。未来一个重要方向是利用真实的第一人称互联网人类视频作为上下文提示,而不是AI生成视频;如何进一步降低视频预测错误,是该路线能否走向落地的关键。
编辑|小小怪博士
审编|具身君
Ref
论文标题:Zero‑WAM: In‑Context World‑Action Modeling from Human Videos for Open‑Ended Task Generalization
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
