

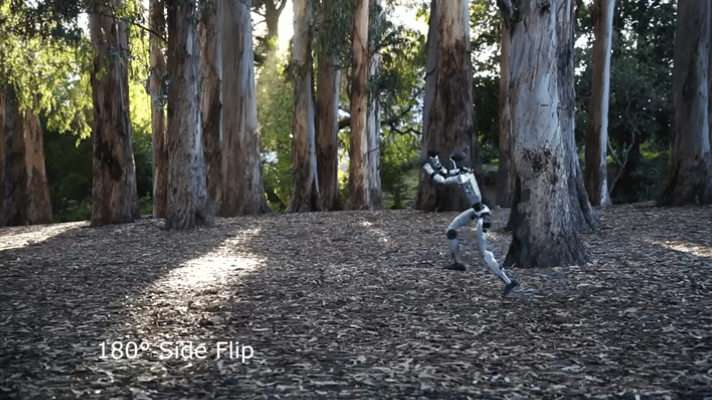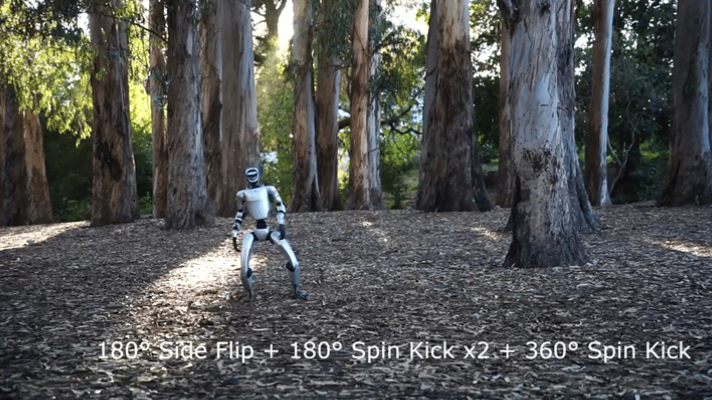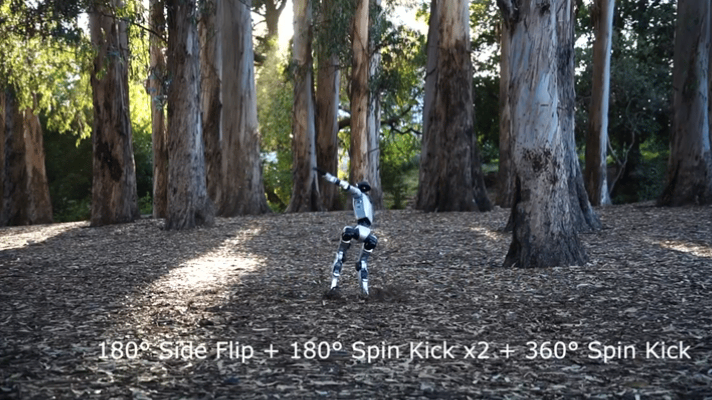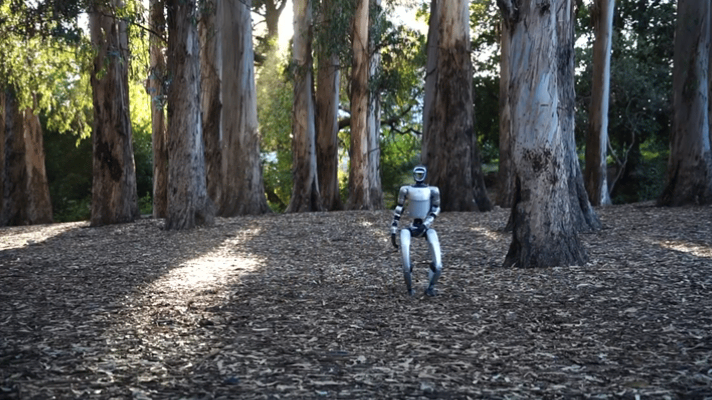
训练只学运动先验,测试靠代价函数零样本解决陌生任务
——一个框架,百种动作
人形机器人模仿人类动作的方案已经不少,DeepMimic、AMP等,能够复现跑步、跳跃等运动。
近日,伯克利与斯坦福联合发布于Science Robotics的BeyondMimic,提出了出一套两阶段解决方案。
第一阶段依靠一套统一配方的强化学习运动跟踪流水线,在共享超参下学习大量高敏捷人类动作,实机完成侧手翻、旋踢、连续特技;
第二阶段训练潜在状态‑动作扩散模型,完成航点导航、摇杆遥操作、关键帧动作补全、障碍物规避,并且在Unitree G1真机完成全部能力验证。
打通了“模仿动作”到“组合技能解决未知任务”的链路。
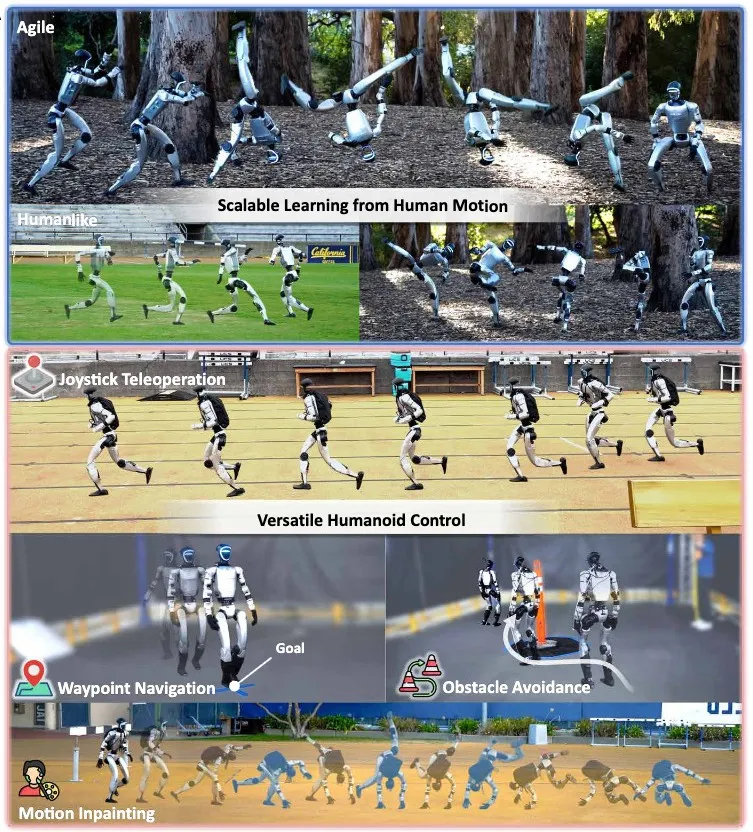
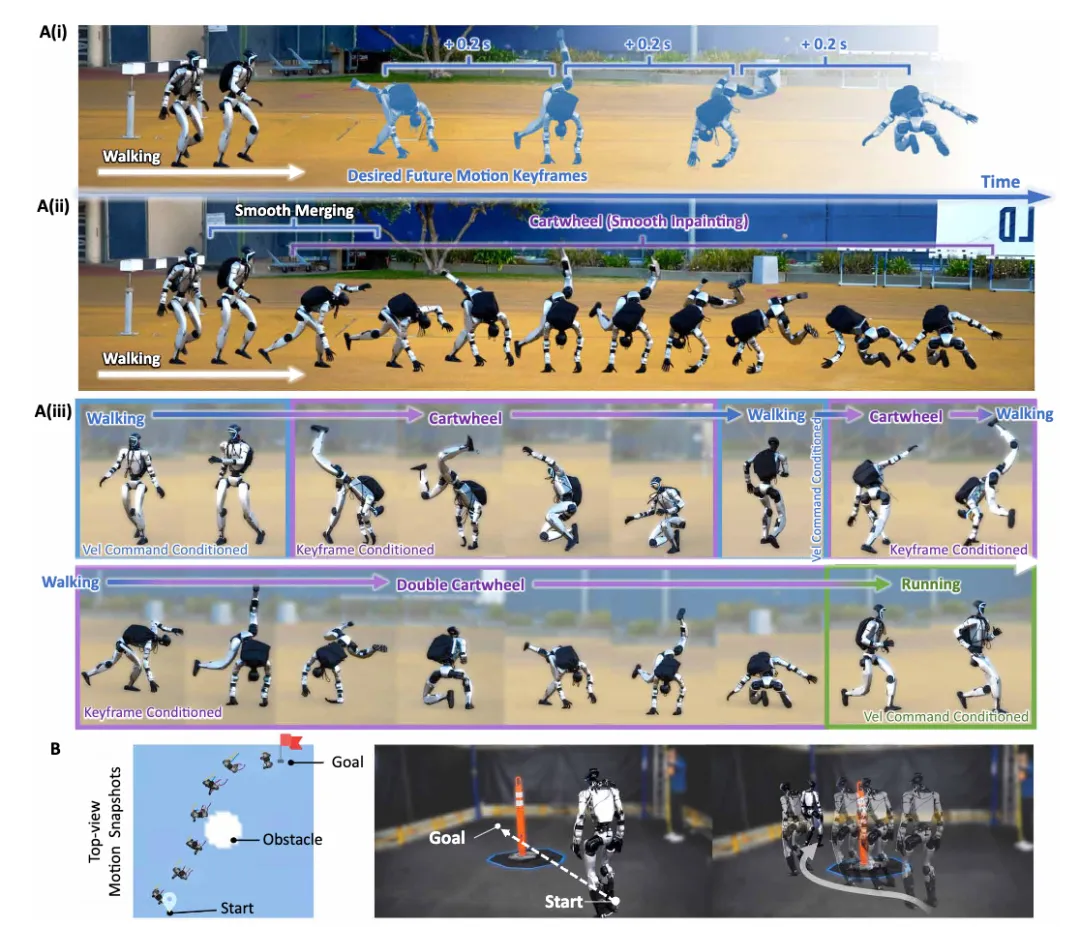
▲图 | 提出的通用人形机器人控制框架总览示意图©【深蓝具身智能】编译
看清现有运动路线躲不开的底层矛盾
-
基于模型的分层控制
依靠质心、动量、接触时序做上层规划,底层控制器跟踪参考轨迹。
优势是物理可解释;短板是为简化计算会牺牲动作自然度,容易出现膝盖持续弯曲、质心高度固定这类不拟人现象;
对于地面翻滚这类多接触复杂特技,规划器编写难度陡增,高动态运动下仿真现实鸿沟大。
-
任务定制强化学习(DeepMimic流派)
通过参考运动奖励复现动捕动作,可以实现很自然的特技,但是每个新技能几乎都需要针对性调参,技能规模化扩展成本很高。策略本质是轨迹回放,输入必须是完整参考运动序列,不能响应零散指令,遇到没见过的任务束手无策。
-
VAE类多任务生成运动先验
学习运动分布,支持一定的技能组合。但高度依赖训练阶段的目标条件标注;面对避障这类难以显式描述的隐式目标时,容易输出抖动、物理不合理的动作,泛化能力受限。
-
分层规划+跟踪器解耦方案
上层生成运动学轨迹,下层独立跟踪控制器。最大隐患是规划‑控制器失配:规划器输出的轨迹不一定满足机器人动力学,下层执行时会出现动作崩坏,两套模块分开训练很难完全对齐。
-
BeyondMimic的思路,是把运动跟踪强化学习与状态‑动作扩散模型结合为完整链路
第一阶段产出大量高质量、可部署的技能教师策略;第二阶段把这些技能蒸馏进入扩散模型,推理时依靠引导梯度,直接在同一个模型内完成规划+控制,规避规划跟踪失配。整套框架训练阶段完全任务无关,任务逻辑全部放到测试时引入。
两大核心模块:从批量学技能到推理阶段按需组装任务
第一阶段产出一批运动跟踪教师策略;第二阶段对教师策略的数据做蒸馏,训练潜在状态‑动作扩散模型,最终实机部署的是扩散模型,而非原始RL跟踪策略。
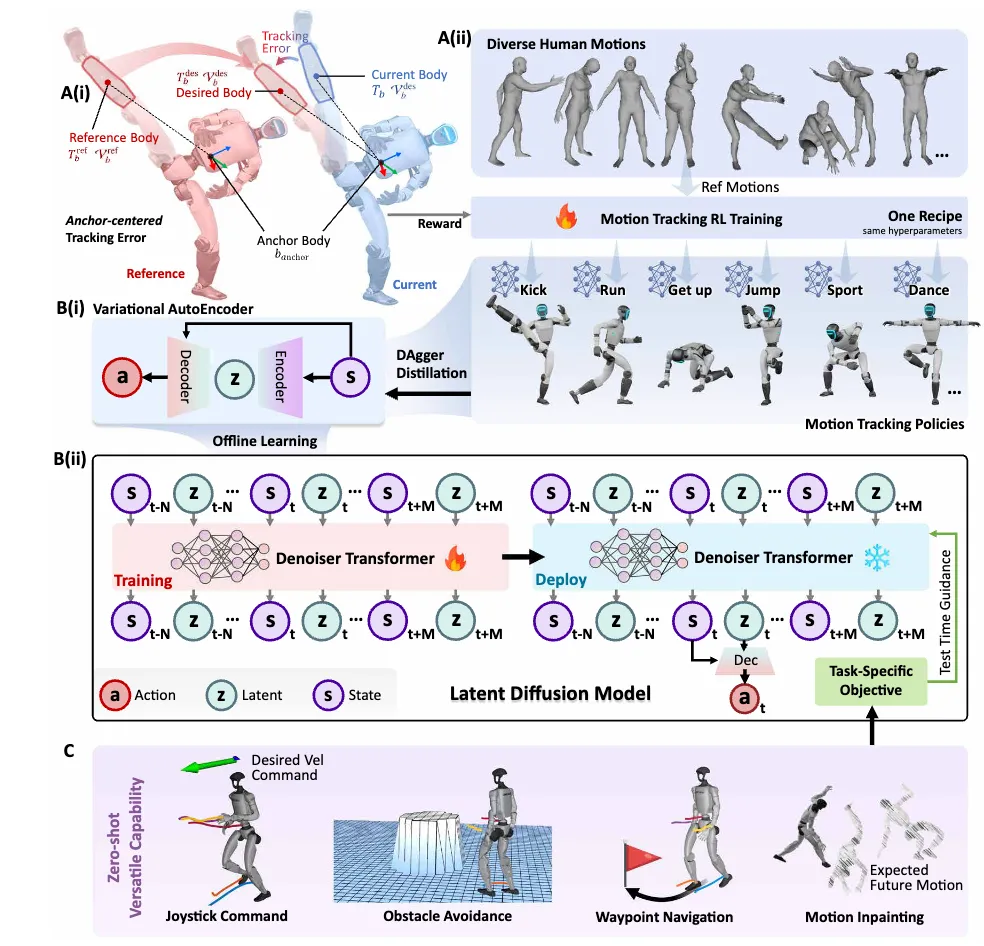
▲图 | 完整框架系统示意图©【深蓝具身智能】编译
可扩展RL运动跟踪
很多人会把这部分简单理解成DeepMimic复刻动作,但实际上是一套MDP配方、同一组超参,训练完全不同的动作,不需要每个特技单独调参。
-
锚点中心相对跟踪目标
不强制全局位姿严格对齐参考,以躯干为锚点,只约束各连杆相对姿态。允许全局发生合理漂移,在保留动作风格的同时,提升对扰动、仿真现实差异的鲁棒性。
-
极简统一奖励函数
仅由跟踪主项+三项轻量化正则构成:关节限位惩罚、动作平滑惩罚、自碰撞惩罚。没有大量手工设计的启发式奖励,降低调参负担。
-
无历史观测输入
不堆叠长时间历史状态观测,减少过拟合仿真特有时序模式,提升迁移到真机的稳定性。
-
自适应采样策略
长参考运动内部难度不均衡,算法自动提高失败片段的采样概率,难题收敛速度大幅提升,解决长序列动捕训练难以收敛的痛点。
-
适度域随机化
没有做大规模暴力随机,仅对地面摩擦、关节零位、躯干惯量做有限随机;论文给出观点,过度域随机化反而会让动作变得保守僵硬。同时依赖精确的电机armature机械参数建模,这对实机迁移起到关键作用。
该阶段使用约2.5小时的多样化人类动捕数据,仿真完成训练,21个代表性片段直接零样本部署Unitree G1真机,覆盖单腿站立、腾空侧手翻、旋踢、连续特技、舞蹈、倒地起立等。
▲图 | 任务过渡与动作组合效果展示©【深蓝具身智能】编译
潜在状态‑动作扩散模型:训练不管任务,靠引导临场适配需求
第一阶段的RL跟踪策略有本质局限:它需要一条完整的参考运动作为输入。
如果用户只给摇杆速度、航点、零散关键帧,没有完整参考轨迹,策略无法直接使用。
BeyondMimic第二阶段并不直接拿动捕数据训扩散,而是把第一阶段所有RL教师策略跑出来的状态‑动作轨迹作为数据集。
流程分为两步:
-
训练条件VAE,对教师策略做DAgger蒸馏,把高维的状态动作序列压缩进入平滑潜空间;
-
在VAE输出的潜轨迹之上,训练Transformer去噪器,得到潜在状态‑动作扩散模型。模型同时建模未来状态序列与动作序列,不只是单纯输出关节动作,隐式学习动作带来的状态演化,自带预测能力。
核心机制:分类器引导(Classifier Guidance)。
训练全程完全看不到导航、避障、遥操作等任务;部署阶段,针对新任务手写简单可微代价函数,在扩散去噪迭代过程中,把代价梯度加到潜变量更新步骤,迭代把生成轨迹推向满足任务目标的方向。
这就实现零样本任务适配:
航点导航就写位置代价;摇杆遥操作写速度代价;避障用符号距离场SDF构建障碍物排斥代价;运动补全任务把给定关键帧作为硬约束。不同代价还可以直接相加组合,实现“一边往航点走一边躲避障碍物”这类复合任务。
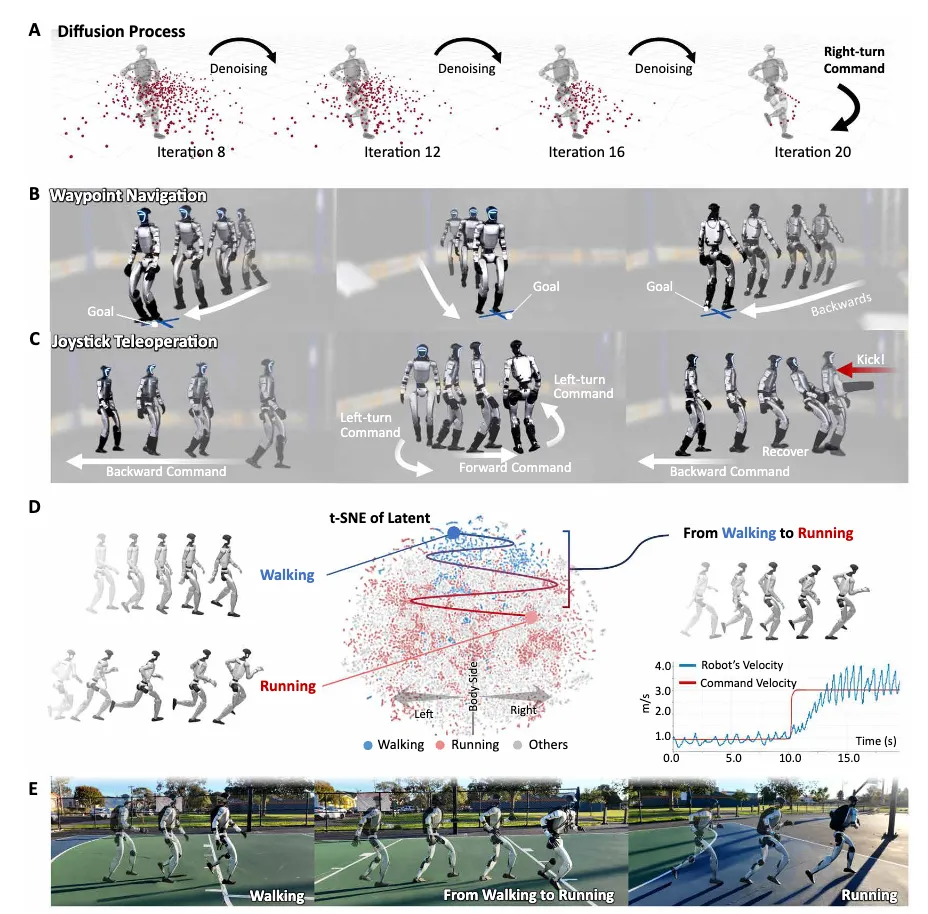
▲图 | 引导扩散完成命令条件运动示意图©【深蓝具身智能】编译
这里区分一下它和普通动作扩散的差异:
多数动作扩散只输出关节动作;本模型联合建模状态+动作,自带对未来身体演化的预判,天然适配预测控制闭环。
它不是先生成完整离线轨迹再交给跟踪器,去噪输出的当前步动作直接下发机器人硬件,滚动时域闭环运行。
三类零样本能力:无需重训直接解锁全新任务
-
命令条件运动(摇杆遥操作、航点导航):
接收速度指令或者目标航点,模型自主在行走、慢跑、奔跑之间做平滑步态切换,这些切换样本在训练数据中非常稀少,属于涌现行为。
真机实现50米以上长距离连续奔跑,外部受到推撞扰动后可以恢复任务目标。
-
运动补全(Motion Inpainting):
只给定稀疏未来关键帧,例如行走过程中插入一组侧手翻关键姿态,扩散模型自动生成中间平滑过渡轨迹;完成特技之后自动平滑切回正常行走。可以在速度指令模式、关键帧模式之间来回无缝切换。
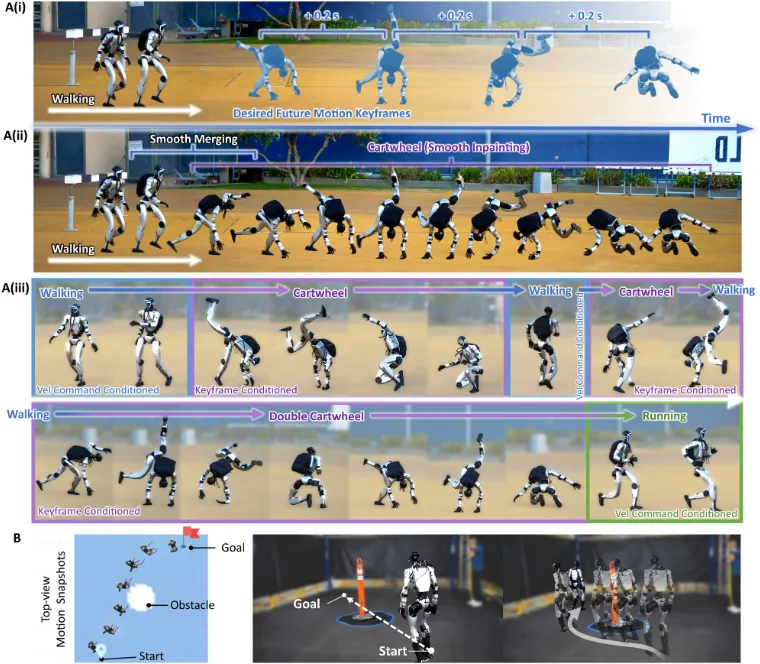
图 | 任务过渡与组合效果图©【深蓝具身智能】编译
-
任务代价组合(避障导航):
航点跟踪代价叠加障碍物SDF代价,机器人自主绕行障碍抵达目标,整套能力训练阶段从未见过障碍物样本。
实验
研究评测分为仿真消融、用户感知研究、真机硬件实验三部分.
-
运动自然度用户调研
77名受试者,对比Unitree机器人原生控制器,对行走、跑步片段做二选一投票。70.8%受试者认为BeyondMimic动作更加拟人;跑步场景优势尤其明显,84.7%偏好本方案。
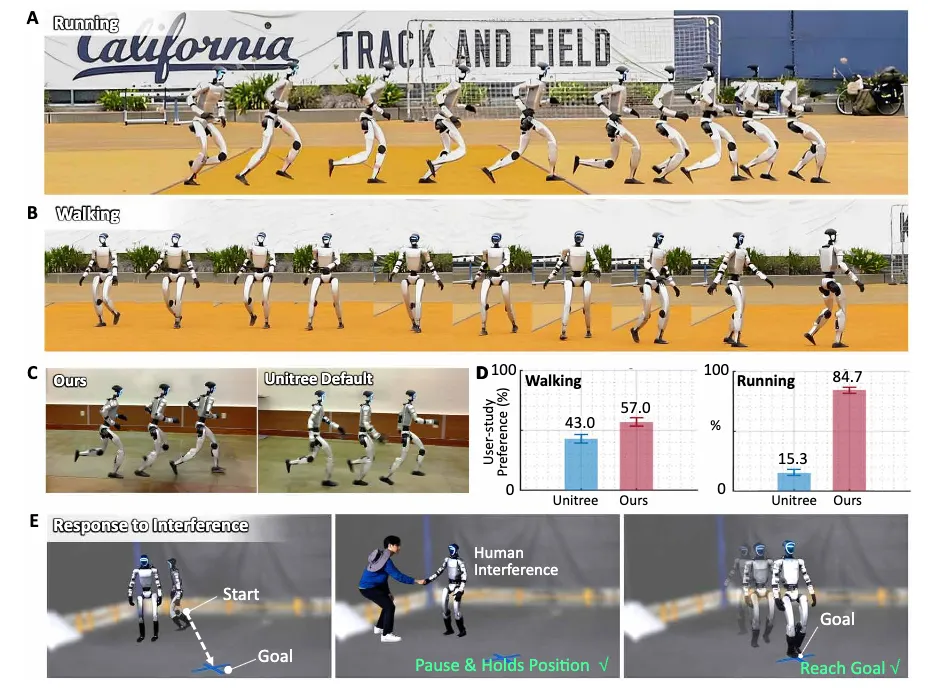
▲图 | 行走跑步拟人化对比与用户调研结果示意图©论文原图
-
高动态特技实机能力
室外非理想地面(泥土、落叶、不平地表)完成180°侧手翻、连续旋踢、360°翻转踢。腾空阶段骨盆角速度最高可达15.7rad/s,量级和人类运动员特技动作接近。同时完成多次连续C罗庆祝跳跃,早期基线大多只能单次执行。
-
下游任务定量表现
仿真下行走、奔跑的速度跟踪误差分别为12.14%、13.65%。真机完成遥操作、航点导航、障碍物规避、关键帧运动补全。
但引导式扩散存在固有局限:擅长粗粒度代价目标;精细动作控制效果有限;引导权重需要调试,权重设置不当会造成去噪过程不稳定;在动作模式切换的起始、结束位置机器人容易踉跄失稳。
消融实验也验证几个关键结论:
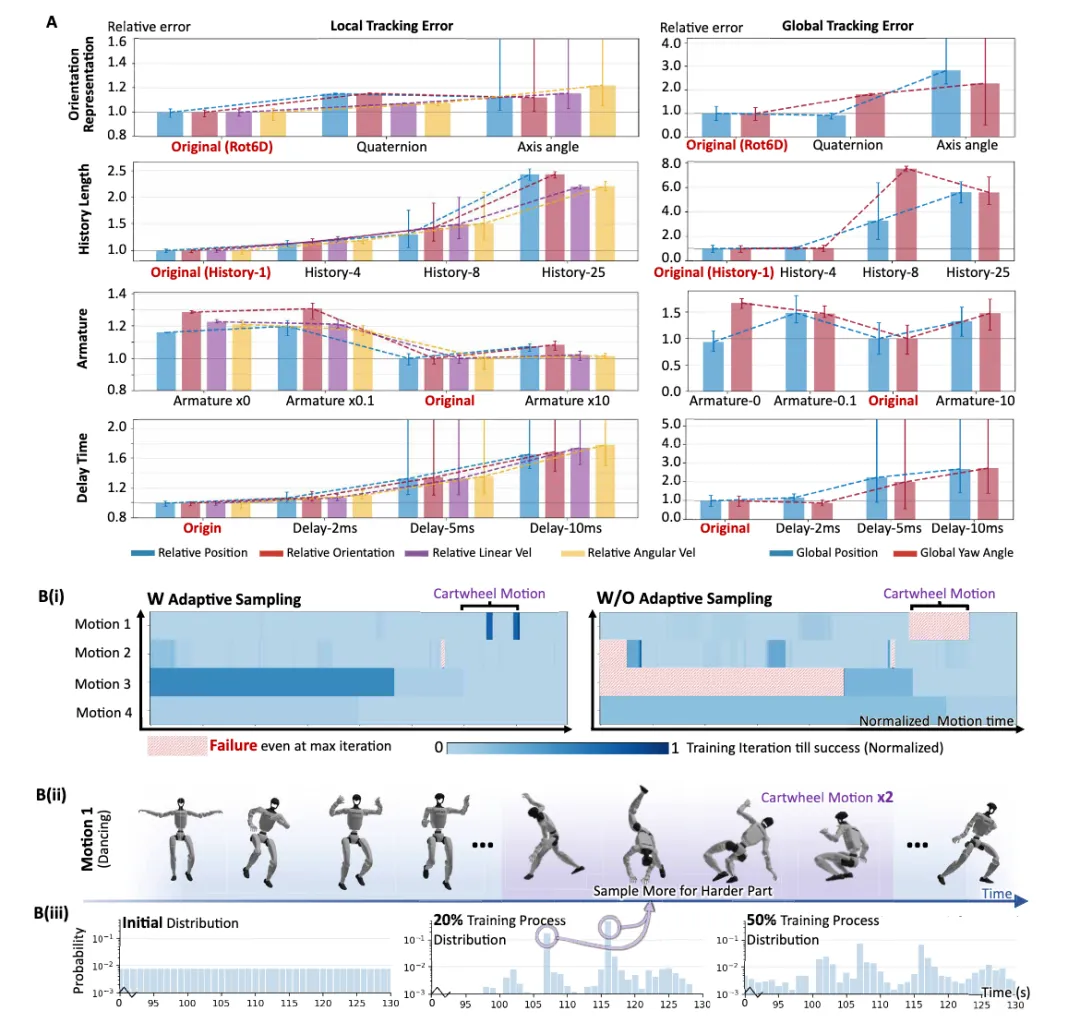
▲图 | 消融研究(方向表示、历史长度、armature、延迟)示意图©论文原图
-
采用Rot6D连续旋转表示,相比四元数、轴‑角表示,跟踪误差显著降低;
-
不恰当增大观测历史长度,反而损害sim‑to‑real迁移性能;
-
通信控制延迟对整套系统影响极大,5ms延迟就会出现失败,说明低延迟C++部署栈是这套方案真机跑通的重要前提。
落地收益与无法回避的现实短板
落地层面实际价值
-
技能规模化成本下降
不需要为每个特技动作重新设计奖励、调参,依靠同一套RL配方,扩展更多动捕片段就可以扩充机器人的技能库,对人形机器人技能库建设提供可行路径。
-
训练‑测试解耦范式
训练只学习运动先验,不需要预判未来会遇到什么任务。遇到新任务只需要设计可微代价函数,不需要重新训练网络。
-
规划‑控制一体化闭环
区别于“上层生成轨迹、下层跟踪”的解耦架构,规避规划器‑控制器不匹配的经典问题。
-
开源带来行业复用价值
该框架已经被MJLab、Unitree RL Lab纳入参考实现,多家硬件厂商在不同人形平台完成复现,证明该配方具备跨机型迁移能力。
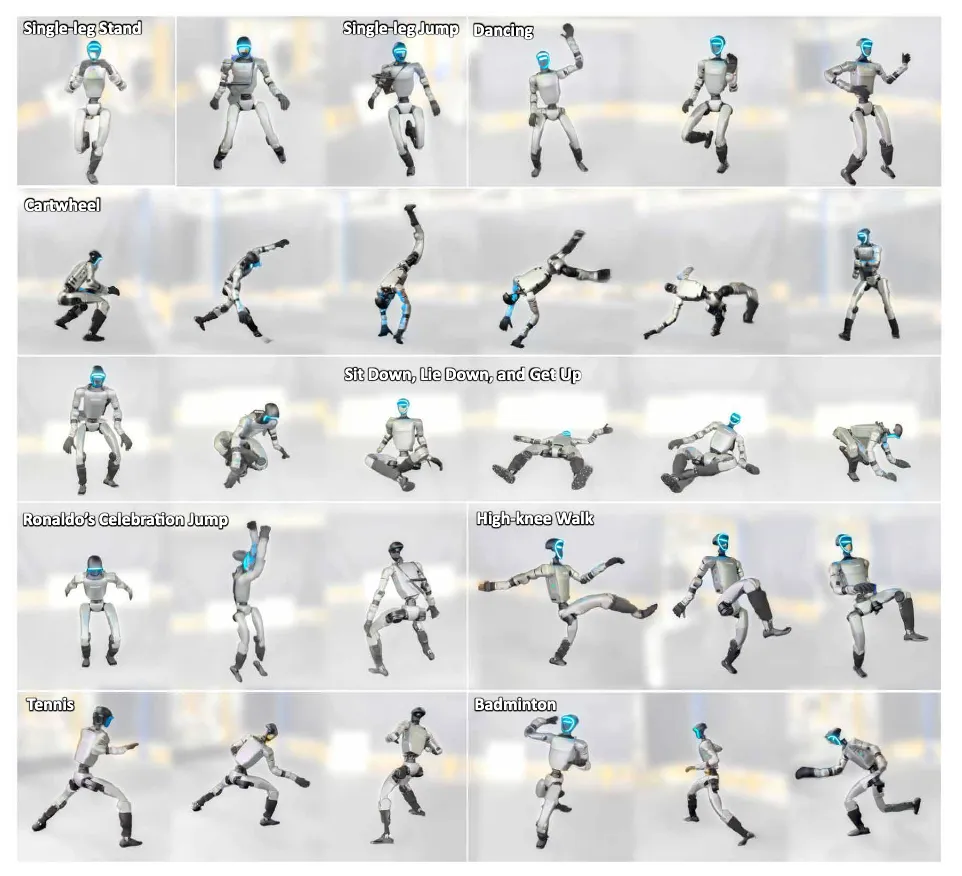
▲图 | 部署于人形真机的多样化运动跟踪策略效果展示©【深蓝具身智能】编译
不可忽视的局限
-
对历史状态存在依赖
模型依赖历史窗口信息,这会带来副作用:运动切换的开头和结尾瞬态阶段容易踉跄;增大引导权重可以改善任务性能,但又会破坏去噪稳定性。
-
引导权重需要人工调参
面向不同任务,需要调试引导权重,不能做到开箱即用的细粒度控制。
-
没有原生视觉输入
当前全部基于本体感知(IMU、关节状态),障碍物信息必须依靠外部代价函数输入,机器人本身不能通过相机看到障碍物,无法端到端基于视觉感知做避障。
-
依赖第一阶段RL教师质量
扩散模型的能力上限由RL教师策略决定;如果RL学不好某个动作,第二阶段扩散也无法凭空造出该技能。
-
预测视野有限
模型预测时域只有0.64s,适合局部反应式控制,不支持远距离长时序规划。
综合来看,BeyondMimic并没有彻底解决人形全身控制全部难题,瞬态切换不稳、引导调参、缺少视觉端到端感知都是待解决的问题。
但这套“先学技能、后拼任务”的范式,为人形机器人行为基础模型提供重要参考,把模仿学习的边界,从复刻片段推向任务泛化。
编辑|小小怪博士
审编|具身君
Ref
论文标题:BeyondMimic: From motion tracking to versatile humanoid control via guided diffusion
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
