

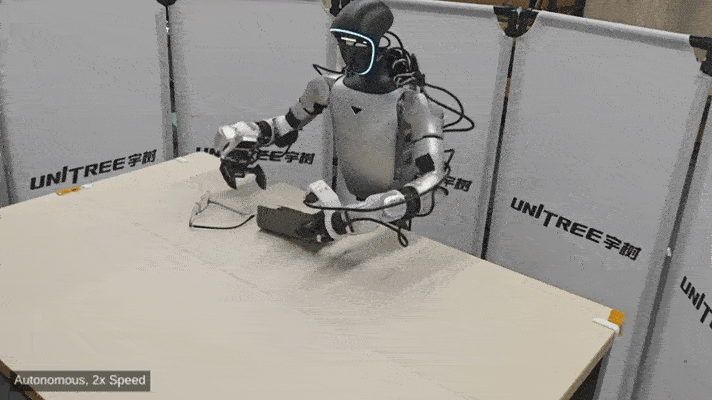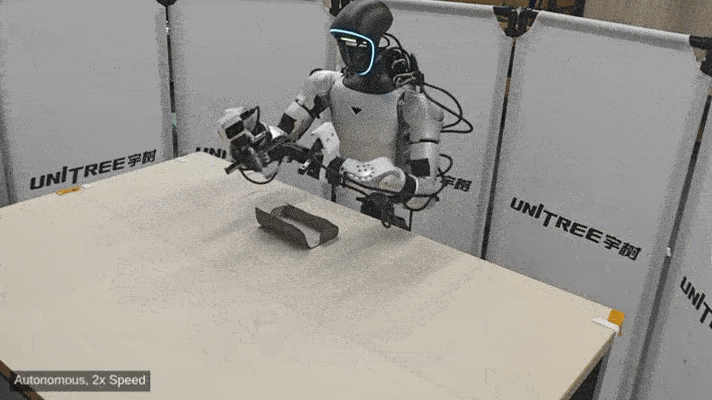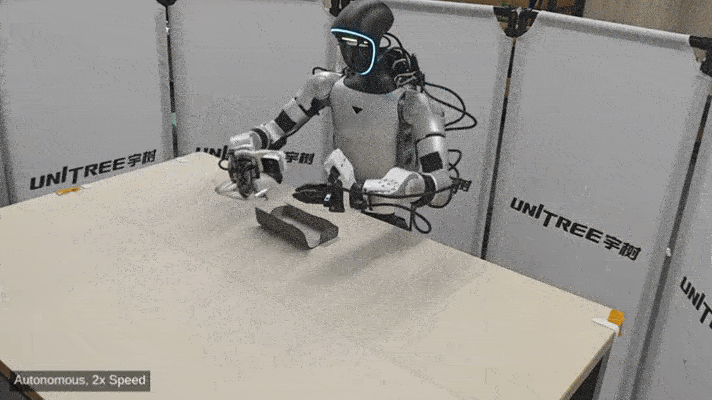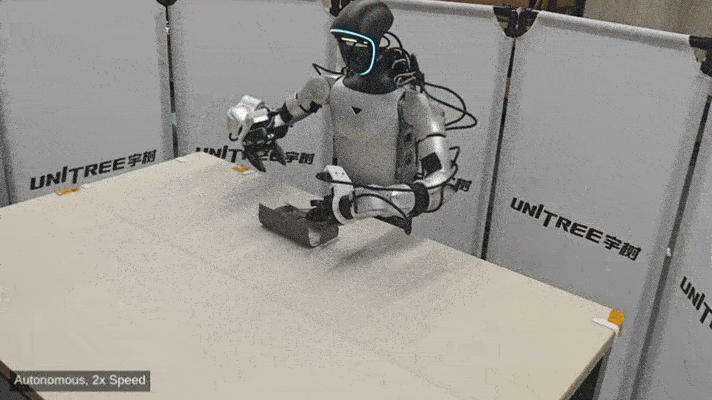
单模型统筹桌面与全身移动操作,支持跨任务、跨末端执行器泛化。
——一模驱动,全身协同。
9 月 10 日,宇树宣布新一代通用人形机器人基础模型 UnifoLM-WLA-1.0 全面升级开源:
-
6B 参数量;
-
5M+ 具身推理(ER)训练样本;
-
约 2,500 小时 高质量真机数据;
-
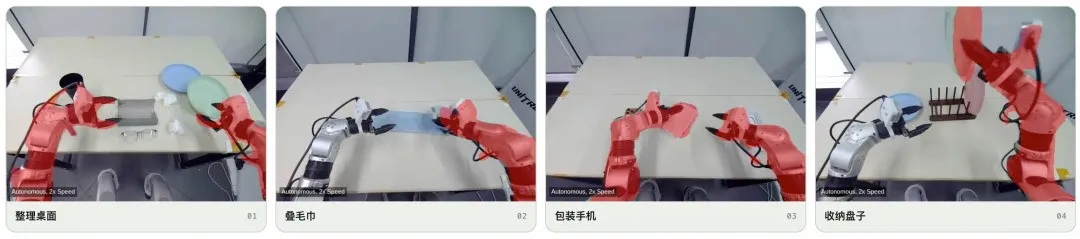
64 项 真机任务(54 项桌面操作 + 10 项全身移动操作);
-
同时支持平行夹爪与两种五指灵巧手。
新一代的通用人形机器人基础模型
UnifoLM 不是第一次出现。把三代模型按时间排开,你会发现宇树的路线变化,全写在名字里。
-
2025 年 9 月,UnifoLM-WMA-0(World-Model-Action)。
宇树把训练代码、推理代码、模型权重、部署代码一并放进了公开仓库。它的世界模型有两条工作流:
当交互式仿真引擎用,为机器人学习造合成数据;或接上动作头做策略增强,靠预测未来交互过程优化决策。核心词是"世界"。
-
2026 年 1 月,UnifoLM-VLA-0(Vision-Language-Action)。
基于 Qwen2.5-VL-7B 做持续预训练,只用约 340 小时真机数据做离散动作预测训练,配合动作分块与正/逆向动力学约束。
在 G1 上用单一策略完成 12 类复杂操作任务,LIBERO 仿真基准平均 98.7。核心词是"动作"。
-
2026 年 9 月,UnifoLM-WLA-1.0。
模型关系是明确的:在 VLA 的视觉-语言-动作表征之上,加入交互变化预测,再由动作专家产出连续控制量。
核心词是"统一"。
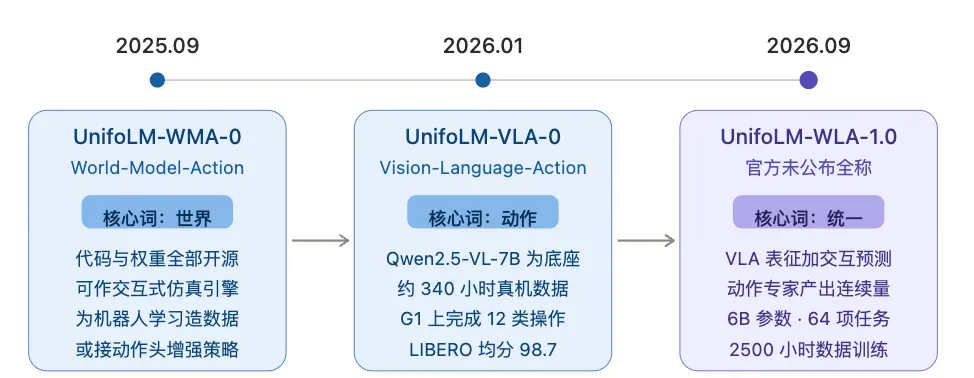
▲图| UnifoLM 系列三代模型演进时间轴©【深蓝具身智能】编译
从 340 小时到 2,500 小时,从 12 项任务到 64 项任务,从单一 VLA 到"具身推理 + 变化预测 + 动作生成"三层合一。
这条线的方向很清楚:不再为每类任务单独训一套策略。
-
全身移动操作 · 购买蔬菜
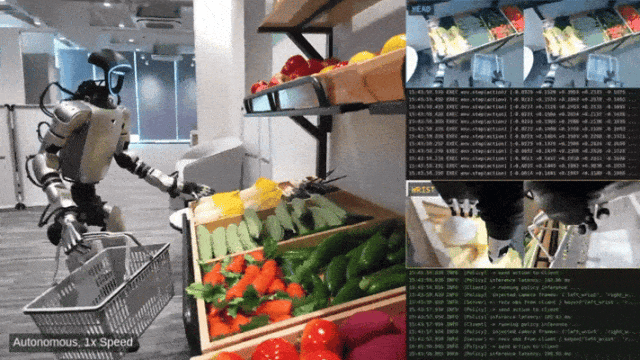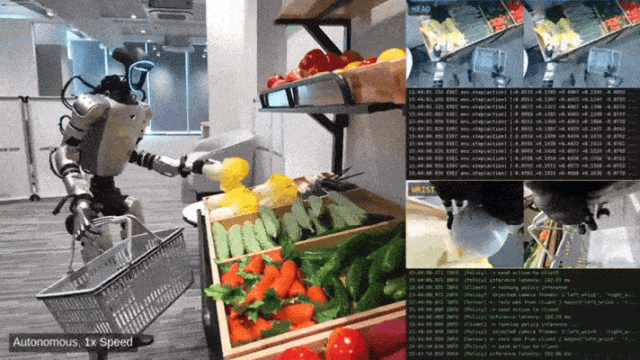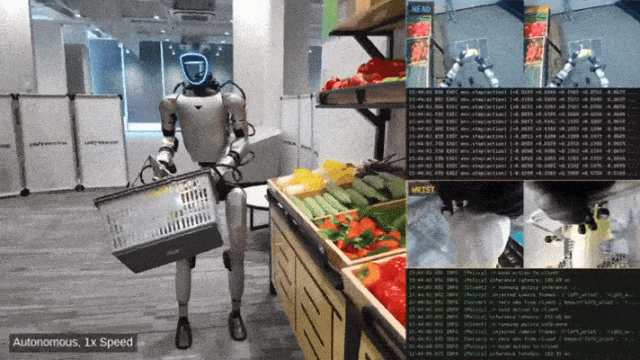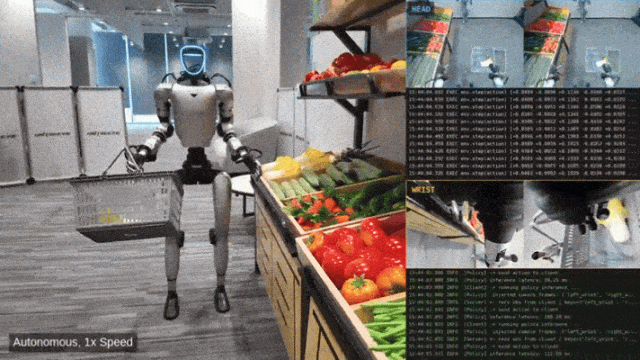
-
桌面操作 · 取棒棒糖
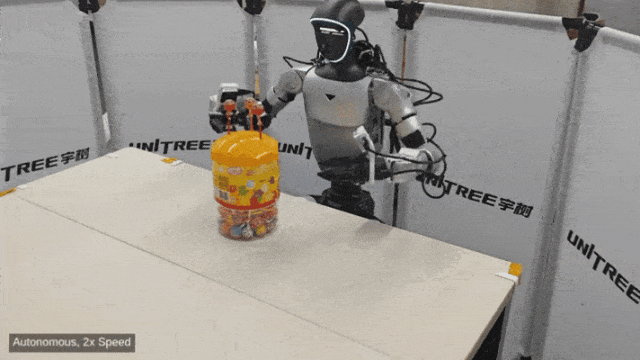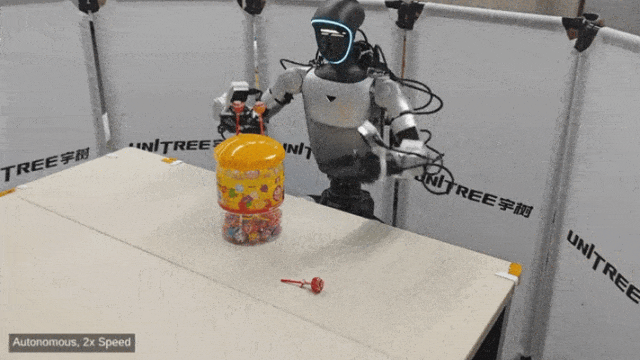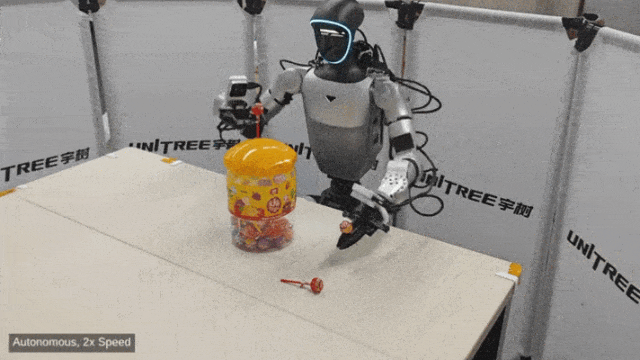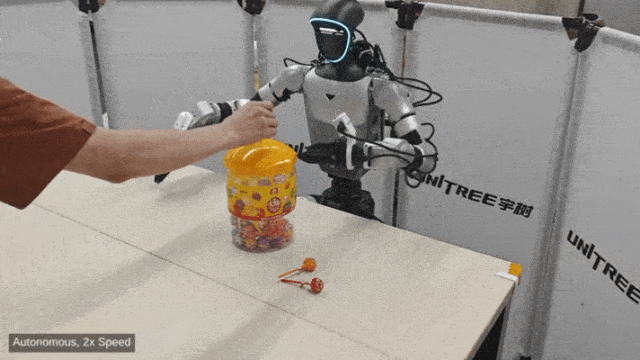
-
桌面操作 · 开锁
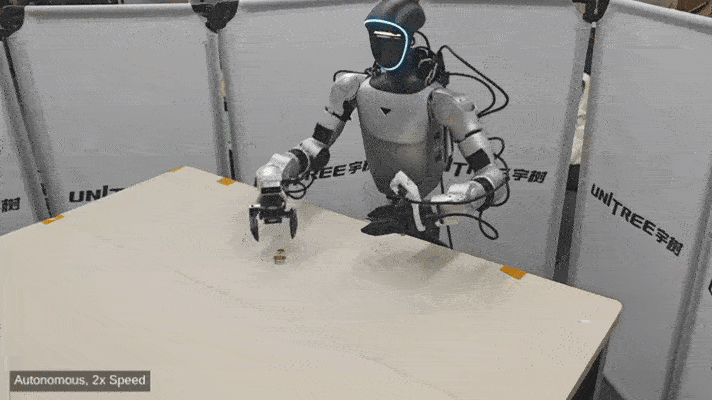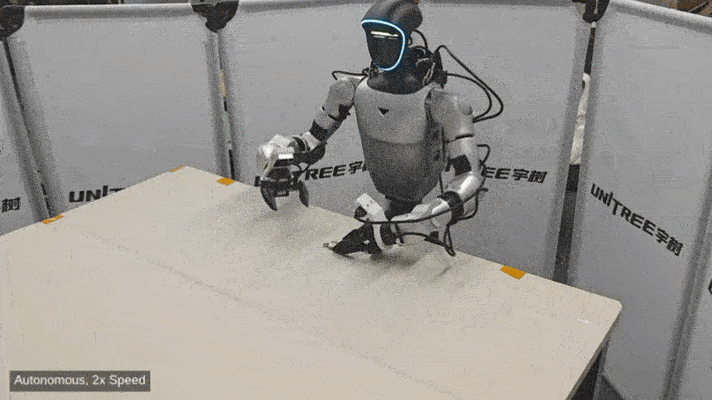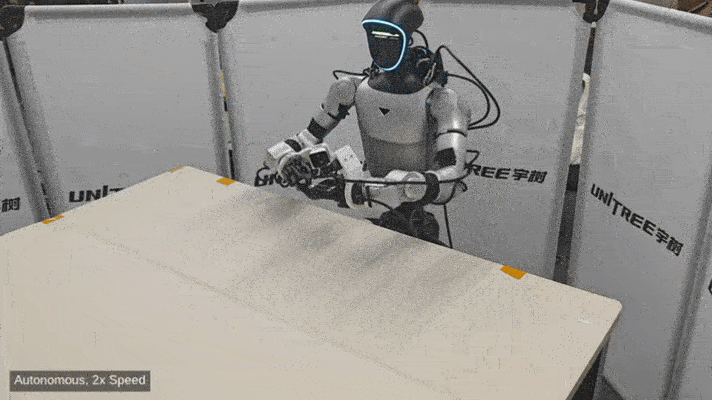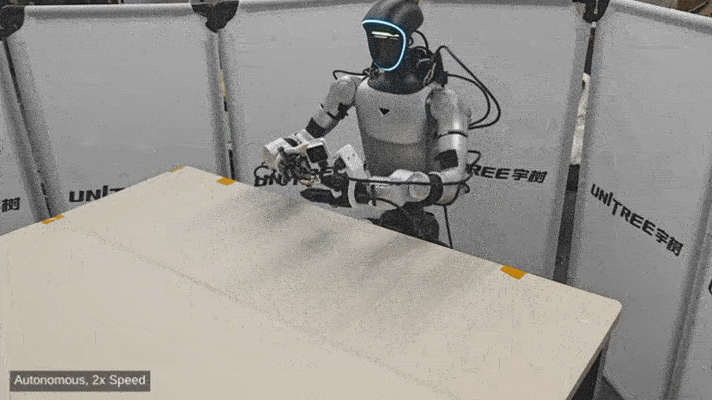
真正的难点不是"看见",是"知道动手之后会变成什么样"
WLA-1.0 最值得拆的,是它把"从看见到动手"切成的三层。
第一层:具身推理,把 VLM 教会"东西在哪儿"
这一层叫 UnifoLM-ER-1,4B 规模,底座是 Qwen3-VL-4B。
训练用了 超过 500 万条具身推理样本,覆盖六类任务:图像点预测、物体检测、多图推理、2D 轨迹预测、3D 物体检测、多图空间问答。
这批数据与通用图文数据联合训练,它保证了模型在补空间能力的同时,不会把原本的通用视觉语言能力练丢。
它要回答的,不是"桌上有个盘子",而是"盘子在哪、手该从哪个方向接近、第一视角和腕部视角之间是什么空间关系"。
第二层:动态区域预测——只预测会变的那一块
一提到世界模型,最直觉也最烧钱的做法是:生成整个未来画面。宇树没这么干,它的流程是:
用光流从前后两帧中,提取出真正发生变化的区域(dynamic region);
用 VQ-VAE 把这片连续变化压缩成固定长度的离散 token;
训练 VLM:输入当前图像 + 任务描述(或动作),直接输出未来动态区域的 mask token。
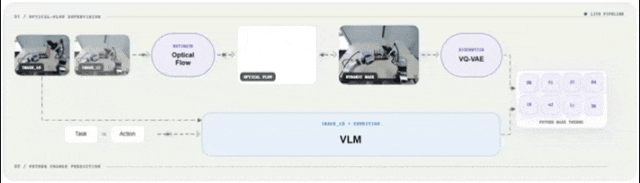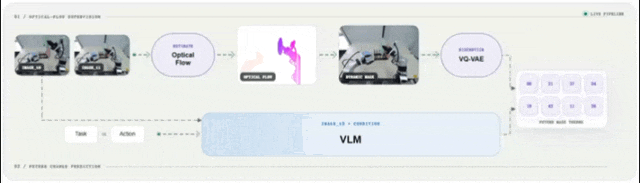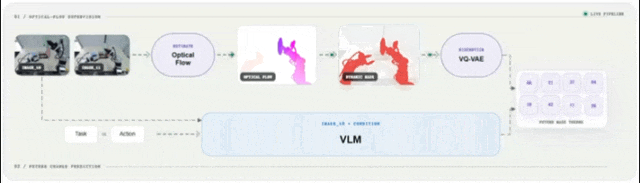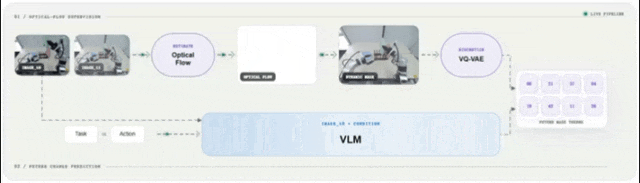
▲图| 动态区域预测:从光流到未来变化 Token©【深蓝具身智能】编译
拿叠毛巾举例:真正会变的,只有毛巾本身和它被挪走后露出的那块桌面。房间里其余的像素纹丝不动。
把宝贵的建模容量和算力全押在这一小片区域上,就是官方所说的 interaction-centric world modeling(以交互为中心的世界建模)。
与其画一张模糊的全景未来,不如把"哪儿会变"预测准。前者好看,后者有用。
第三层:把动作切成 Token,让手、臂、腿讲同一种语言
有了认知,还得让动作能被统一表达。宇树把统一动作空间分为了三段:
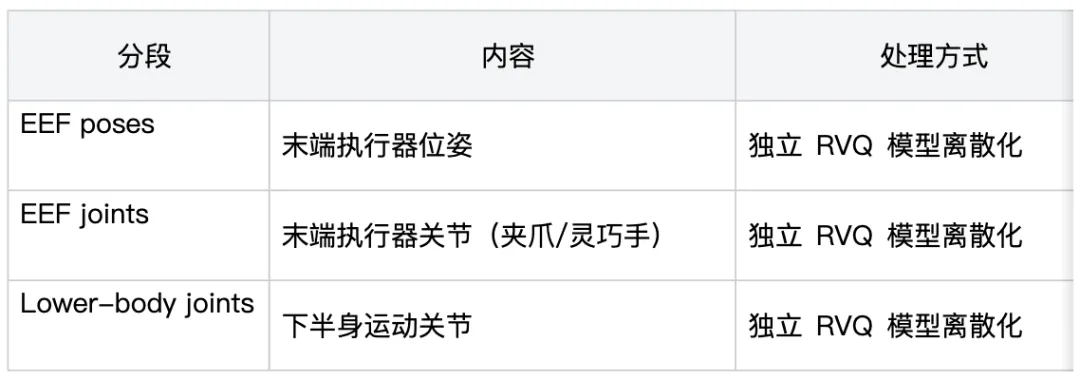
每段各训一个残差向量量化(RVQ)模型,把连续轨迹编码成离散动作 token。
三段 token 按共享时间步对齐后,同步喂进 VLM。
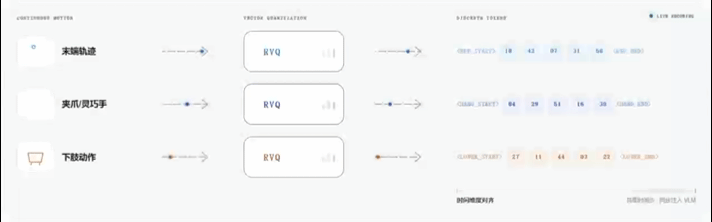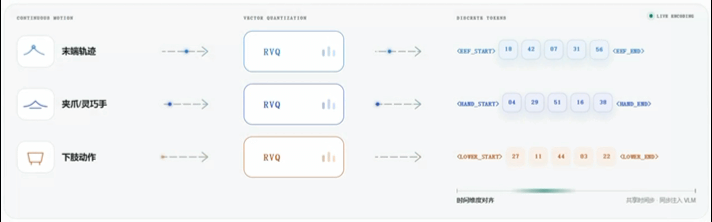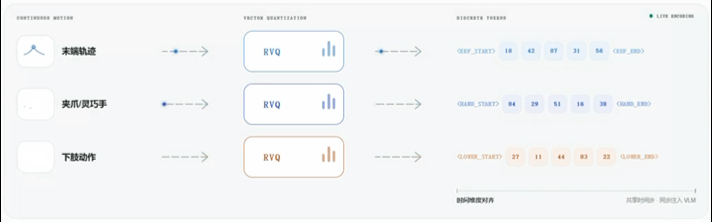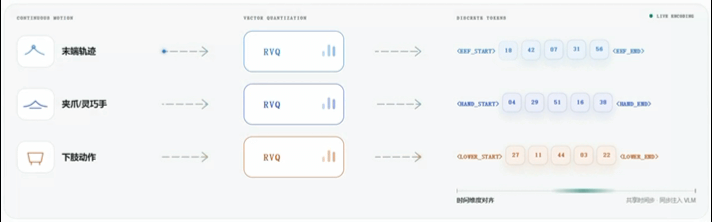
▲图| 统一动作空间:三段 RVQ 离散化与时间步对齐©【深蓝具身智能】编译
桌面抓取、双臂协作、行走后再操作,不仅场景不同,动作维度和控制对象也完全不同。
只有把它们压成同一种离散序列,模型才可能自动学到手、臂、下肢之间的协同关系。所谓"一模驱动、全身协同",工程前提就在这里。
三层合起来,得到 UnifoLM-ER-Flow:视觉、语言、未来区域 mask、离散动作 token,在同一个 VLM 里完成对齐。
6B 的身体里,装了哪些配料
一个动作专家,负责"动得顺"
WLA-1.0 的结构可以一句话说完:UnifoLM-ER-Flow 多模态主干 + MMDiT 动作专家(flow decoder)。
动作专家接收图像编码、任务 prompt、机器人 state 和带噪动作,输出连续控制量。
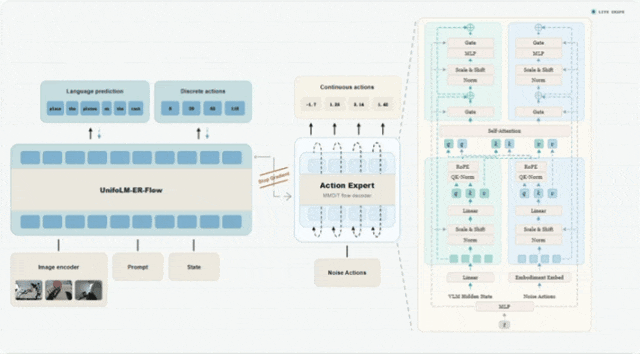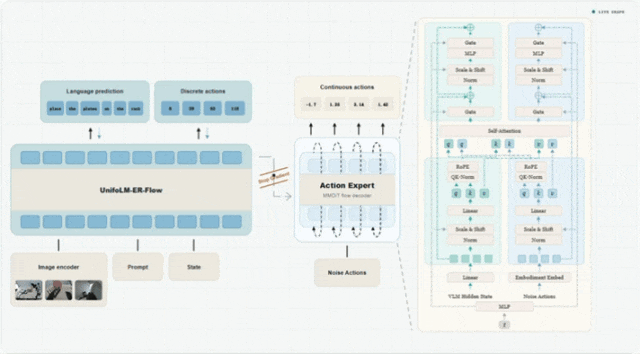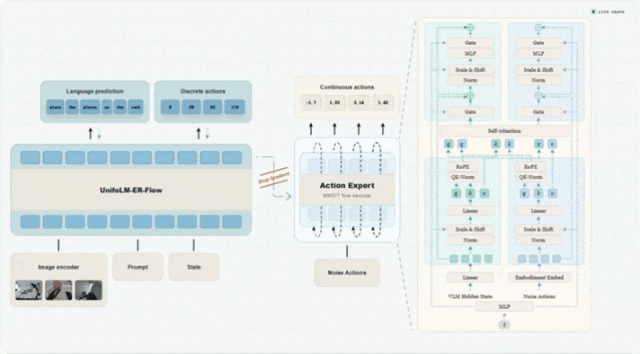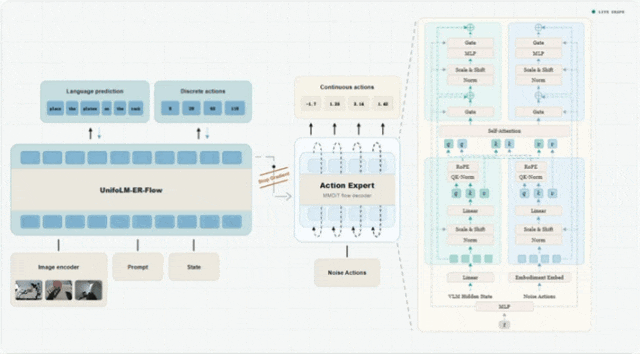
▲图| 模型架构©【深蓝具身智能】编译
这也是当下 VL“A 的通行做法——π0、GR00T N1.7 都在做同样的拆分:
负责"想什么"的部分和负责"怎么动得顺"的部分,本就该用不同的机器。
2,500 小时数据,从哪来
官方点名了两类来源:Unitree Open Datasets 与 BitRobot-HIW-500 等公开资源。
-
HIW-500 值得单独说一句。
它由 BitRobot 联合 Hugging Face 与宇树在 2026 年 6 月发布:500+ 小时全身遥操作数据,23,000+ 任务片段,12 个真实家庭,原始体量约 10TB(LeRobot 格式压缩至 2TB),29 自由度,配头戴立体 RGB 相机与腕部红外立体相机,部分连续片段时长超过 8 分钟,采用 CC BY 4.0 协议。
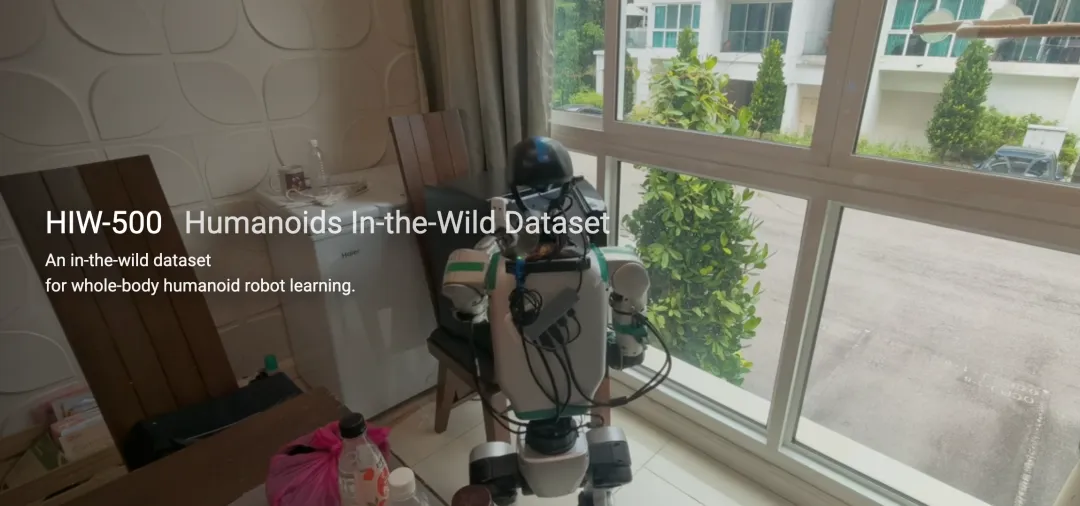
▲图| BitRobot-HIW-500数据集©【深蓝具身智能】编译
64 项任务,看点不是数量,是"跨"
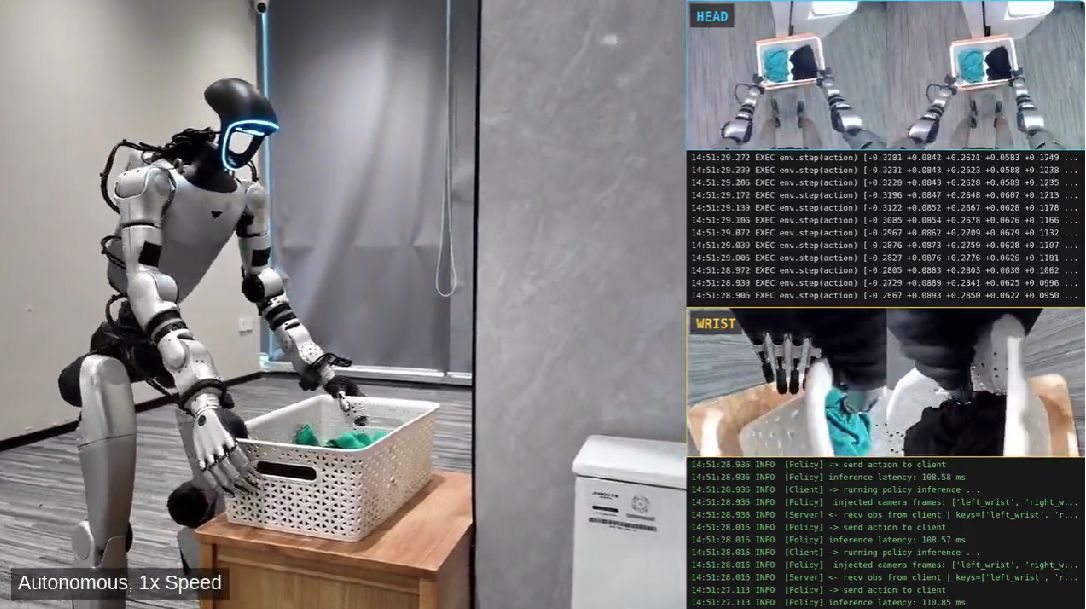
54 项桌面操作 + 10 项全身移动操作,覆盖倒垃圾、厨卫收纳、铺床这类大空间连续任务,也覆盖叠毛巾、器件插拔、工具分类这类精细操作。
但真正的信号在官方那句"跨任务、跨末端执行器的能力泛化"。
同一套权重,同时支持平行夹爪和两种五指灵巧手。这意味着模型没有过拟合到某一种硬件形态上,具备跨本体迁移的先验。
拿 4B 的小模型,去和顶级闭源模型比空间理解
具身推理那层,宇树单独交了答卷。
在官方公布的 16 项多模态感知与理解基准中,UnifoLM-ER-1-4B 在 7 项上取得参评开源模型的最高成绩,整体表现可比肩头部闭源模型。
几个被反复引用的对比:
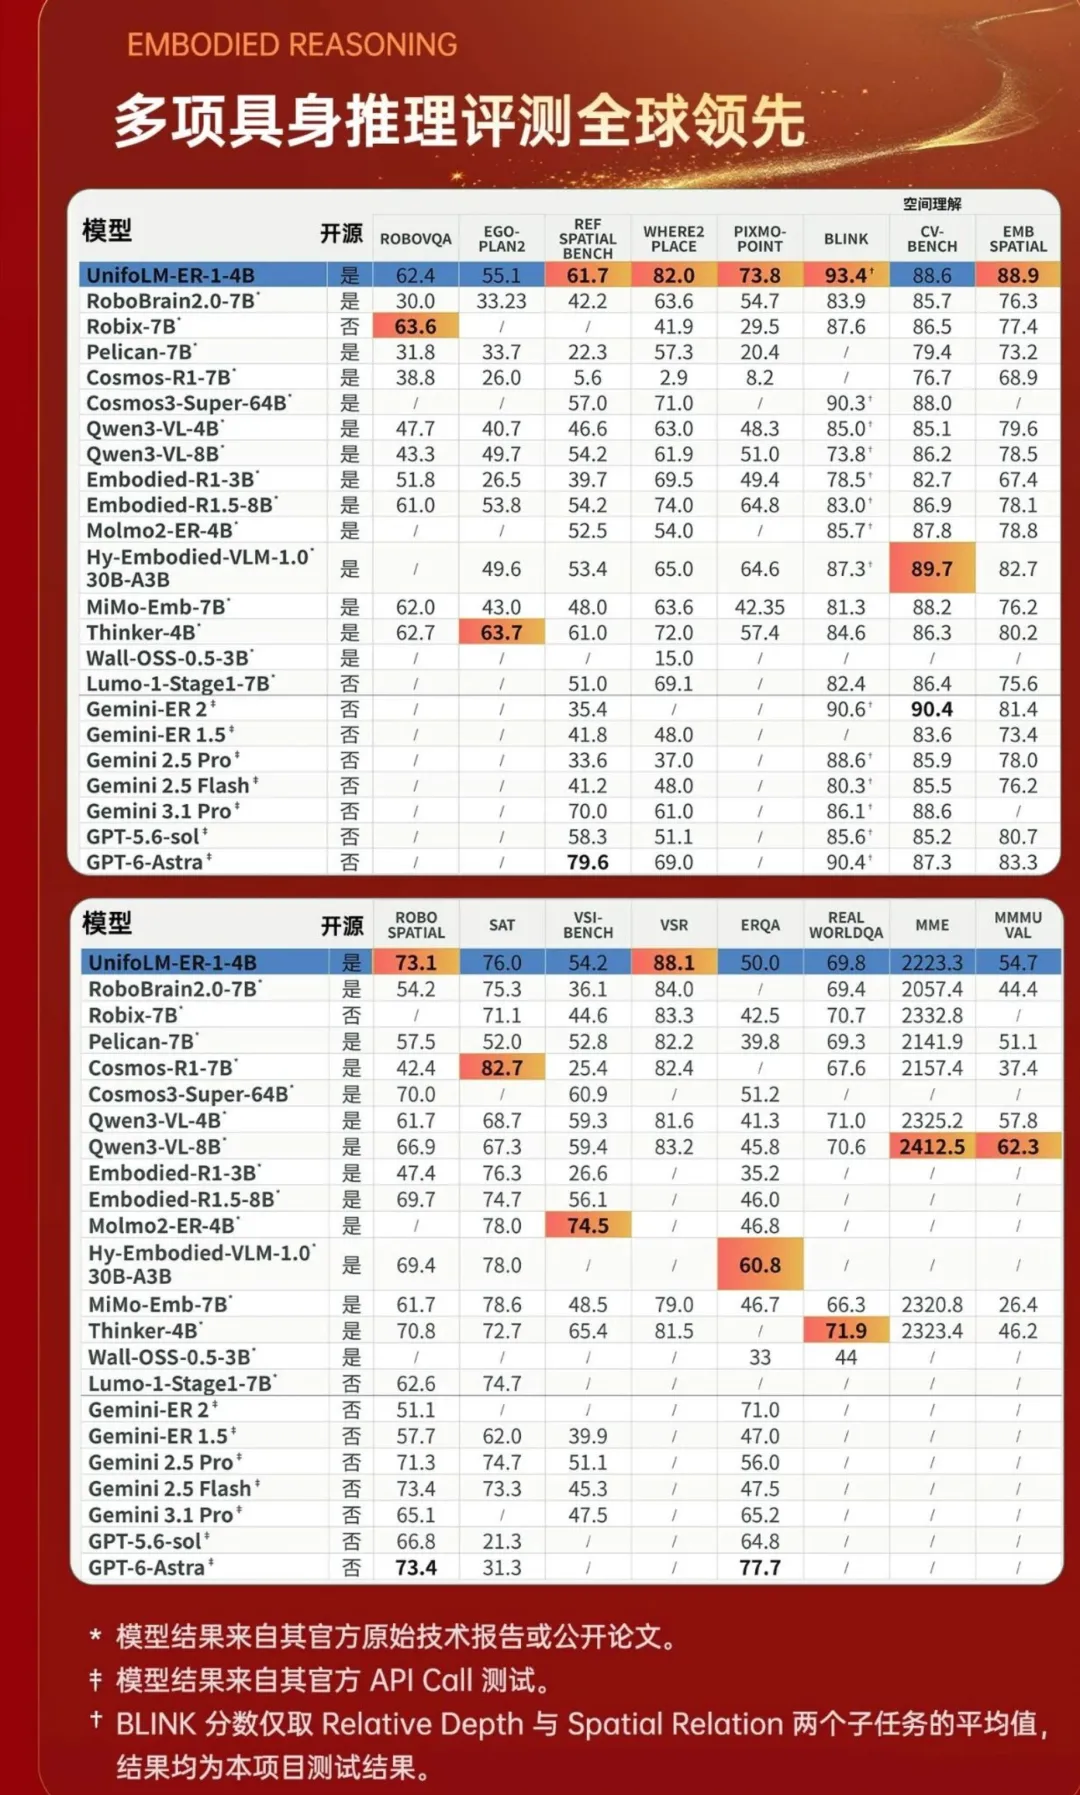
▲图| 具身推理基准部分成绩对比©【深蓝具身智能】编译
一个 40 亿参数的开源模型,在空间理解这类任务上摸到了顶级闭源模型的边,这不是小事。
这张表混合了各家官方技术报告、公开论文,以及项目方通过官方 API 自测的结果;BLINK 也只统计了 Relative Depth 与 Spatial Relation 两个子任务。它能说明的,是"宇树采用了较广的评测口径且空间能力确实强",不能当成统一条件下的独立排行榜。
UnifoLM-WLA-1.0 没有去生成一个昂贵而模糊的完整未来,而是只盯住动作会改变的那块区域:
在算力有限、数据有限、时间有限的现实里,把好钢用在会变的那一小片像素上。
编辑|小小怪博士
审编|具身君
参考资料:
1. UnifoLM-WLA-1.0
官方项目页:https://unigen-x.github.io/unifolm-wla.github.io/
2. 宇树开源数据集:https://huggingface.co/unitreerobotics/datasets
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
