

阿里 Qwen 团队联合华中科技大学开源了 Qwen-Drive-1.0,首个面向自动驾驶的视觉语言基础模型。
它最反常规的一点:完全不动预训练 VLM 的架构,把 3D 感知、驾驶问答、运动规划三件事装进了同一个模型——座舱和驾驶,不再需要两套大模型。
自动驾驶过去的老规矩是三件套分家:3D 感知一个模型、场景问答一个模型、运动规划又一个模型。问题有两层:
-
成本层:多模型并行部署,算力冗余、集成维护成本高。而现在车企的趋势恰恰是座舱-驾驶共板——一个算力平台跑所有功能,预算更紧了。
-
能力层:直接拿驾驶数据微调通用 VLM 有结构性缺陷。论文说得很直白:文本问答的监督信号并不直接约束 3D 布局、深度和占用——模型可以说出一段流畅的场景描述,但三维几何是糊的。而大规模领域微调又会带来灾难性遗忘,可真实道路上恰恰是罕见场景在考验预训练攒下的世界知识。
所以 Qwen-Drive-1.0 的答案是:保留预训练底座,外挂轻量模块,一个实例同时服务两个域。底座是 Qwen3.5-4B,外部仅挂接两个轻量模块:BEV 感知头和规划专家(Planning Expert)。
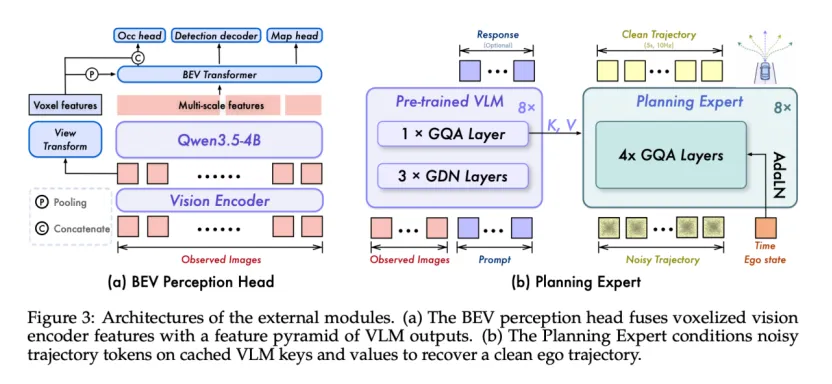
图| 外部挂接的BEV头和规划专家 ©【深蓝 AI】编译
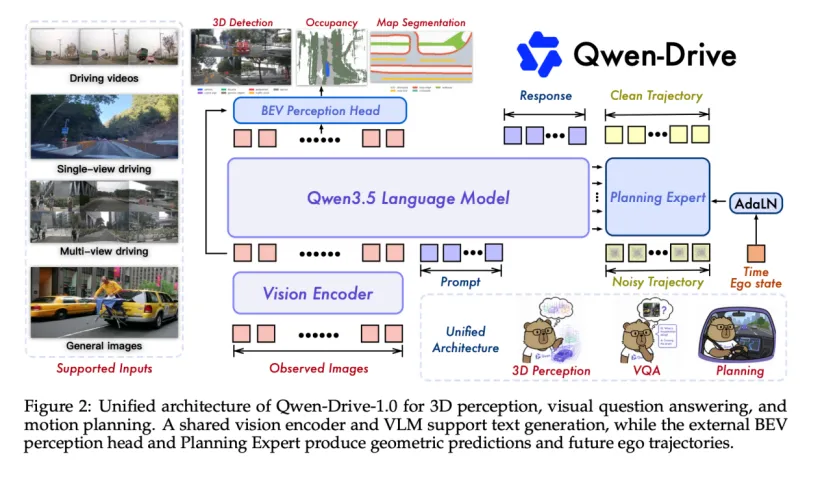
输入:对齐车载硬件,不加特殊 token
输入就是主流车载硬件的常规输出:驾驶视频、单视图/多视图环绕图像、通用图像,单帧、时序多帧都能接。
多视角输入通过视图标签标识八个预置方向:<FRONT VIEW>、到<FRONT LEFT VIEW>。帧标签 frame增加了k 标记时间步。关键在于这两类标签全部用普通词表 token 实现,不需要任何特殊 token 或架构改动——这对保持和原生 Qwen 生态兼容很重要。
两个细节设计:
-
序列化分任务:问答任务按"帧优先"排(同一时刻的所有视角挨着,利于跨视角综合);规划任务按"视角优先"排(同一视角的连续时间帧挨着,突出单视角内的时序变化,这对动态环境的控制更重要)。
-
分辨率分历史:规划输入是前视+左前+右前三个视角,各含当前帧和 3 个历史帧(间隔 0.5 秒)。历史帧压到 320p 省视觉 token,当前帧保留 720p 细节——用最少的 token 记住"刚才发生了什么",用最高清的画面看清"现在"。
输出:三条出口,互不干扰
BEV 感知头从共享路径取两路特征(视觉编码器的低层外观特征 + 走完整个 VLM 的图像 token 特征),经类 LSS 的深度视图变换抬到 3D 体素,再用 query-based BEV Transformer 聚合,输出三路结果:
3D 检测(DETR 式解码器)、语义占用(3D UNet)、地图分割(UNet 式头)。标签体系跨数据集统一为检测 7 类、占用 10 类、地图 6 类。
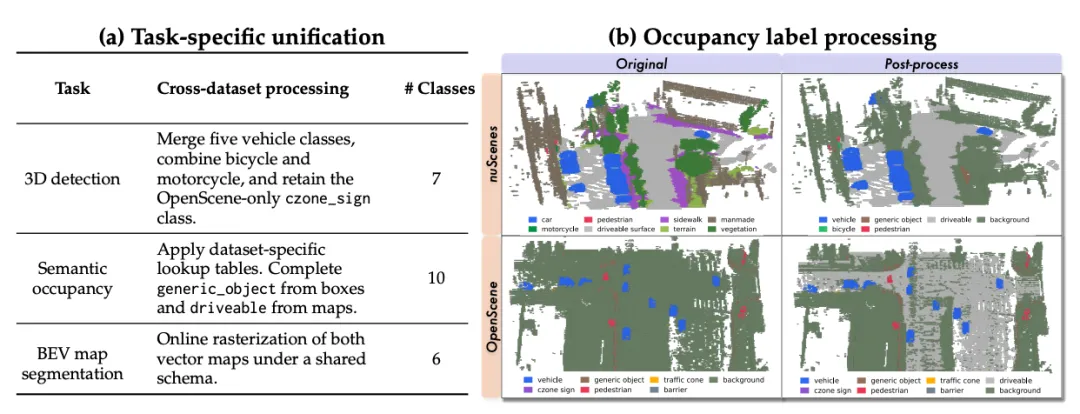
图| 跨数据集的感知标签统一 ©【深蓝 AI】编译
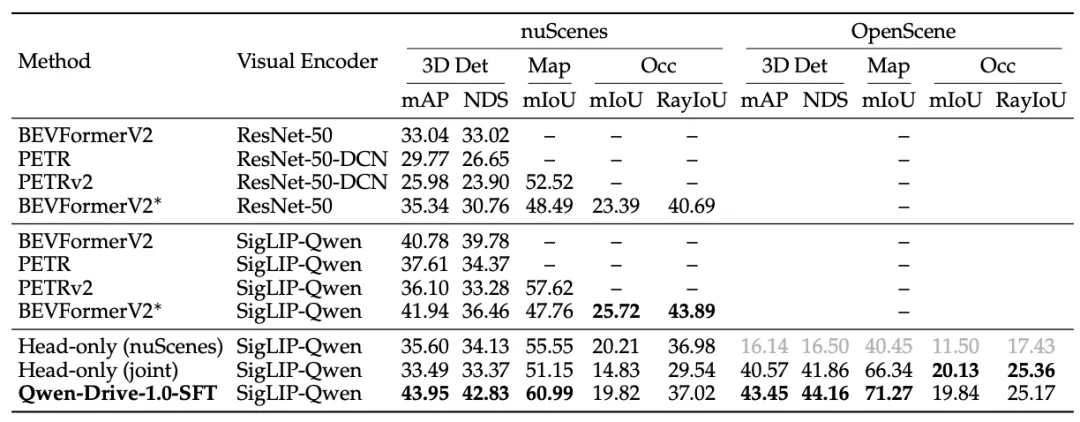
表 | nuScenes 与 OpenScene 验证集上的统一 3D 感知结果 ©【深蓝 AI】编译
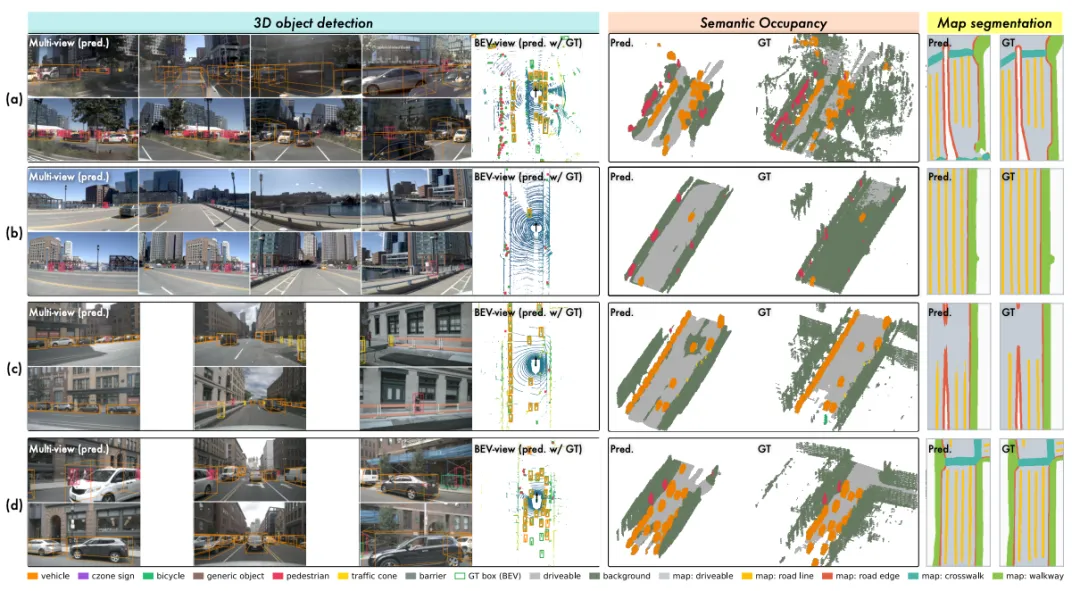
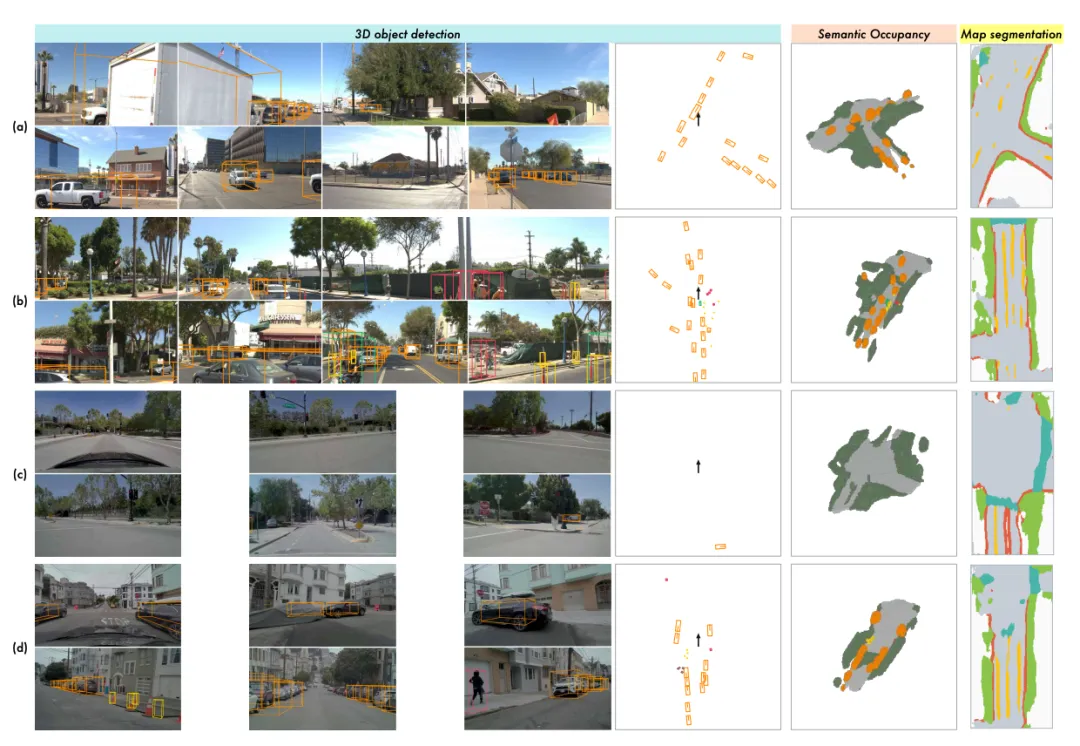
图| OpenScene 与 nuScenes 验证集上的 3D 感知可视化 ©【深蓝 AI】编译
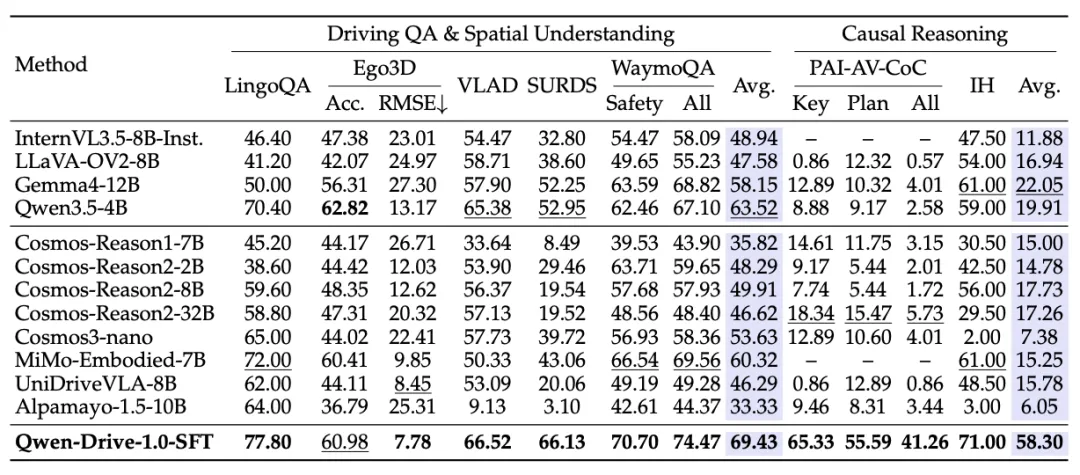
表 | 驾驶问答与因果推理结果(数值越高越好,Ego3D RMSE 除外)©【深蓝 AI】编译
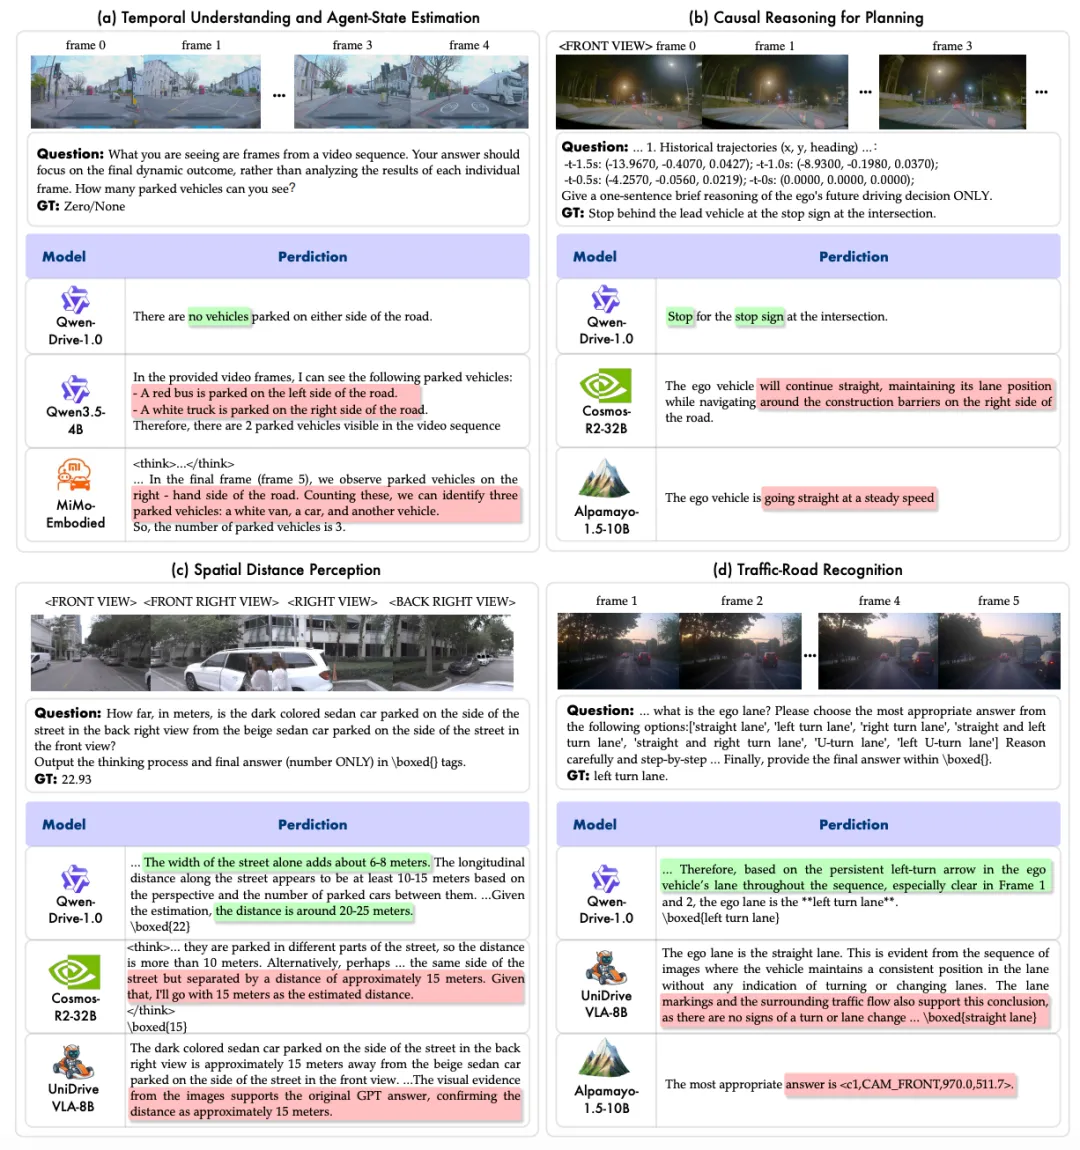
图 | 驾驶问答能力定性对比(绿=答对,红=答错)©【深蓝 AI】编译
-
开环 WOD-E2E 测试集 RFS 7.91,超过强化版 MindVLA-U1 的 7.87; -
伪闭环 NAVSIM PDMS 90.7,best-of-6 选优达 91.4; -
闭环 AlpaSim,强化学习把离路率从 24.0% 砍到 12.0%,代价是自车进度从 54.0% 降到 48.0%——开得更稳,也更保守,论文对此有明确讨论。
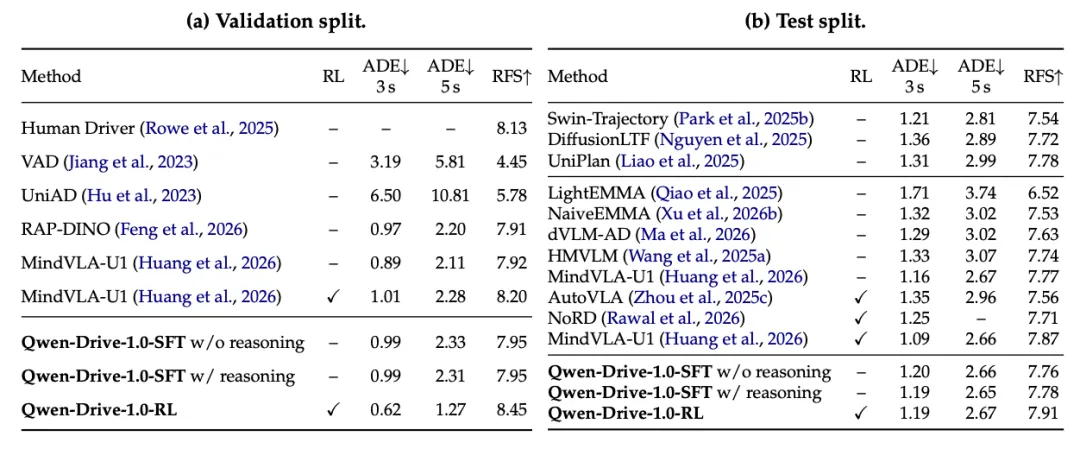
表 | WOD-E2E 测试集开环规划结果(RL 模型在测试集才反映真实泛化)©【深蓝 AI】编译
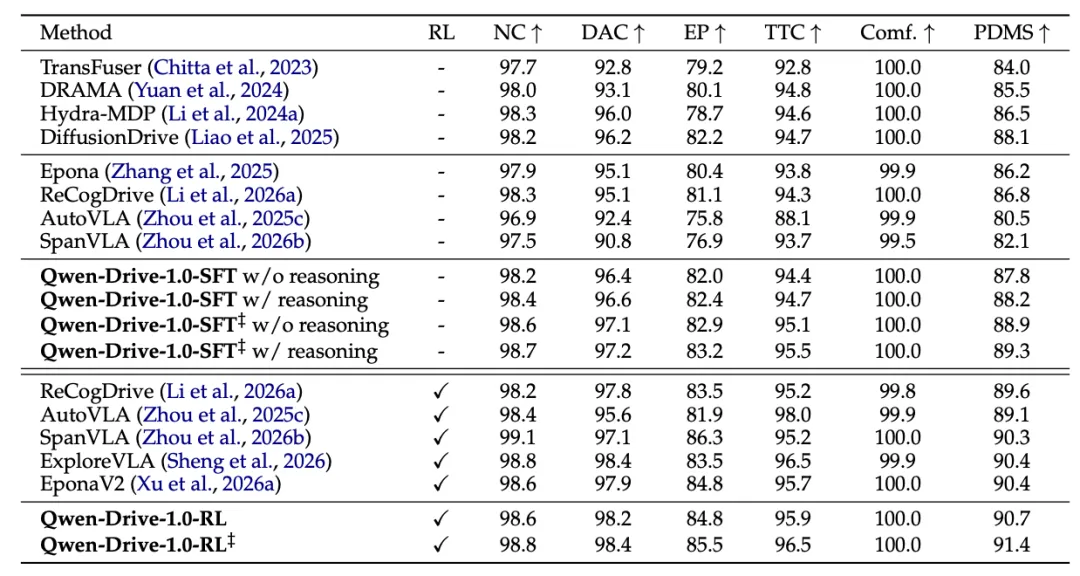
表 | NAVSIM v1.1 navtest 伪闭环规划结果(PDMS 越高越好)©【深蓝 AI】编译
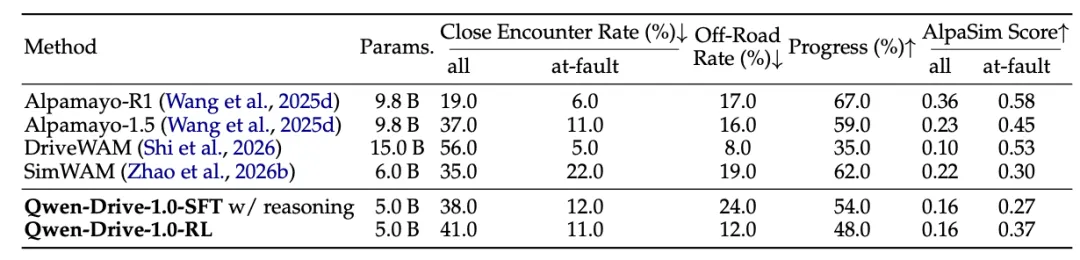
表 | 基于 916 个 AlpaSim 场景的闭环规划结果 ©【深蓝 AI】编译
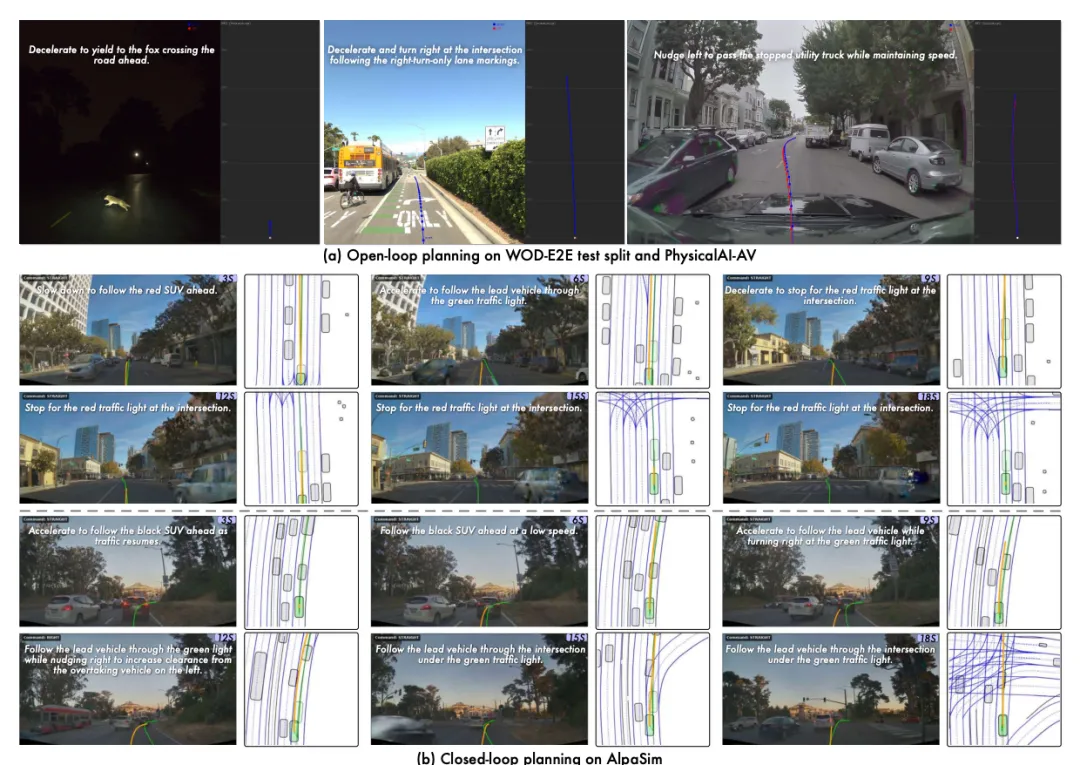
图 | Figure 9:运动规划定性结果(开环 + 闭环)©【深蓝 AI】编译
调度:输入配置驱动,不换权重
三类任务共享同一套 VLM 权重,BEV 头和规划专家常驻。
感知任务送多视图+相机标定,问答送 prompt+图像,规划送三视角时序图像+历史轨迹+导航指令。切换任务不需要加载额外权重,也不需要维护模型副本。
任务区分靠三层:序列化格式(帧优先/视角优先)、标签体系(视图+帧标签标定每个 token 的方位和时间)、训练目标(感知走 L_perc、问答走下一 token 预测、规划走流匹配,共享表示但梯度路径不同)。
训练配方上,Stage 2 的 minibatch 混合感知与视觉语言样本(非激活分支喂 dummy 输入保持计算图一致),Stage 3/4 冻结共享路径只训规划专家——这套安排让三个任务互不打架。
另外,BEV 头不依赖 rig 专属相机嵌入,所以同一个模型直接适配 6 相机(nuScenes)和 8 相机(OpenScene)两种配置,甚至能跑训练没见过的相机 rig(论文用 WOD-E2E 和 PAI-AV 的环绕视图做了定性验证)。对不同车型的传感器布局,这是个实打实的落地优势。
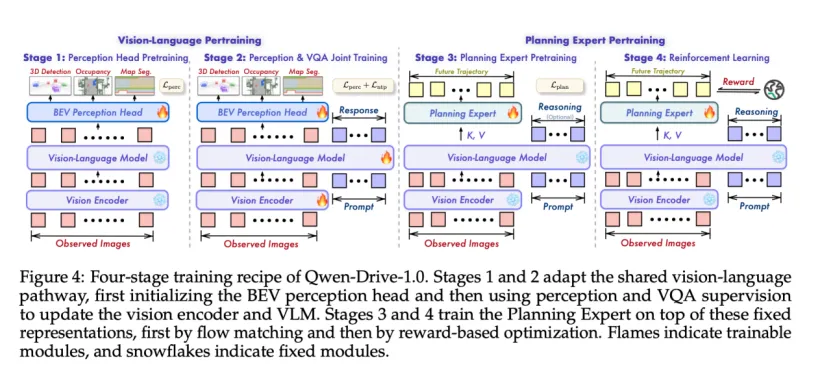
图| Qwen-Drive-1.0 四阶段训练配方图。©【深蓝 AI】编译
从下到上是数据流向:观测图像(Observed Images)→ 视觉编码器(Vision Encoder)→ 视觉-语言模型(Vision-Language Model)→ 外部模块(BEV 感知头 / Planning Expert)。
🔥 火焰表示该模块在本阶段可训练;❄️ 雪花代表该模块在本阶段冻结。
橙色方块 = 视觉 token;紫色方块 = 文本 token。
整张图左右两半各解决一个问题:左半(Stage 1-2)解决"共享大脑怎么获得 3D 空间感、还不丢通用知识";右半(Stage 3-4)解决"在冻结的大脑上怎么学会开车"。
-
Stage 1 · 感知头预训练:只有 BEV 头带火,视觉编码器和 VLM 全程冻结。先单独训感知头,探测冻结特征里到底有多少 3D 信息——结果表明不够,才有了 Stage 2 的解冻。这一步是"探针"思路的直接体现。
-
Stage 2 · 感知与 VQA 联合训练:三个模块全部解冻,损失 L_perc + L_ntp。BEV 头学习率设为 VLM 的 20 倍;感知损失经 F_m 抽头回流改 VLM,同时通用视觉语言数据同步进——防止学驾驶丢通用。结束后,共享路径同时具备显式 3D 感知和通用语言理解。
-
Stage 3 · 规划专家预训练:VLM 重新冻结,只训规划专家。它不重复跑 VLM,只读缓存的 K/V;自己的输入是加噪轨迹,用流匹配损失学去噪,输出未来 50 点轨迹。文本推理(Reasoning)是可选条件。产物是 Qwen-Drive-1.0-SFT。
-
Stage 4 · 强化学习:还是只训规划专家,监督信号从固定损失换成任务级奖励——采样轨迹 rollout,用 NAVSIM PDMS、WOD-E2E RFS、位移误差打分,策略梯度回传。产物是 Qwen-Drive-1.0-RL。
两个容易看漏的点:K/V 箭头单向只读,规划专家的梯度不回传 VLM,保证 Stage 2 塑好的共享表示不被规划任务带偏;训练集共约 2.83M 样本,其中 24.2% 带规划推理 trace。
推理 trace 是论文自构造的自然语言因果解释,用 Chain-of-Causation 格式说清"为什么要这么开"(比如"绿灯条件下跟车通过路口",然后跟着对应轨迹点)。
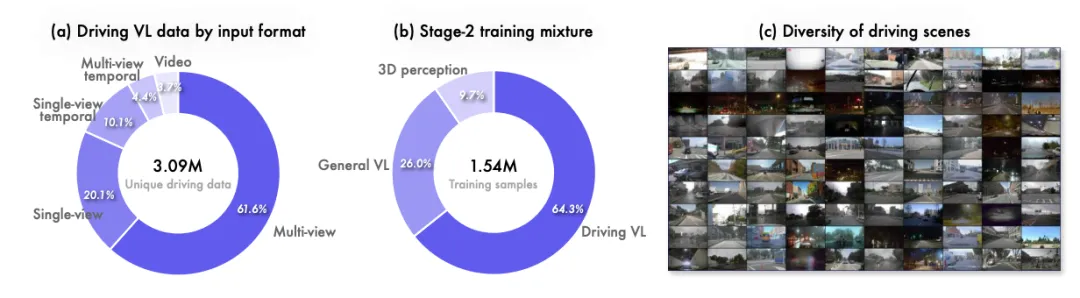
图 | 驾驶数据筛选与 Stage 2 训练配比 ©【深蓝 AI】编译
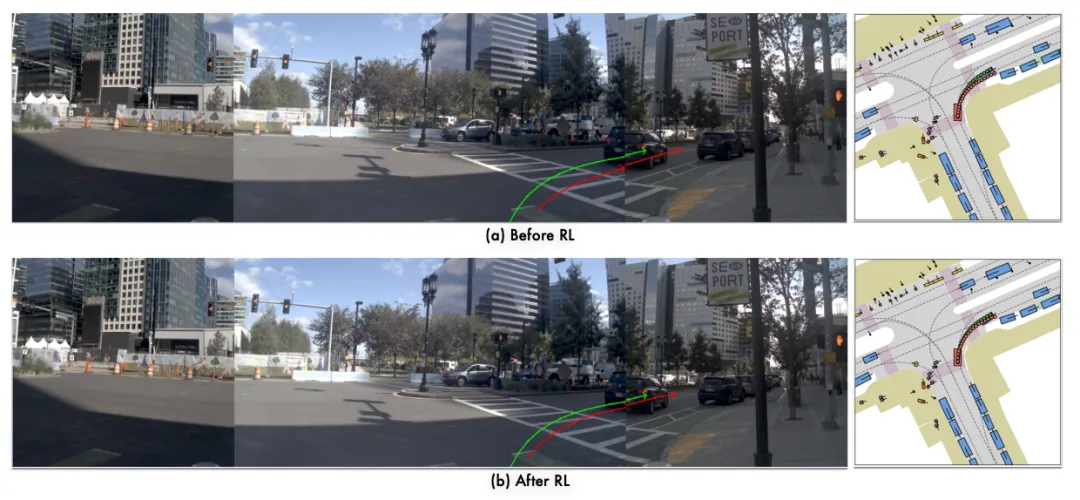
图 | Figure 10:强化学习对同一 NAVSIM 左转场景的影响(上:RL 前;下:RL 后)©【深蓝 AI】编译
Qwen-Drive-1.0 的价值不在刷榜,而在它验证了一条更省钱的路线:4B 的 VLM 底座 + 1.1B 的规划专家,就同时接住了感知、问答、规划三件事。不改预训练架构、不加特殊 token、权重生态与原生 Qwen3.5-4B 完全兼容,模型和数据配方全部开源——对算力预算紧张、又想在座舱和驾驶之间复用一套底座的车企来说,这是一条可以直接抄的作业。
编辑|咖啡鱼
审核|阿蓝
参考文献:Qwen Team, Huazhong University of Science and Technology.
Qwen-Drive-1.0: An Initial Step towards a Vision-Language Foundation Model for Autonomous Driving.2026-09-02.
开源地址:https://huggingface.co/Qwen/Qwen-Drive-1.0-4B/
https://modelscope.cn/models/Qwen/Qwen-Drive-1.0-4B /
https://github.com/QwenLM/Qwen-Drive-1.0
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
