

把视觉点轨迹作为中间层,弥合机器人本体动作与图像空间预测的错位
——轨迹驱动机器人世界模型
本体动作作为世界模型的输入条件,属于稀疏的硬件专属信号,很难生成精准的未来视觉画面,这是制约VLA闭环规划泛化能力的核心痛点。
斯坦福李飞飞、吴佳俊团队提出TrAct框架,改用与硬件无关的视觉点轨迹(visual tracks)作为控制与视觉预测之间的中间接口。
整套框架由VLAT、TWM、VLAC三部分组成:
第一,VLAT能够产出多组候选的「动作‑视觉轨迹」配对;
第二,TWM世界模型以轨迹作为条件,生成质量优于动作条件的未来视频;
第三,VLAC利用预测出的视觉画面做打分筛选,把最优配对的机器人动作下发硬件执行。
这套工作证明,视觉轨迹可以成为衔接规划、世界模型、执行器的有效桥梁,为具身机器人闭环决策提供一条新的工程路径。
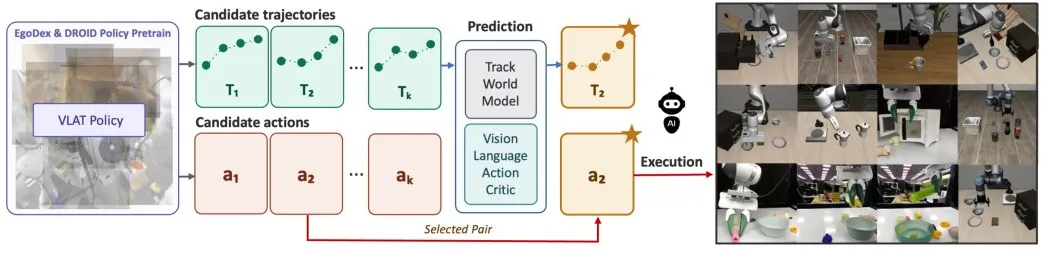
▲图 | TrAct整体系统总览图 ©深蓝具身智能编译
TrAct完整系统实现
整套TrAct分为三大组件:VLAT视觉‑语言‑动作‑轨迹策略、TWM轨迹条件世界模型、VLAC视觉语言奖励打分模型。
推理阶段分为三步:生成候选、视频推演、打分选择。
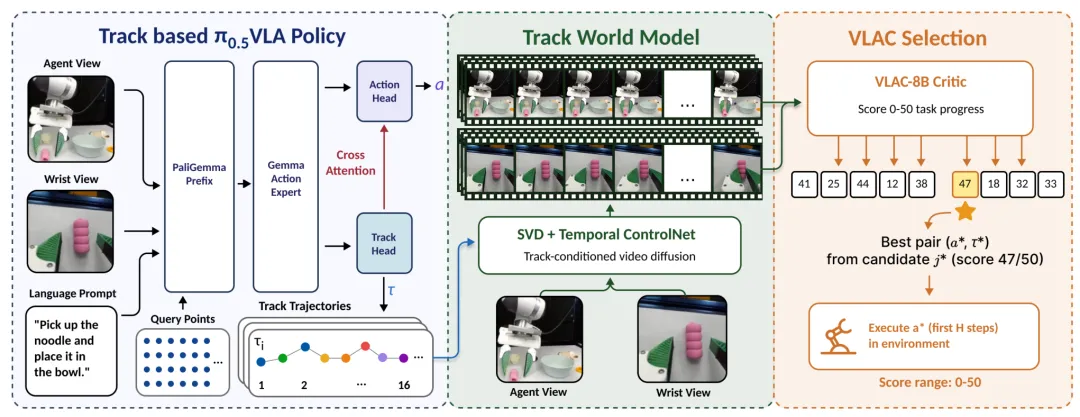
▲图 | TrAct三阶段推理流程:生成候选对、轨迹条件视频推演、打分选择最优动作 ©深蓝具身智能编译
VLAT:同时预测动作与视觉轨迹的策略
VLAT基于预训练流匹配VLA模型π₀.₅改造,在原有动作头之外新增轨迹头。
输入当前双视角观测(agent视角+腕部相机视角)与语言指令,一次性输出K组候选:机器人动作块、对应的2D点视觉轨迹。
-
VLAT模型输出:
注释: 代表当前观测, 是语言指令; 为机器人动作序列, 代表 2D 点视觉轨迹序列。
训练使用联合流匹配损失, 同时监督真实动作真值与真实视觉轨迹真值。
-
VLAT 联合损失:
第一项是动作流匹配损失;第二项为视觉轨迹流匹配损失;平衡两项损失权重。
轨迹点分为两类:
夹爪网格顶点,描述末端执行器运动;
5×5均匀采样网格点,捕捉背景与物体运动。
同时针对两个相机视图做差异化输出:agent视图只输出夹爪关键点;腕部视图同时输出夹爪与场景网格点。
推理时采用TSR温度重采样,调高噪声生成多组多样化的动作‑轨迹候选,避免候选样本高度趋同。
TWM轨迹条件世界模型
TWM以SVD(Stable Video Diffusion)作为视频生成骨干网络,新增ControlNet分支,把2D视觉轨迹编码成空间控制信号作为生成条件。
-
TWM视频生成:
输入当前观测和 VLAT 输出轨迹, 输出预测未来视频。
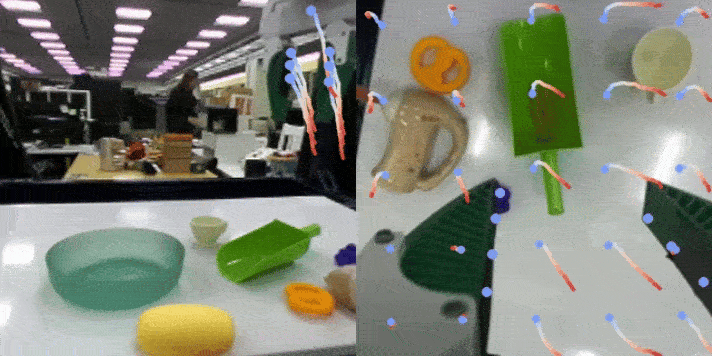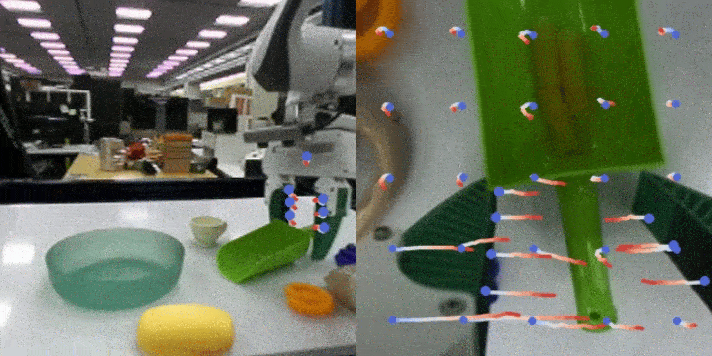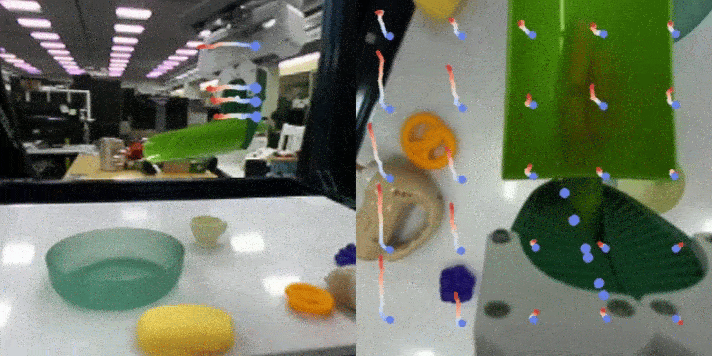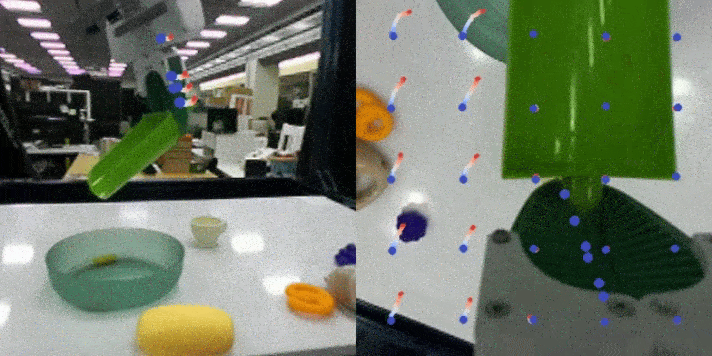
不同相机视角的轨迹渲染为不同ControlNet通道,agent视图轨迹用红色、腕部视图轨迹用蓝色,保障多视图生成时序一致性。
作为对照基线,研究同时实现AWM动作条件世界模型:动作经过MLP映射到CLIP特征,拼接相机视图嵌入送入UNet交叉注意力。
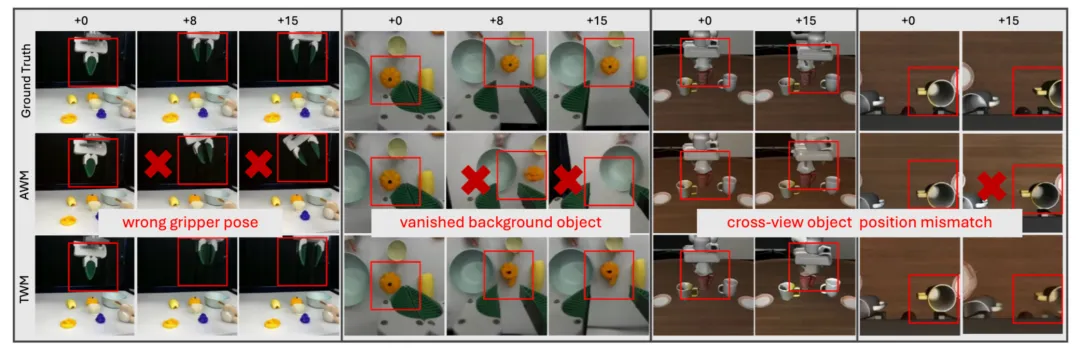
▲图 | TWM与AWM视频生成定性对比图 ©深蓝具身智能编译
VLAC视觉‑语言打分选择模块
VLAC复用InternVL2架构,接收TWM输出的预测视频片段和语言指令,输出0‑50分数表征该推演结果满足任务指令的程度。
-
最优候选选取:
即VLAC打分函数,选出分数最高的候选,执行它对应的机器人动作。
整套推理是滚动执行,执行完动作块之后,采集新图像观测,重新运行VLAT‑TWM‑VLAC完整流程。
预训练与微调数据集设置
-
VLAT预训练:76K DROID、150K EgoDex数据集,1:2混合。
DROID提供机器人动作+轨迹真值;EgoDex只有第一人称手部视频,仅监督轨迹头,不监督动作头,借助人类操作视频学到通用物体运动模式。
-
TWM、AWM世界模型预训练使用76K DROID轨迹;后续在LIBERO、真实机器人数据集共同微调,保证两组基线训练条件完全公平。
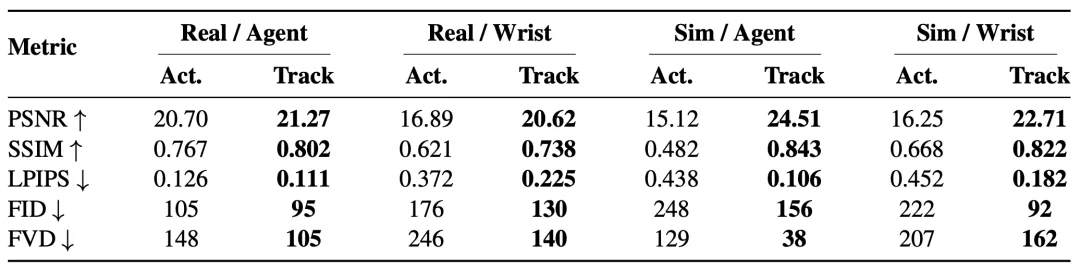
▲表 | 仿真与真实环境下,agent视图、腕部视图视频生成质量对比 ©深蓝具身智能编译
从视频生成指标可以看出,无论仿真还是真实机器人数据,TWM在全部指标上均优于AWM。尤其腕部视角,真实场景LPIPS从0.372下降至0.225,FVD从246下降至140。
实验结果:仿真LIBERO‑INTEGRAL与真实Franka机械臂
LIBERO‑INTEGRAL仿真基准
原有LIBERO基准已经被不少方法刷到接近饱和,论文提出LIBERO‑INTEGRAL,专门面向分布偏移与跨本体泛化。
数据集合计20项任务:10项鲁棒性任务(物体、视角、机器人初始位姿变化),10项跨本体任务,把原本Franka机器人替换为UR5,场景、任务指令保持不变。
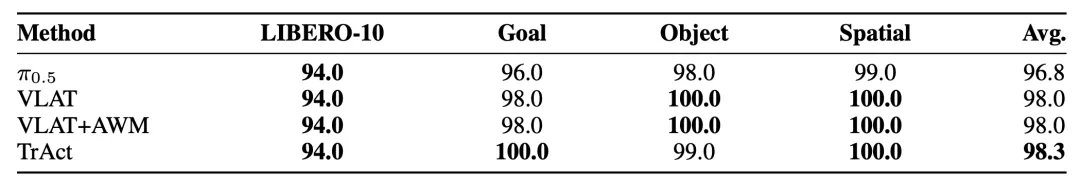
▲表 | 四项标准 LIBERO 基准套件任务成功率 (%),每套包含 100 条评估片段 ©深蓝具身智能编译
单纯VLAT(仅输出动作‑轨迹,没有世界模型推演筛选)相比基线π₀.₅就有提升;
再叠加世界模型选择,无论AWM还是TWM都可以继续涨点;
而TWM(TrAct完整方案)整体最优,尤其相机视角变化、跨机器人本体迁移场景增益明显。
该提升来自两处叠加,一是VLAT本身策略能力,二是TWM更好的视频预测给VLAC提供更高质量的打分素材。
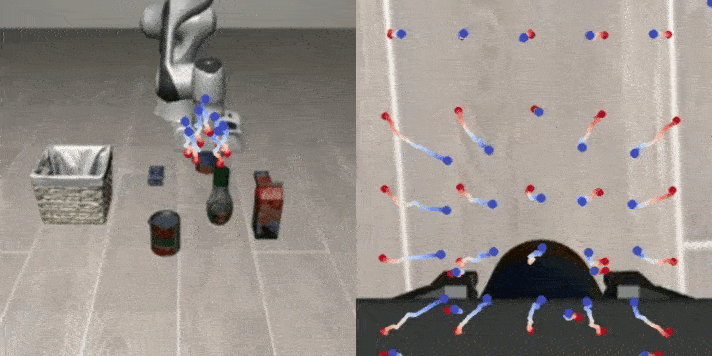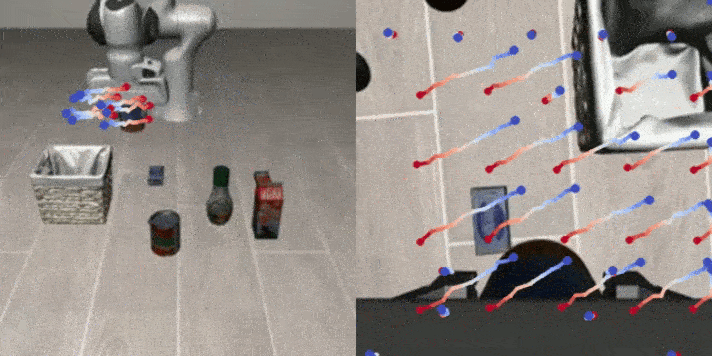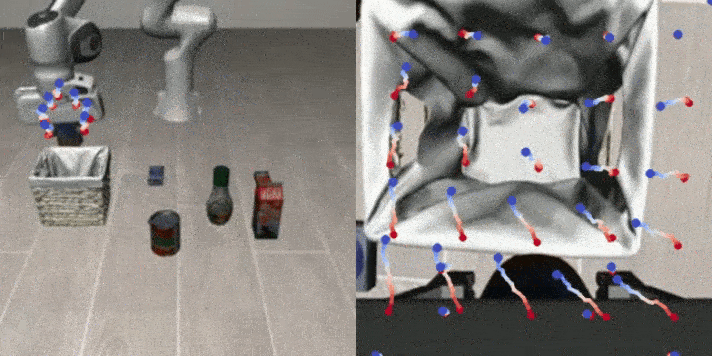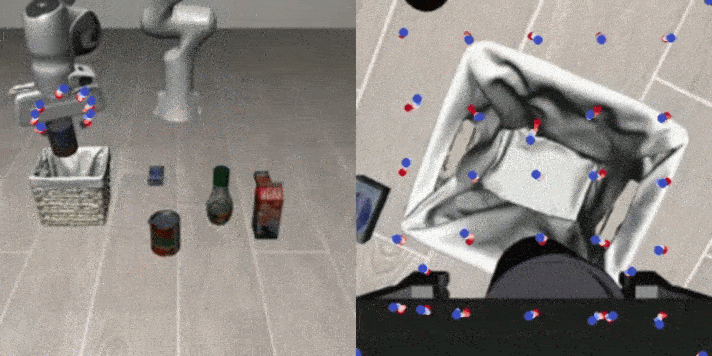
▲图 | Original LIBERO
Franka Panda真实机械臂实验
真实硬件采用双相机配置:agent第三人称相机、腕部相机。
测试5项训练集完全没有见过的新任务;每项任务分两种背景:训练原始背景、视觉完全不同的陌生背景,用来检验视觉分布偏移下鲁棒性。
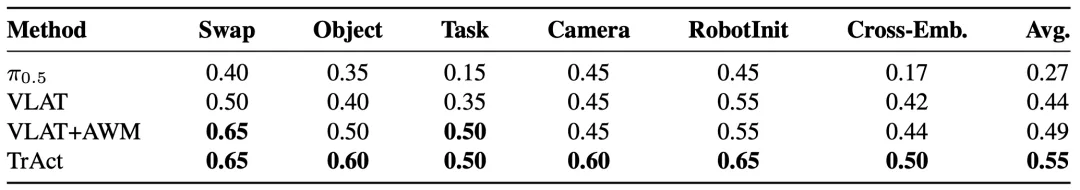
▲表 | LIBERO‑INTEGRAL 基准实验结果:包含物体、任务、相机、机器人初始位姿、跨本体 UR5 五大类别平均任务成功率 ©深蓝具身智能编译
π₀.₅基线平均只有49%;VLAT策略提升到55%;VLAT+AWM达到66%;完整TrAct方案达到76%。
陌生背景下差距进一步拉大:VLAT+AWM性能出现明显跳水,而TrAct依旧保持较高成功率。
这一点说明轨迹作为图像层面运动约束,对背景外观变化具备更强抵抗力。
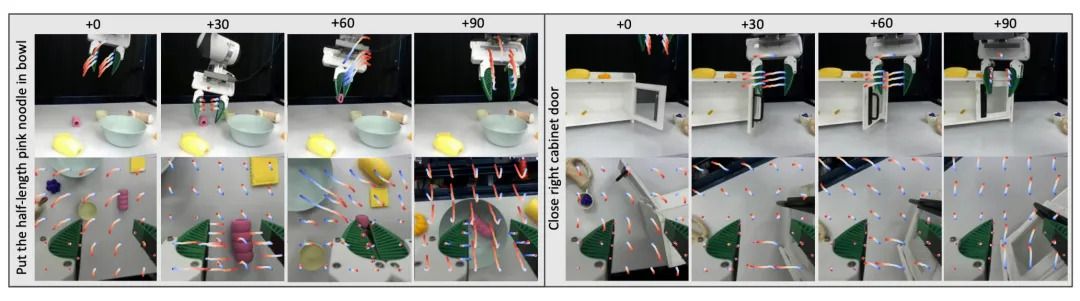
▲图 | 真实机器人任务推演可视化示例 ©深蓝具身智能编译
候选数量K消融
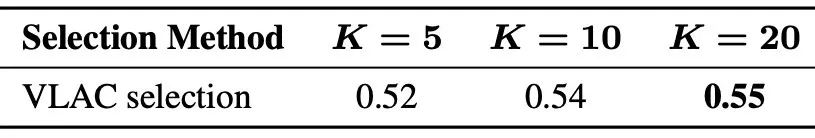
▲表 | 不同采样候选数量K条件下TrAct任务成功率 ©深蓝具身智能编译
K=5已经拿到大部分收益(52%);K=10提升到54%;K=20达到55%。
可以看出,候选数增大带来收益边际递减,工程部署可以根据算力在速度和成功率之间权衡。
轨迹驱动机器人世界模型
TrAct给出了一个有意思的思路:不一定非要拿机器人本体动作,作为世界模型的唯一输入条件。
通过视觉轨迹充当中间层,把“机器人该做什么动作”和“画面上物体应该怎么运动”两件事拆开处理:
轨迹负责描述图像空间运动,世界模型拿轨迹做预测;动作专门负责硬件执行。
在LIBERO‑INTEGRAL跨本体仿真基准、Franka真实机械臂未见任务上,TrAct相比基线得到可观提升,尤其视觉背景变化、更换机器人本体这类分布偏移场景增益突出。
但也要客观看待,这套系统是多条模块串联而成,链路长、算力开销大,每个子模块的错误会向后传递。
未来值得继续探索降低视频生成开销、提升遮挡条件下轨迹预测鲁棒性、拓展到更长时序多步骤任务。
编辑|小小怪博士
审编|具身君
Ref
TrAct: Bridging Robot Control and Visual Prediction with Visual Tracks
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
