

重投影本身没有错,但问题在于把所有运动分量混合后形成的监督过于粗糙。
——引入来自运动分量的几何约束
近日,同济大学电子与信息工程学院范睿教授团队在无监督单目深度估计与视觉里程计研究方面取得新进展。
相关研究以 “Discriminately Treating Motion Components Evolves Joint Depth and Ego-Motion Learning” 为题,已被《IEEE Transactions on Pattern Analysis and Machine Intelligence》(TPAMI)收录。
无需深度与位姿真值的单目深度–自运动联合学习框架
-
深度与自运动估计的价值
深度估计与自运动估计是三维感知中的两个核心任务,二者共同支撑视觉SLAM、三维重建等技术,在自动驾驶与机器人环境感知中具有重要作用。
-
现有数据驱动方法及其局限
随着视觉基础模型的发展,数据驱动的深度估计与自运动估计正越来越多地依赖大规模预训练模型,并通常需要大量具有真值标注的数据进行有监督训练。
尽管这类方法能够获得较高的预测精度和更强的泛化能力,但其对大规模离线数据、预训练模型以及计算资源的依赖,也在一定程度上限制了其在缺乏充足预采集数据、需要针对特定场景快速适应,或计算资源受限等实际应用中的灵活部署。
因此,近年来无监督单目深度与自运动联合学习成为了一个重要研究方向。
-
无监督单目联合学习:研究方向与优势
这类方法无需额外获取对应的真值数据,可采用轻量的网络结构,直接利用连续单目视频同时学习场景深度与相机自运动,为复杂场景下的三维感知提供了一种更加灵活高效的解决方案。
-
当前研究存在的关键问题
然而,现有研究长期将更多注意力集中在深度估计网络(DepthNet)及其监督方式上,而通常将自运动估计视为辅助任务。
对于自运动估计网络(PoseNet)输出中的不同运动分量,以及如何利用这些运动本身的几何规律进行有效监督,仍缺乏充分研究。
由于DepthNet与PoseNet在联合学习过程中相互耦合,PoseNet监督不足也会进一步影响DepthNet的学习。这使得使有无监督联合学习框架在两项任务的预测精度、模型鲁棒性与训练稳定性方面存在明显不足。
针对这一问题,本文研究重新审视了不同运动分量对深度与位姿联合优化产生的影响,提出了一种能够区别处理不同运动成分,并从中获取运动分量几何约束的深度-自运动联合学习框架DiMoDE。
不同运动分量为何不能无差别混合?
深度与自运动的无监督联合学习通常利用DepthNet预测的深度和PoseNet预测的相机运动生成刚性光流,再通过帧间重投影误差同时监督两个网络。
那么这套重投影监督是否为深度和位姿提供了充分的约束?
研究报告的结果有一个值得注意的现象:
在KITTI Odometry数据集的长序列视频上,现有方法即使已经使用了它们进行训练,自运动估计的精度仍然不佳,预测轨迹仍会产生明显漂移。
这说明,PoseNet 在训练过程中所预测的位姿仍未获得足够有效且准确的监督信号。
类似的问题也存在于DepthNet 的训练过程中。
在 nuScenes 这类包含复杂光照变化、天气条件以及多样化场景结构的数据集上,研究报告的收敛曲线表明,即使基线方法已经引入了有效正则化约束,并缓解了动态物体以及光度监督失效等问题,其验证误差在训练过程中仍会在下降至一定水平后出现明显震荡,难以进一步稳定降低。
这表明,在联合优化过程中仍存在相互冲突或不可靠的监督信号,而这些问题在复杂场景下进一步显现,导致DepthNet 难以稳定收敛至更优解。
是什么导致了上述问题与瓶颈?
研究从刚性光流的几何规律以及优化变量之间的梯度关系出发进行分析,并将问题指向了一个长期被忽视的设计:
旋转、切向平移和径向平移虽然具有不同的几何性质,却一直被无差别地混合在完整6自由度运动中生成监督信号。
切向平移、径向平移与旋转具有不同的光流规律
当相机沿垂直于光轴的方向发生切向平移时,图像中不同位置的刚性光流具有一致的方向,其幅值完全由场景深度决定,并与深度呈反比关系,可以直接结合相机平移恢复深度。
经典双目视觉中的视差正是这种几何关系的特例。
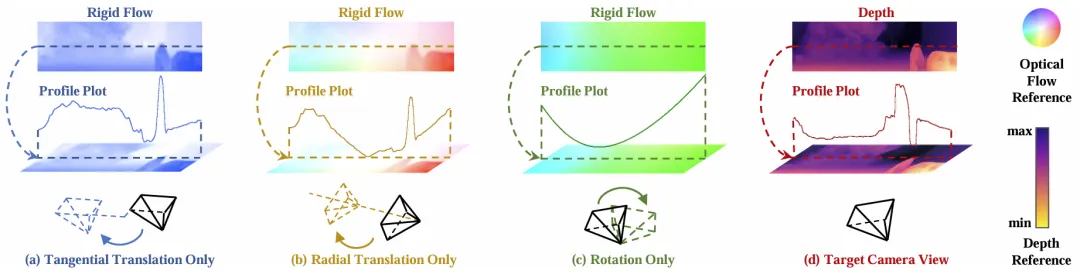
▲图 | 不同运动类型对应的刚性光流规律©【深蓝具身智能】编译
当相机沿光轴方向发生径向平移时,刚性光流则呈现以图像主点为中心的辐射状分布,并伴随明显的透视缩放;
与切向平移不同,径向光流不仅与深度有关,还受到像素位置的影响:靠近主点区域的位移较小,而图像边缘区域的位移更加明显。
相比之下,纯旋转产生的刚性光流具有更加复杂且不规则的空间分布,而且与场景深度无关。
这意味着旋转本身无法直接为DepthNet提供有效的深度监督,这一点在此前SC-DepthV2等研究中也有所讨论。
而如果将不同运动分量混合,各自具有判别性的光流几何规律将被掩盖,使监督信号难以对不同运动分量进行区分,并分别发挥有效约束作用。
旋转与平移联合优化导致参数耦合
研究分析表明,绕 x、y 轴的旋转分量与沿 y、x 轴的平移分量具有相似的优化方向。
因此,同一刚性光流误差既可以通过调整旋转参数降低,也可以通过优化平移参数和深度进行补偿,导致运动变量之间产生优化耦合。
在光度信号不可靠的复杂场景下,刚性光流监督本身进一步失效,使优化过程更容易陷入不稳定状态。
即使去除旋转影响,不同平移分量的混合仍存在问题。
两种平移运动对深度估计的影响具有明显的空间差异:
切向平移主要影响图像中心区域,而径向平移的影响随着像素远离主点逐渐增强,并在边缘区域占据主导。
当某一平移分量估计不可靠时,其产生的错误监督会直接影响对应区域的深度估计,且难以被有效识别和抑制。
因此,如果将不同运动分量混合,运动分量的估计误差会在不同分量之间互相传播,并干扰深度估计网络的优化更新。
如何构建来自运动分量的监督信号?
前文分析不仅揭示了不同运动分量混合优化所带来的问题,也指明了两个直接的解决思路:
一方面,利用不同运动自身的几何规律,为各位姿分量建立更有针对性的监督;
另一方面,通过运动分解,建立深度与对应平移分量之间独立的几何约束。
以规则平移光流作为运动分解的几何判据
旋转产生的光流较为复杂,难以直接从混合运动的刚性光流中判断其中包含的旋转类型及旋转大小。
但切向平移和径向平移都具有明确且可验证的光流规律,因此提供了一个新的思路:
通过逐步消除不同运动分量,并检查剩余光流是否符合预期的纯平移规律,可以反过来判断运动估计是否准确。
具体而言,在旋转被消除后,如果进一步去除切向平移,剩余光流应当呈现径向平移对应的辐射状规律;
反之,如果进一步去除径向平移,剩余光流则应当呈现切向平移对应的统一方向。
而只要运动分量估计存在偏差,最终得到的光流就会偏离相应的理论规律,从而产生能够约束运动分量的监督信号。
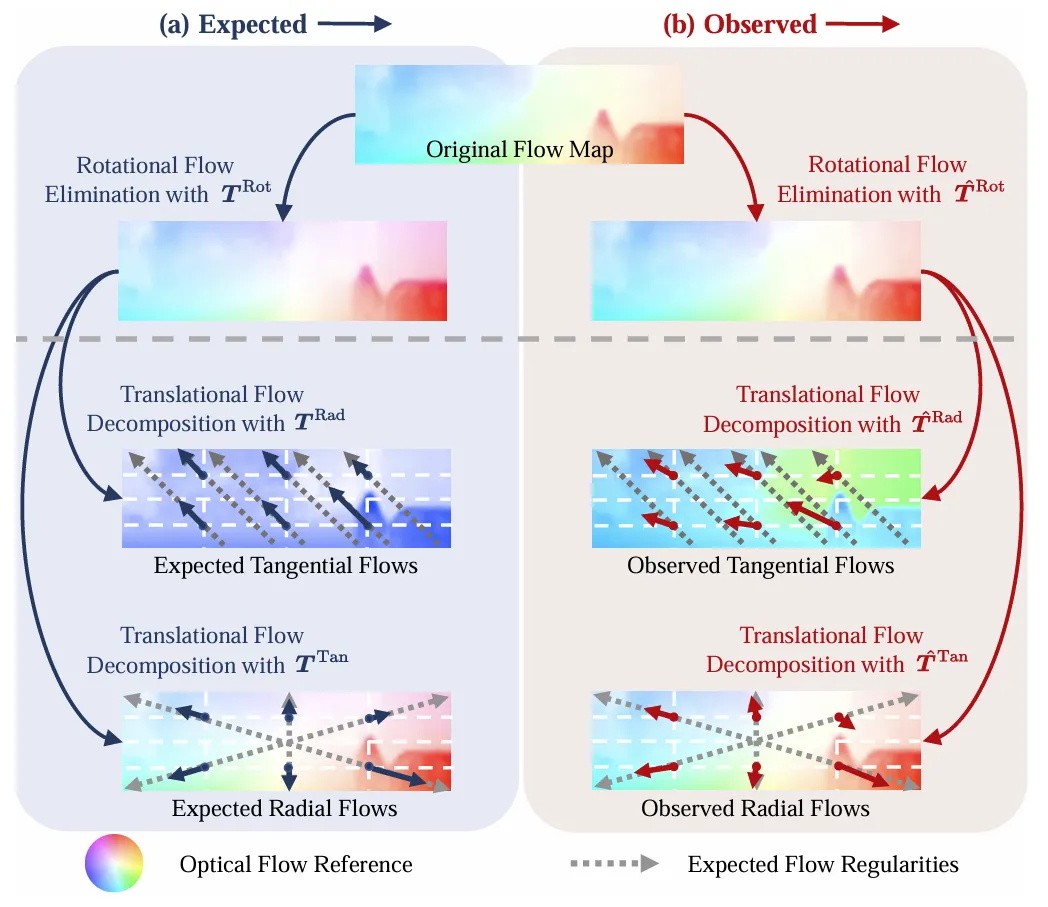
▲图 |不同运动分量的分解过程及预期光流规律©【深蓝具身智能】编译
在单一运动分量下构建解耦约束
既然旋转、切向平移和径向平移同时参与优化会产生参数耦合,那么一种直接的解决思路是:
如果当前帧间运动能够被分解到只包含一种平移的形式,就可以直接构建仅包含一个运动分量的几何约束。
由于该几何约束不再同时包含旋转和多种平移分量,因此可以专注于最小化由当前平移与深度共同引起的重投影误差,从而有效降低旋转与平移之间的参数耦合对DepthNet 优化更新的影响。
同时,这种独立约束还允许分别评估不同运动分量的可靠性,并单独过滤幅值过小、信噪比较低或估计不可靠的平移分量对应的监督信号,从而抑制不可靠运动分量引起的误差向DepthNet 传播。
DiMoDE:基于运动分量区分处理的深度–自运动联合学习框架
前述两种来自运动分量的监督信号,实质上指向了同一个运动分解过程:先移除旋转,再分离平移。
DiMoDE 将其嵌入现有无监督联合学习框架,利用网络预测直接完成上述运动分解,并从中获取来自运动分量的几何约束。
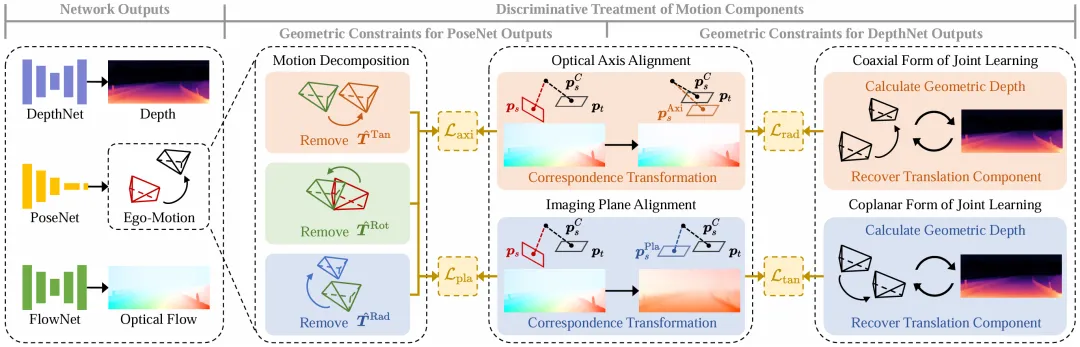
▲图 |DiMoDE算法流程图©【深蓝具身智能】编译
光轴对齐与成像平面对齐
DiMoDE首先将PoseNet预测的完整自运动拆分为旋转、切向平移和径向平移。
其中,消除旋转与切向平移等价于对齐源相机和目标相机的光轴,使剩余运动近似为纯径向平移;
消除旋转与径向平移则等价于对齐两者的成像平面,使剩余运动近似为纯切向平移。
如果按照最直接的方式实现,每消除一种运动分量,就重建新的图像对,并重新估计稠密对应关系,不仅会带来较大的计算开销,还容易在重建图像中引入空洞和伪影,影响后续对应关系的建立。
为此,DiMoDE 采用对应关系变换(Correspondence Transformation):
FlowNet 只需在原始视频帧之间预测一次光流,随后直接根据 PoseNet 和DepthNet 的输出对原始像素对应关系进行几何变换,即可获得光轴对齐和成像平面对齐后的两类新光流。
于是,这两类变换后的光流用于表示运动分解后的图像几何关系,并进一步用于为两个网络提供来自运动分量的几何约束。
通过执行对齐约束PoseNet
对于经过对齐过程得到的两类变换光流,DiMoDE 最小化其与目标纯平移光流之间的几何偏差:
对于成像平面对齐后的光流,约束不同位置的光流保持一致的运动方向;对于光轴对齐后的光流,则要求光流方向与像素至图像主点的连线保持平行。
一方面,最小化这两类几何偏差能够分别提升成像平面对齐和光轴对齐的准确性,使对齐结果不断接近理论纯平移状态;
另一方面,该过程也为执行上述两种对齐过程的PoseNet 输出提供了直接约束:
径向平移只参与成像平面对齐,切向平移只参与光轴对齐,因此两个平移分量能够分别优化;旋转同时影响两种对齐结果,则受到两类约束共同修正。
利用对齐后的几何关系约束DepthNet
当PoseNet能够较准确地完成成像平面对齐和光轴对齐后,相机间的几何关系会通过变换后的光流的转化为共轴(Coaxial)形式和共面(Coplanar)形式。
由于这两种情况下原本复杂的深度–运动耦合关系被显著简化,因此可以建立闭式几何关系:
DiMoDE可以利用对齐光流和PoseNet预测的平移直接计算几何深度,并与DepthNet输出保持一致;
反过来,也可以利用DepthNet预测的深度重新恢复对应平移,与PoseNet结果进行校验。
由此,DiMoDE在两个网络之间形成深度与平移分量之间相互独立的几何约束。
对于运动幅值过小或几何结果明显不可靠的情况,DiMoDE 还会独立过滤对应监督信号,避免不可靠运动分量影响 DepthNet 的训练过程。
构建复杂真实场景视觉里程计数据集:MIAS-Odom
KITTI 等自动驾驶数据集主要面向车载前向运动场景,较少覆盖剧烈旋转、频繁抖动以及复杂光照等情况,因此难以充分验证训练框架在复杂运动和低质量视觉输入条件下的有效性与稳定性。
为此,研究构建了新的视觉里程计数据集MIAS-Odom。
MIAS-Odom采用手持式采集平台进行数据采集,平台集成硬件同步的双目相机、Livox MID-360固态LiDAR和IMU,并利用LiDAR–惯性里程计获得高精度参考轨迹。
数据集共包含6个视频序列,包括3个室内序列和3个室外序列,总计11,608张图像。
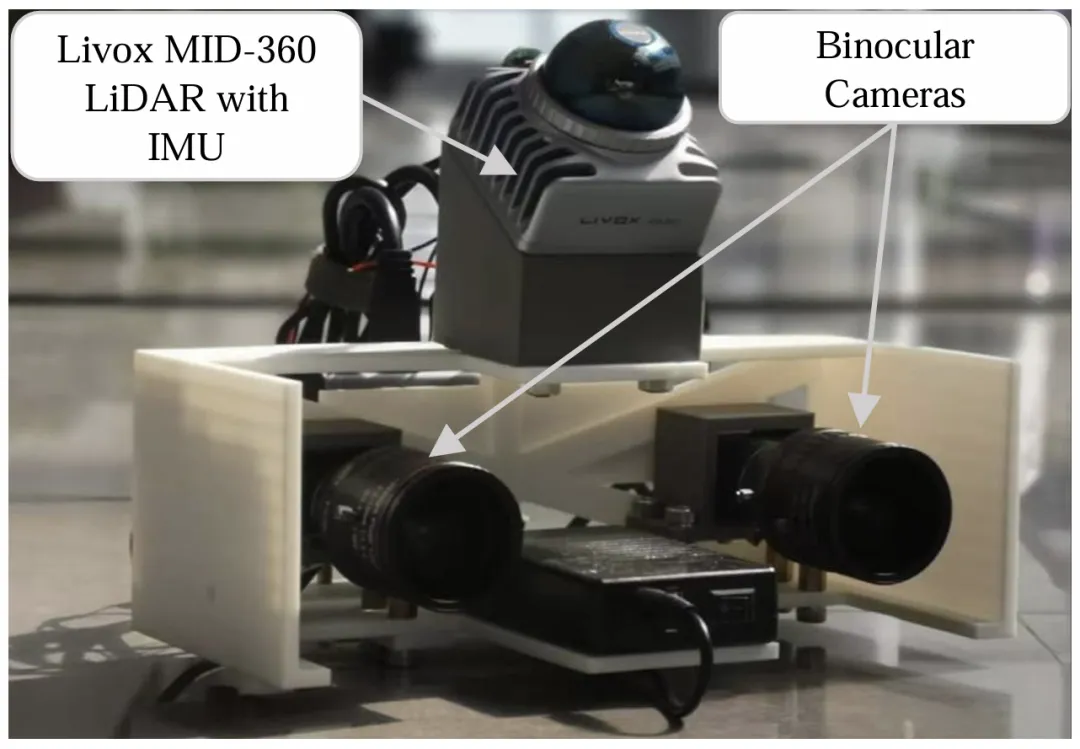
▲图 | 数据采集平台©【深蓝具身智能】编译
相比常规道路场景数据集,MIAS-Odom 重点覆盖大幅旋转、频繁相机抖动、过曝、低照度以及运动模糊等复杂情况。
这些因素不仅显著增加了视觉里程计中的运动估计难度,也降低了传统光度重建监督的可靠性,因此能够更加有针对性地评估DiMoDE 的有效性。
实验验证
为了全面验证DiMoDE的有效性,论文在KITTI,KITTI Odometry,DDAD,nuScenes等多个公开数据集及自建真实复杂场景数据集MIAS-Odom上开展了系统实验。
视觉里程计性能
-
首先,在KITTI Odometry 数据集上评估视觉里程计性能。
在标准测试序列Seqs. 09-10 以及10个额外测试序列Seqs. 11-20上,DiMoDE 在所有同类无监督方法中取得了最佳性能,并达到与部分基于优化或优化-学习混合方法相当的效果。
值得注意的是,上述结果仅基于采用ResNet-18 的轻量级 PoseNet 实现,在保持较高性能的同时具备良好的计算效率。
相比之下,部分采用更复杂网络结构或优化-学习混合策略的方法虽然性能相当,但均难以满足实时推理需求。
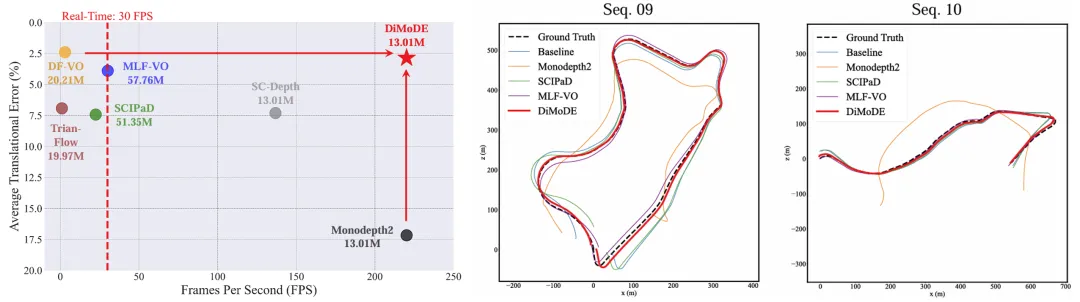
▲图 | 预测轨迹、存储负担和推理速度的对比©【深蓝具身智能】编译
自运动估计约束的有效性
-
随后,重点验证了DiMoDE 在训练过程中是否为 PoseNet 提供了更有效、准确且鲁棒的监督信号。
将模型在额外测试序列Seqs. 11–20 以及自建数据集 MIAS-Odom 上微调以进行域适应后,受限于监督信号质量不足,其他方法在微调后难以进一步提升轨迹精度;
相比之下,DiMoDE 能够更快速地适应复杂环境并显著提升轨迹预测精度。
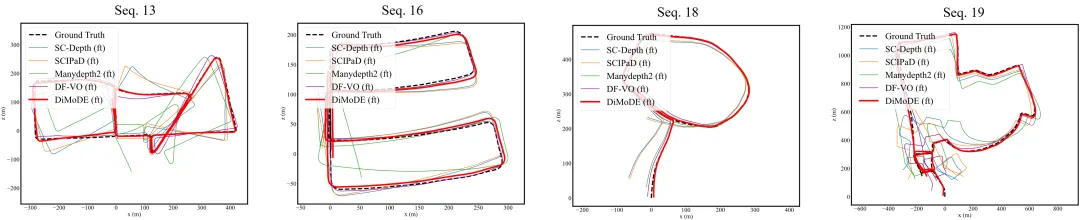
▲图 | 不同方法微调前后的在KITTI Odometry数据集上的轨迹对比©【深蓝具身智能】编译
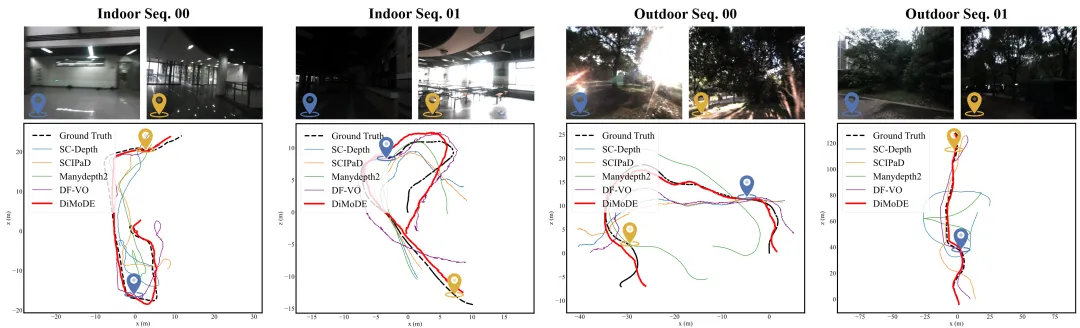
▲图 | 不同方法微调前后在MIAS Odom数据集上的轨迹对比©【深蓝具身智能】编译
单目深度估计性能
-
首先,在KITTI,DDAD,nuScenes三个数据集上评估单目深度估计性能
在KITTI 数据集上,DiMoDE 的性能未超过现有最优方法。然而,在 DDAD 和 nuScenes 等包含更丰富光照变化、恶劣天气以及复杂场景结构的数据集上,DiMoDE 的优势得到了充分体现。
在 DDAD 数据集上,DiMoDE 的 Abs Rel 达到 0.134;
在 nuScenes 数据集上达到 0.139,相比此前最优方法分别提升 5% 和 11%。
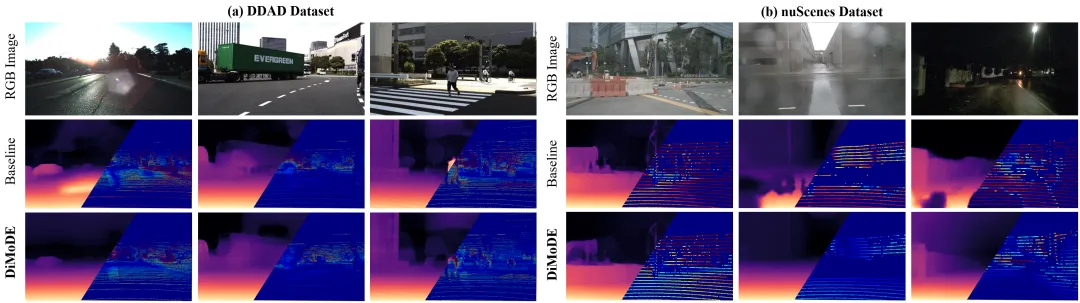
图 | DDAD与nuScenes上的深度预测结果©【深蓝具身智能】编译
深度估计约束的有效性
-
随后,在nuScenes 数据集上报告了完整的训练收敛曲线,验证DiMoDE提供的几何约束对 DepthNet训练的效用。
相比Baseline 方法,DiMoDE 能够显著收敛至更低的误差水平,并且训练过程更加稳定,误差波动更小。这一结果表明,在光度重投影损失和光流估计均不可靠的情况下,基于单一平移分量构建的解耦约束通过专注于最小化由当前平移与深度共同引起的重投影误差,有效抑制了运动分量之间的误差传播,从而帮助深度估计网络实现稳定收敛。
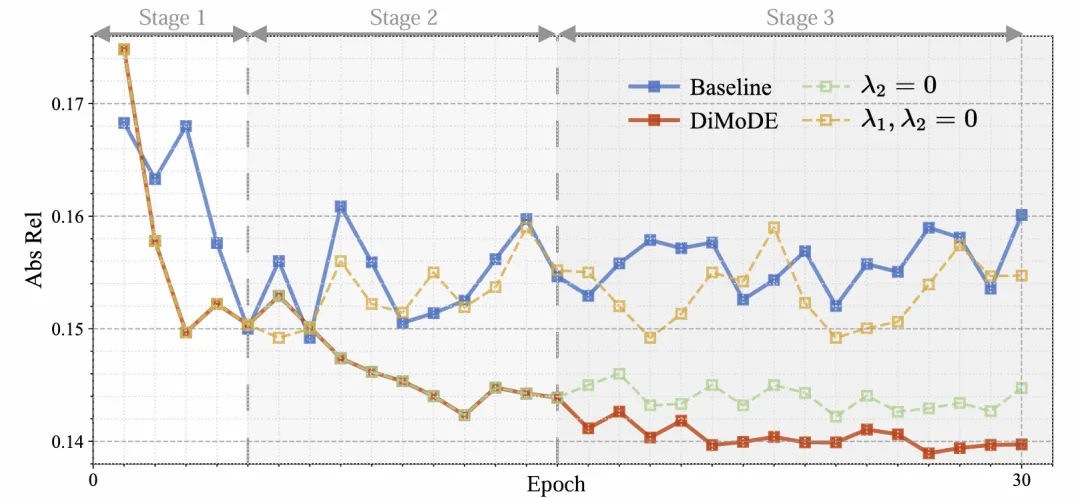
▲图 | 深度估计误差的收敛曲线©【深蓝具身智能】编译
消融实验与敏感性分析
研究通过大量消融实验验证了所提出方法中各个组件的有效性,同时表明DiMoDE 作为通用联合学习框架,能够兼容不同DepthNet 和 PoseNet 架构,并在不同网络配置下保持稳定的性能提升。
此外,研究进一步分析了所提出方法中损失函数权重配比等超参数对训练过程的影响。
实验结果表明,模型性能并未过度依赖于特定参数配置,体现出良好的泛化能力。
最后,论文通过人为引入旋转和平移噪声,验证了在运动分量无法完全对齐的情况下,所构建几何约束的有效性以及对估计误差的容忍程度。
写在最后
随着视觉基础模型的快速发展,依赖海量标注数据训练的基础模型通常已经具备覆盖常规场景的三维感知能力。
因此,无监督三维感知方法的价值逐渐更多地体现在环境退化、资源受限以及分布多样化的开放环境中。
在这些条件下,如何不使用标注数据训练高效且可靠的模型,或进一步优化预训练模型的感知能力,成为重要研究方向。复杂开放环境既带来了机遇,也提出了挑战。
如何使方法在复杂开放环境中持续保持有效性和鲁棒性,是DiMoDE 所探讨的问题,也是未来需要继续研究的重要课题。
Ref
论文题目:Discriminately Treating Motion Components Evolves Joint Depth and Ego-Motion Learning
论文地址:https://ieeexplore.ieee.org/document/11683703
研究作者:Mengtan Zhang, Zizhan Guo, Hongbo Zhao, Yi Feng, Zuyi Xiong, Yue Wang, Shaoyi Du, Hanli Wang, Rui Fan
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
