
现有全身移动操作人形机器人存在明显路线割裂:跟踪类控制器高度依赖测试时参考运动,环境变化直接失效;目标驱动方案肢体、接触交互稳定性差,二者往往需要两套独立模型。
伊利诺伊大学团队提出ULTRA统一多模态控制器,单模型无需切换权重,依靠输入掩码实现三种工作模式:
稠密参考动作跟踪、操作员稀疏指令控制、机载第一人称深度感知长时序目标执行,并在Unitree G1人形机器人完成仿真与真机验证。
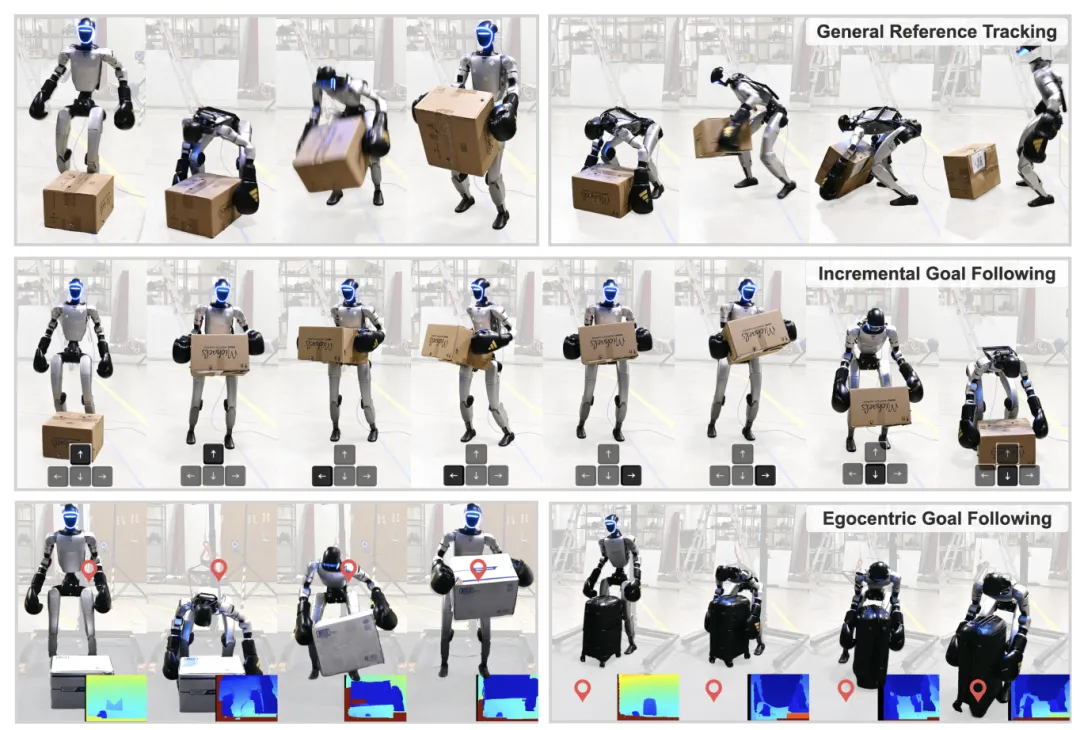
▲图 | ULTRA是人形机器人移动操作一体化控制器©【深蓝具身智能】编译
四阶段完整训练流程
现实场景下机器人的任务输入与感知本身是连续变化的:
-
有时需要复刻示范动作,有时仅给到高层目标;
-
感知来源既有高精度动捕状态,也有噪声严重的机载深度点云。
但主流方案将不同任务、不同感知条件拆分为独立系统。除此之外,传统运动学动捕重定向忽略动力学与接触约束,容易出现脚滑移、手物脱离、物体穿透,很难直接给人形机器人提供高质量训练数据。
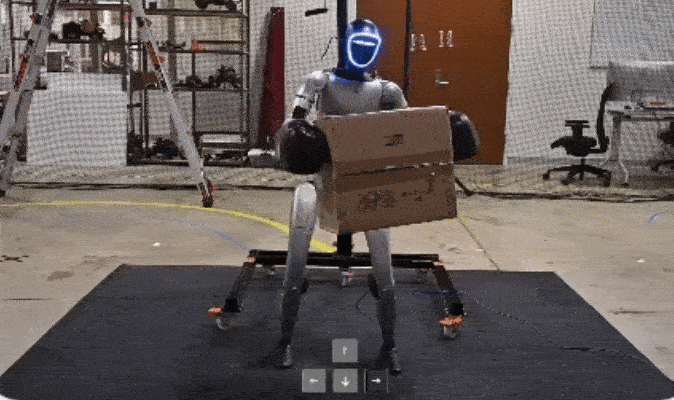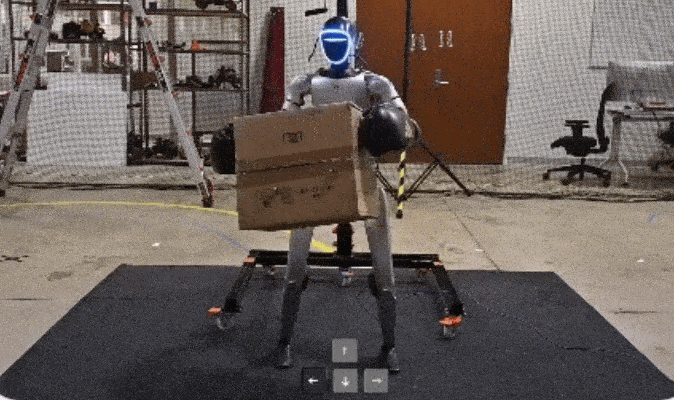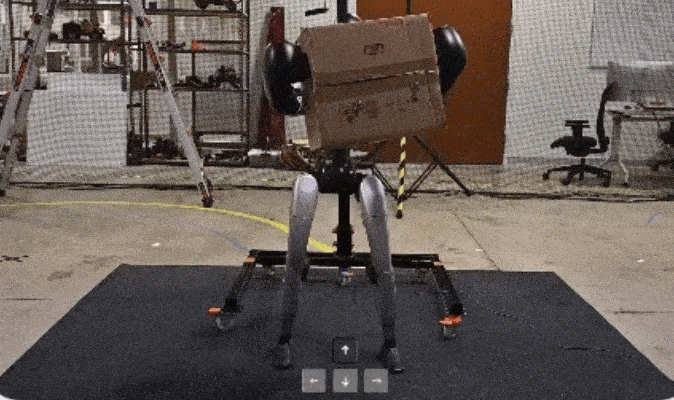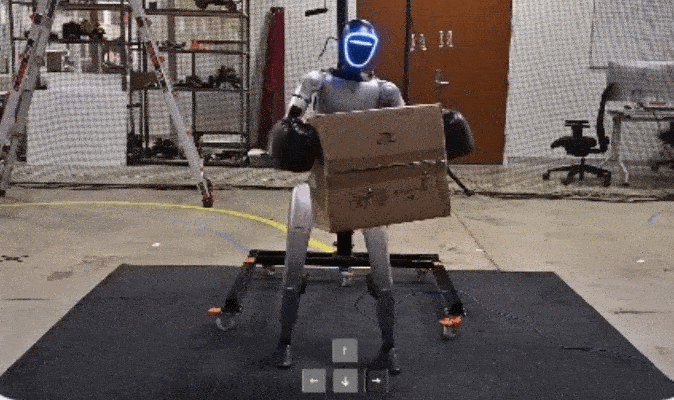
ULTRA完整链路分为四大训练阶段,从动捕数据物理重定向、特权教师策略训练、多模态学生蒸馏到真机部署,打通人类动捕数据到机器人感知驱动自主控制的完整流程。
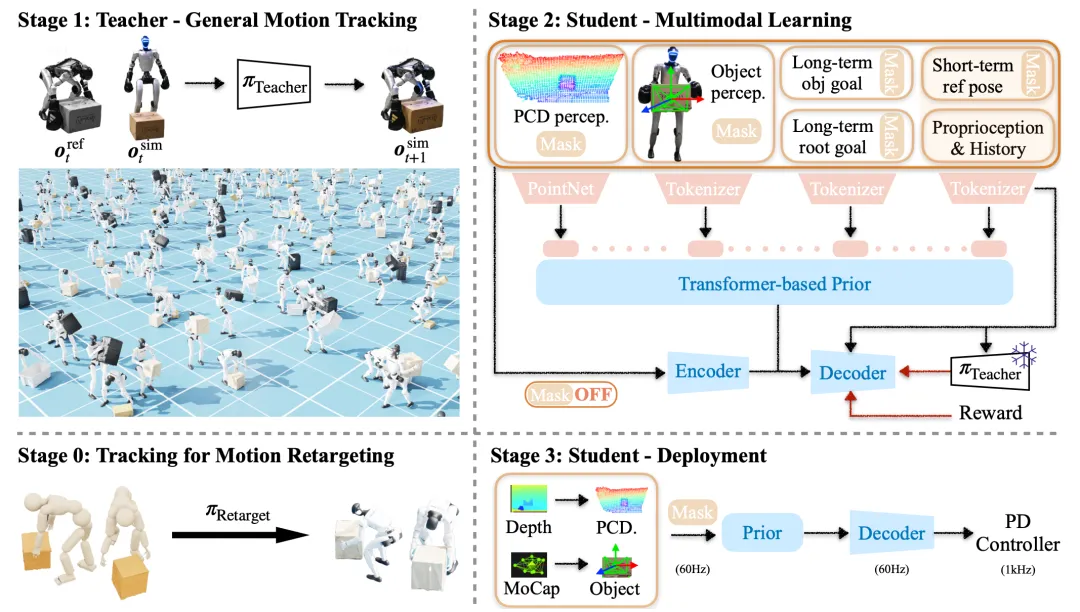
▲图 | ULTRA分为四个阶段©【深蓝具身智能】编译
阶段0:物理驱动神经网络运动重定向
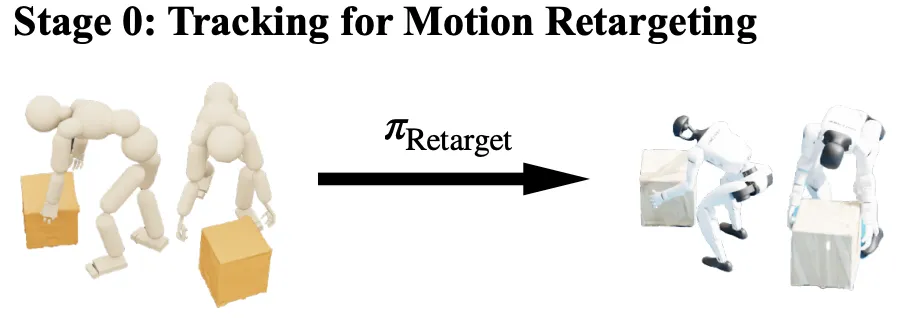
▲图 | 阶段(0)神经网络运动重定向:强化学习策略将动捕数据做增强,生成G1机器人物理可行的轨迹©【深蓝具身智能】编译
传统运动学重定向容易产生物理矛盾。
ULTRA把重定向转化为强化学习轨迹优化,不生硬复刻全部关节角度,优先保障手脚等关键末端、物体位姿以及手‑物接触事件。训练从默认站立位启动,摔倒、接触异常会提前终止episode提升样本效率。
该重定向策略支持零样本数据增强,无需重新训练,直接对轨迹、物体尺寸做缩放,数据集规模扩充约6倍。
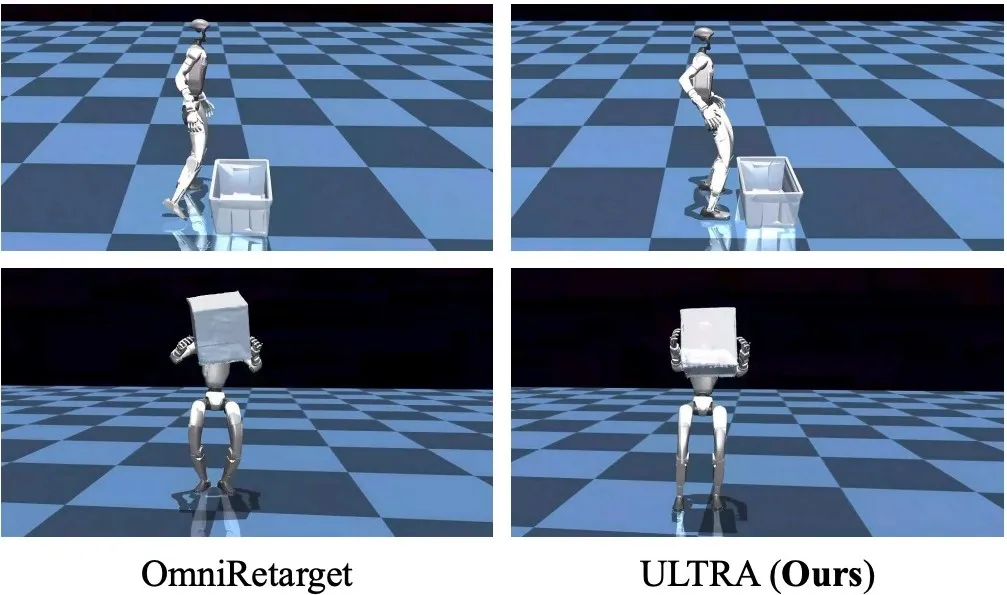
▲图| 同一帧/序列下,本文重定向方法与OmniRetarget定性对比©【深蓝具身智能】编译
但增强效果依托原始动捕数据集,不能生成原始样本完全不存在的全新交互行为。
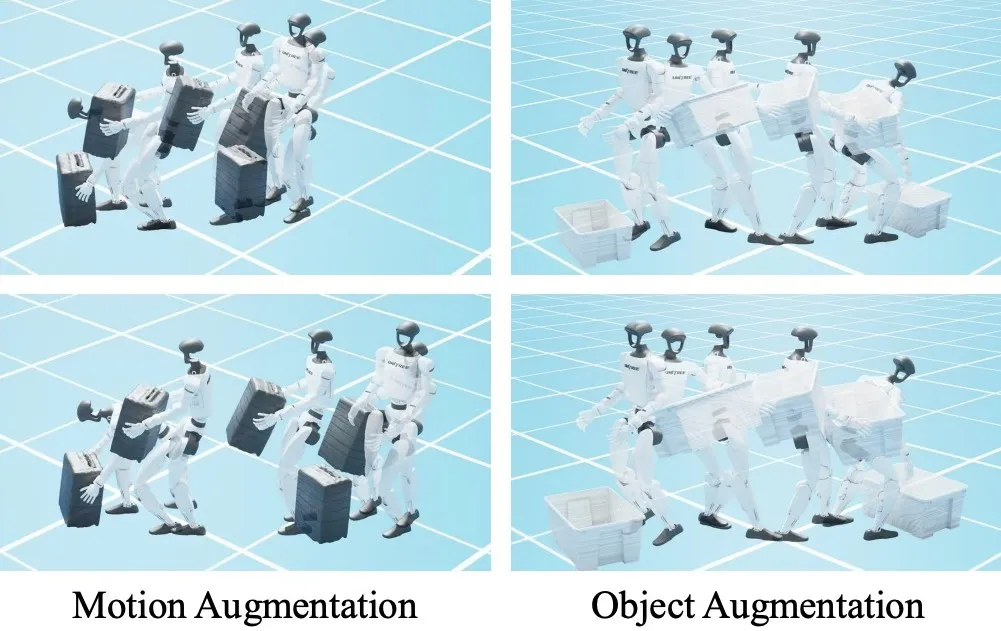
▲图| 重定向策略实现零样本增强©【深蓝具身智能】编译
阶段1:特权教师策略训练
利用重定向产出的大量仿真轨迹,训练拥有仿真完整内部状态的教师策略。
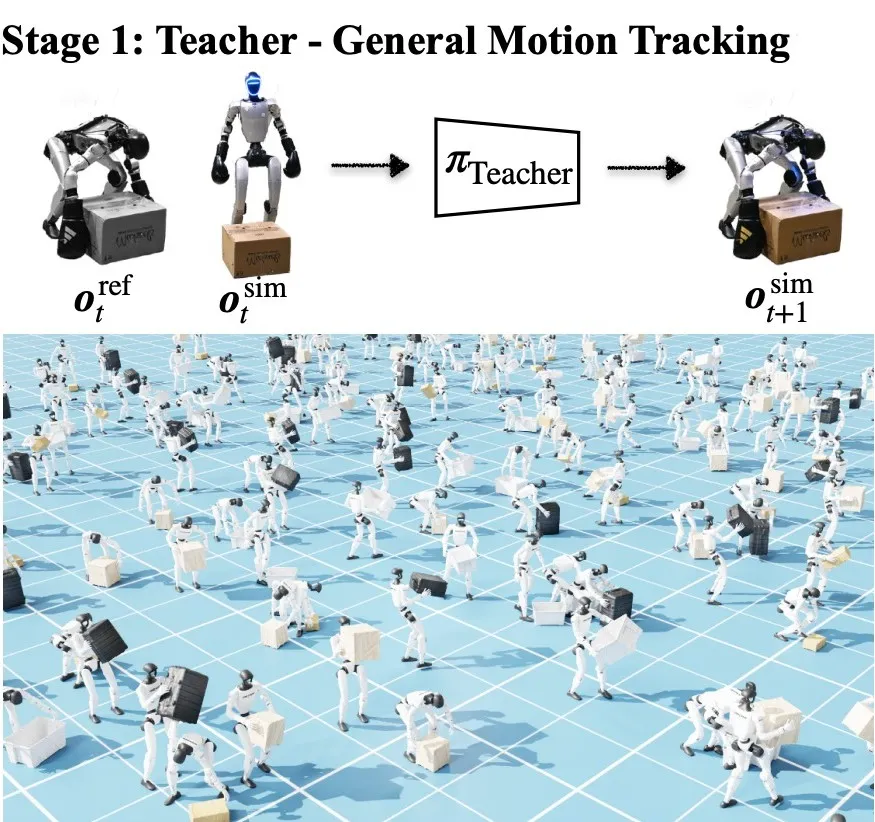
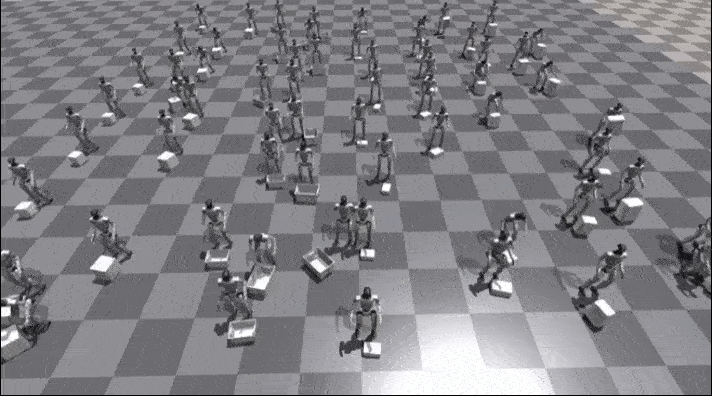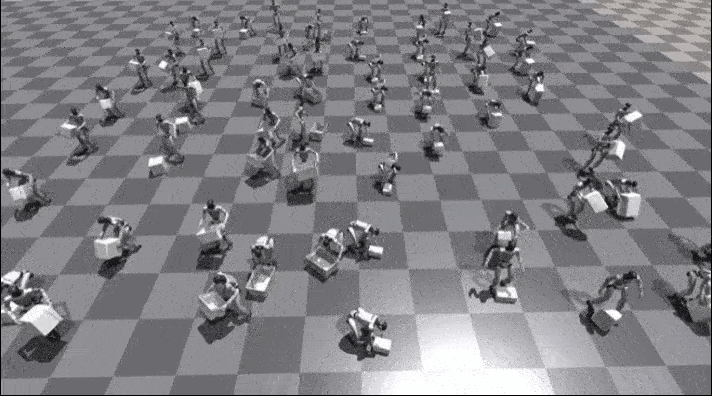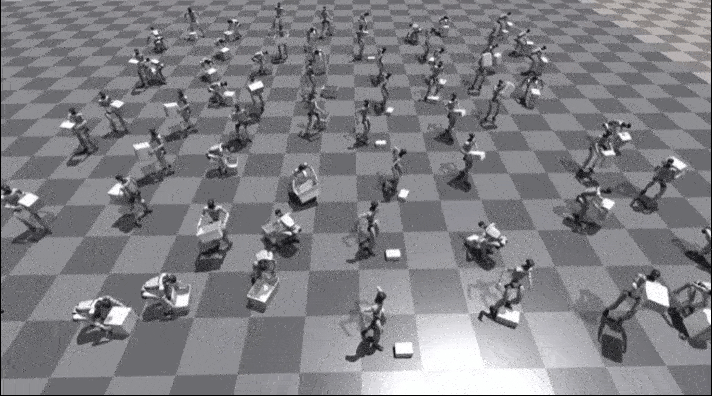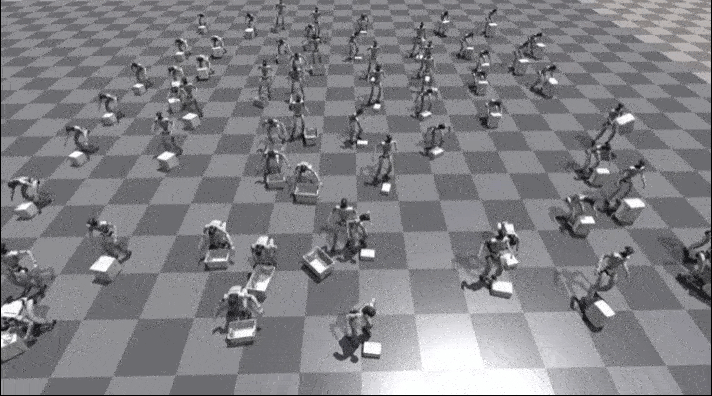
▲图 | 阶段(1)跟踪教师:利用完整状态和参考轨迹训练特权教师策略©【深蓝具身智能】编译
训练过程加入物理参数随机化、外部扰动提升恢复能力。
教师只能在仿真特权状态运行,不作为真机部署,只为学生蒸馏提供高质量监督信号。
阶段2:多模态学生策略蒸馏 + RL微调
这是本工作核心创新。
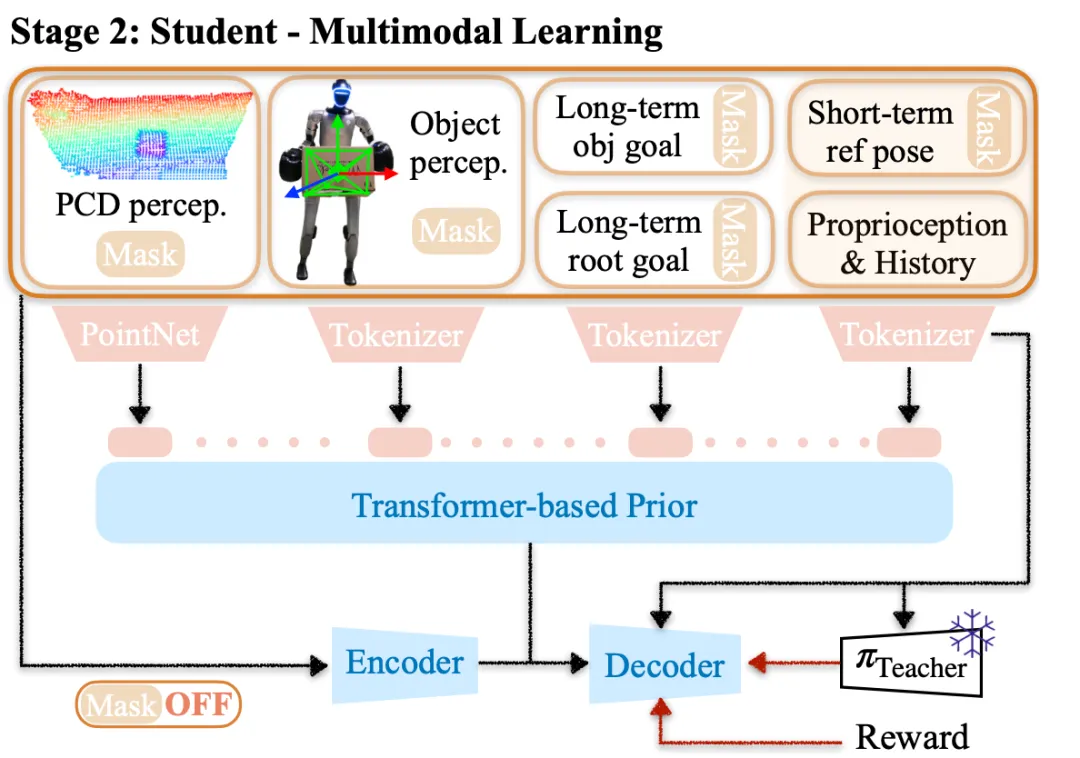
▲图 | 阶段(2)蒸馏:把教师蒸馏得到多模态学生策略,适配真实感知与稀疏目标,并额外做强化学习微调©【深蓝具身智能】编译
学生仅使用现实世界可获取观测,引入可用性掩码,训练时随机屏蔽部分输入模态,模拟部署时信息缺失:
屏蔽局部稠密参考就切换稀疏目标控制;屏蔽动捕物体观测,则使用第一人称点云完成操作。
模型采用Transformer做多模态Token融合,DAgger方式完成教师‑学生蒸馏;
损失函数除动作模仿,增加KL散度约束对齐潜变量,搭配辅助重建损失保留任务信息。
蒸馏完成后划分两套仿真环境:一部分继续维持模仿学习保留基础行为;另一部分执行目标到达的强化学习微调,对点云加入噪声、遮挡做域随机化,重点提升分布外目标的泛化能力。
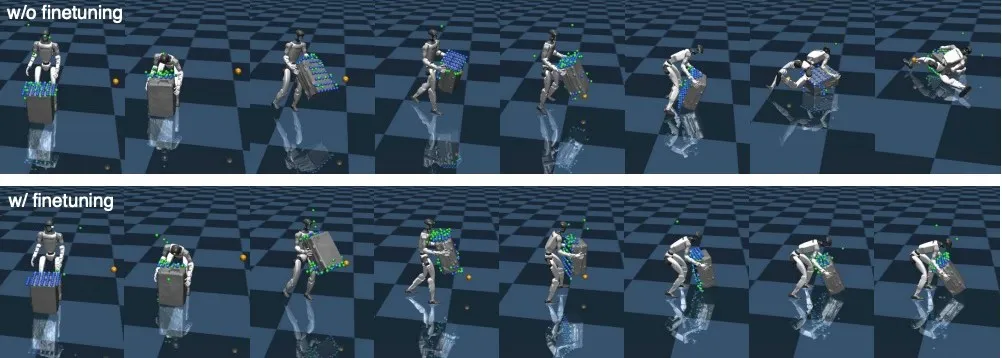
▲图 | 第一人称目标跟随的仿真对比。蓝/绿:无噪声/带噪声点云;黄色:物体目标。上方:无微调;下方:经过RL微调©【深蓝具身智能】编译
相关实验表明,RL微调对分布内任务增益有限,主要收益体现在分布外场景。
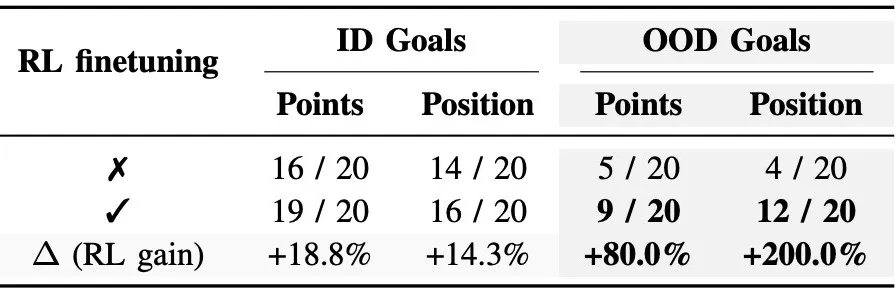
▲表 | MuJoCo仿真中,分布内ID目标与带随机偏移分布外OOD目标,分别使用第一人称点云或者仅物体位置观测的仿真‑仿真成功率©【深蓝具身智能】编译
阶段3:真机部署
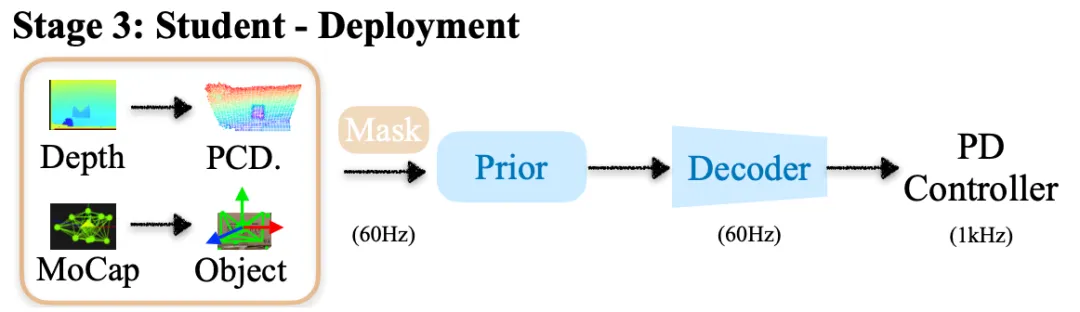
▲图 | 阶段(3)部署:学生策略运行在真实感知输入下,支持深度输入或者动作捕捉状态估计©【深蓝具身智能】编译
部署仅运行学生策略,依靠掩码切换工作模式。
Unitree G1真机上本体感知常驻;物体观测二选一:OptiTrack动捕位姿,或者头部深度相机聚类输出的物体点云。
点云经过反投影、ROI裁剪、地面去除、聚类后送入网络。
多维度实验验证
实验从运动重定向质量、稠密参考跟踪、稀疏目标执行、真机部署四个维度开展。
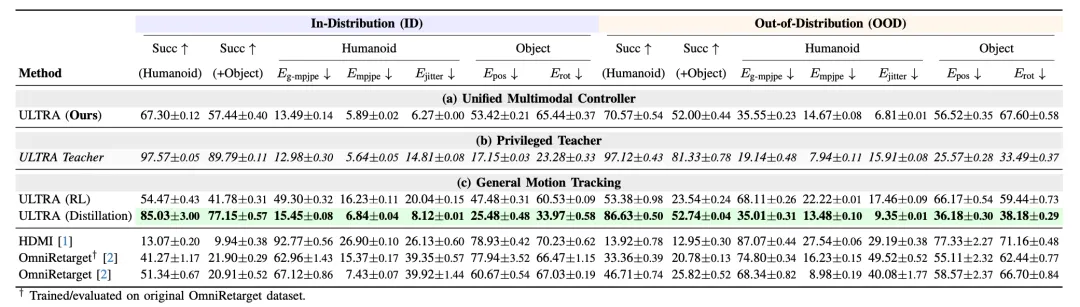
▲表 | 统一多模态控制器、特权教师及通用运动跟踪方法的分布内与分布外性能对比©【深蓝具身智能】编译
运动重定向对比
对比PHC、GMR、OmniRetarget基线,评估穿透、足部滑移、手‑物体接触脱离时长。
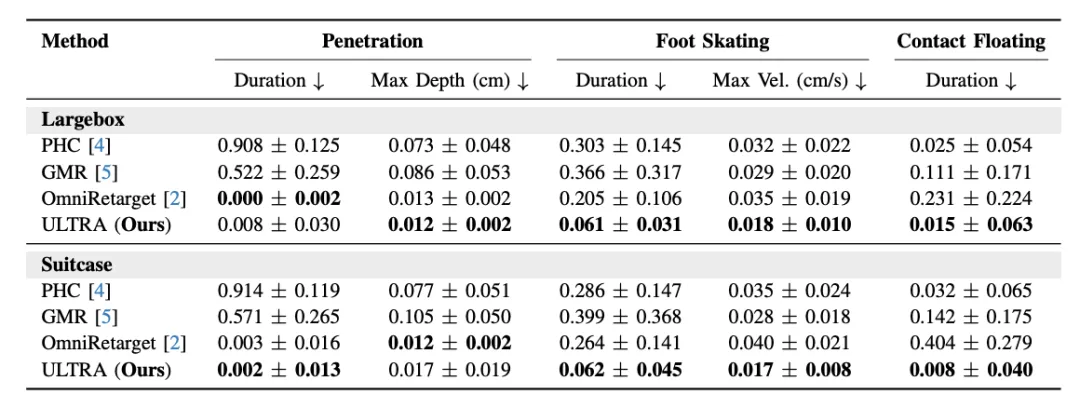
▲表 | 运动重定向物理交互质量对比,本文方法性能更优。©【深蓝具身智能】编译
ULTRA显著降低足部滑移与手物接触丢失;局限是只对训练同类盒状刚体效果好。
稠密参考跟踪仿真
对比HDMI、OmniRetarget基线,同时做多组消融实验。特权教师为性能上限(分布内人形成功率97.57%);完整多模态学生分布内人形成功率67.30%,分布外65.44%;仅做蒸馏、不做多模态统一的跟踪专用学生可达85.03%。
关键权衡:为实现一套模型兼容跟踪、稀疏目标、视觉感知,牺牲了一部分纯跟踪任务的性能上限;如果只需要动作复现,可以单独训练专用跟踪策略。
Unitree G1真机测试
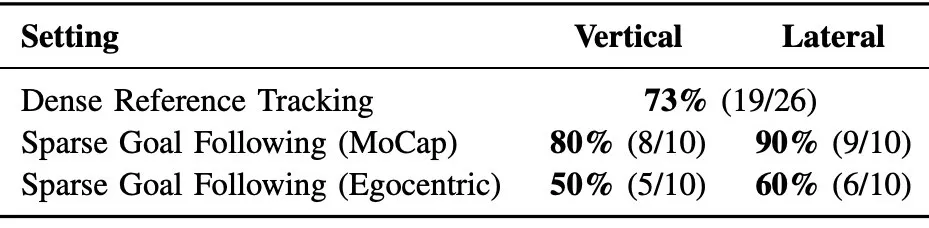
▲表 | Unitree G1人形机器人,OMOMO子集真实世界成功率。每项任务进行两轮测试。非自我中心模式采用动捕提供物体位姿跟踪;自我中心模式完全依靠机载感知。©【深蓝具身智能】编译
真机失效主要来自:物理摩擦不匹配造成抓取打滑;深度噪声/遮挡破坏点云聚类;扰动超出仿真域随机化覆盖范围,也是当前人形视觉操作普遍的sim‑to‑real痛点。
行业定位与客观局限
人形移动操作主流分为两条路线:
-
参考动作跟踪(OmniRetarget、HDMI):动作自然,但必须测试时提供参考轨迹,环境改变容易失效;
-
纯目标条件生成:不需要参考,但肢体协同、手物接触稳定性较差。
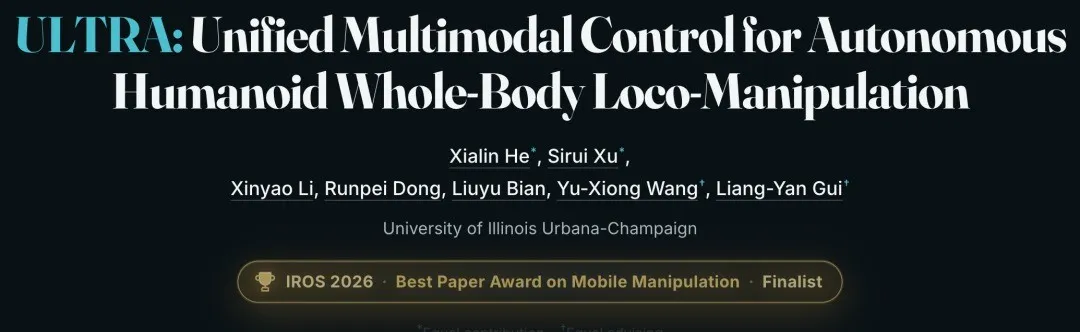
ULTRA把二者整合进同一个网络,不改动权重,依靠掩码切换工作模式,是少有的统一式全身移动操作方案,也因此获得IROS 2026 Mobile Manipulation Paper Award候选的认可。
但存在明显短板:
-
实验集中在盒状刚体,没有验证不规则物体、灵巧手精细操作;
-
第一人称感知依靠基础点云聚类,没有引入预训练视觉模型;
-
无触觉信息,抓取打滑问题未解决;
-
没有重点验证高速高动态运动场景。
小结
ULTRA的核心贡献,打破跟踪参考动作和目标驱动自主执行必须两套独立模型的范式。整套方案从物理感知驱动动捕重定向,到教师‑学生蒸馏、可用性掩码多模态学习,再到RL微调增强分布外鲁棒性,完成仿真到Unitree G1真机全链路验证。
人形控制器可以根据感知完备程度自适应切换行为模式,不必为不同任务维护多套模型。
编辑|小小怪博士
审编|具身君
Ref
论文标题:ULTRA: Unified Multimodal Control for Autonomous Humanoid Whole‑Body Loco‑Manipulation
项目链接:https://ultra-humanoid.github.io/
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
