
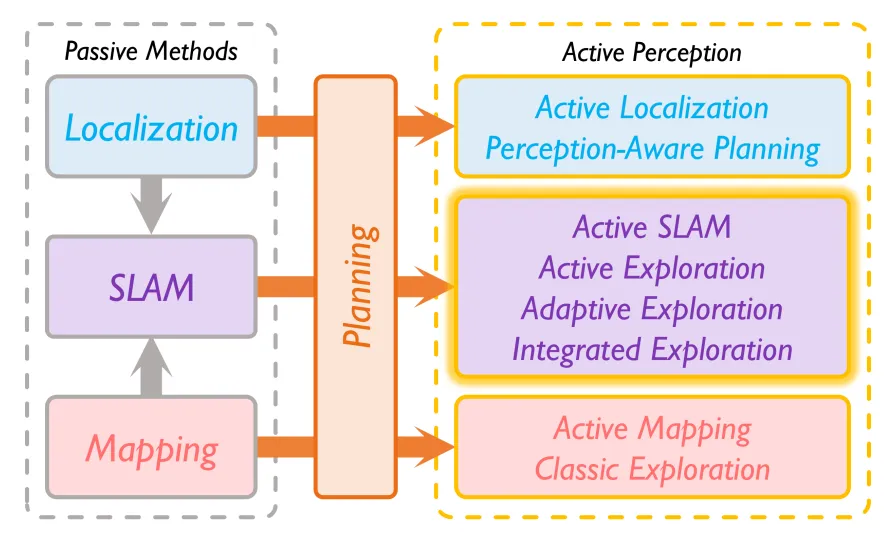
RAVEN 严格遵循主动 SLAM 的标准工作流,但每一环都把定位不确定性算进去。
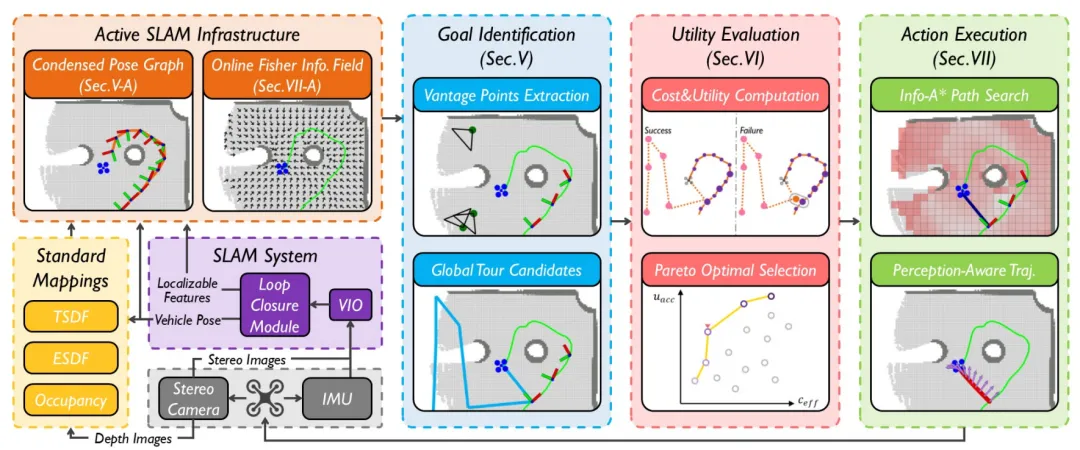
图 | RAVEN 主动 SLAM 框架的系统总览。主动 SLAM 规划分三阶段:目标识别、效用评估、动作执行,框架持续更新并基于最新观测重规划,直至探索结束 ©【深蓝AI】编译
1.1 精简位姿图(CPG):给长轨迹"瘦身"
直接把整条视觉里程计轨迹拿来做规划,节点爆炸、算不动。RAVEN 先构建一个精简位姿图(CPG):把高频状态估计压成沿轨迹按固定间距取样的稀疏节点,边编码相邻相对位姿及其协方差,检测到回环就加一条回环边。这套表示只依赖特征匹配,不绑定具体 SLAM 算法,适配性强。
1.2 目标识别:前沿 + 主动回环候选
探索目标就是经典的前沿(已知/未知边界);利用目标是主动回环(ALC)候选——从历史轨迹里挑"大概率能建立有效回环"的位姿。筛选方法很巧:把观察相似区域的 CPG 节点聚类,用 NetVLAD 视觉描述子去库里找相似帧;回访帧集中、视觉独特的簇代表,才配当回环候选——因为"认得回来"才回得去,视觉上平平无奇的帧硬做回环只会失败。
1.3 全局游览候选:不是贪心选一个,而是规划一整趟
贪心每次只看下一个目标,短视。RAVEN 先按覆盖路径规划解出若干条"最优覆盖游览"(把任务空间按体素连通性分成区域,用非对称旅行商问题 ATSP 排成最省时的走访顺序),再把下一个 ALC 候选插入到距离阈值内的边上,生成一组高质量全局游览。既借了经典探索的成熟底子,又没去穷举整个组合空间。
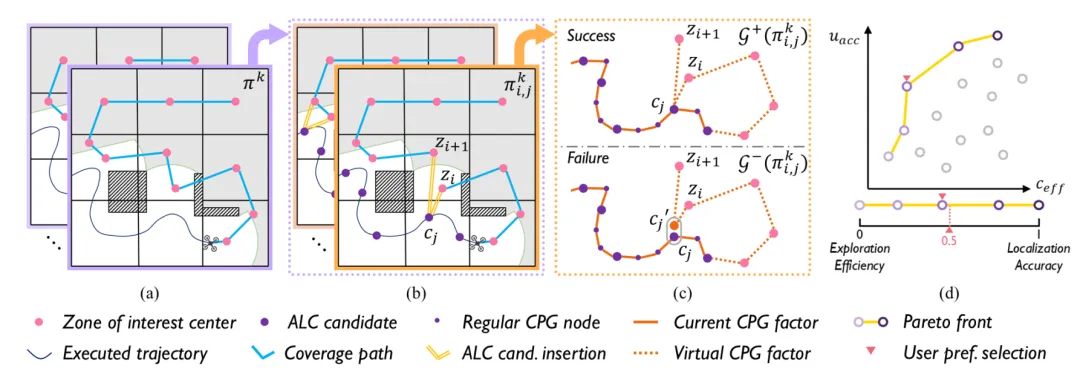
图 | 全局游览候选选择过程。(a) 连接所有感兴趣区域中心的最优覆盖路径;(b) 向覆盖路径插入 ALC 候选生成的全局游览候选;(c) 虚拟 CPG 的两种配置,上图 G⁺ 与下图 G⁻ 分别表示回环成功与失败;(d) 全局游览候选的效用空间,黄色折线为帕累托前沿、紫色圆为帕累托最优解,粉色倒三角为按优先级参数 λ=0.5 在帕累托前沿插值点上选出的最终全局游览 ©【深蓝AI】编译
探索效率和定位精度是两种量纲完全不同的东西(时间 vs. 信息量),硬塞进一个式子就回到手工标权重的老路。RAVEN 的选择是分开算、用帕累托序比较:
-
探索效率成本 = 这条游览预估的完成时长(各段遍历时间累加,插入回环候选就加上绕路代价);
-
定位精度效用 = 预测这条游览执行后整个位姿图的信息量。做法是往当前 CPG 上"虚拟追加"节点,区分回环成功(G⁺)和失败(G⁻)两种图,各自算全图 Fisher 信息的 D-最优性,再按回环成功概率加权。
这里有个细节:回环成功概率不是拍脑袋,而是用"两次访问同一位置的估计差"的协方差,看漂移是否小到能可靠走回去。所以效用评估不只看理论收益,还看实操可行性——这也是后面消融里最值钱的一环。
目标定了,怎么飞过去才不把定位搞坏?RAVEN 引入在线 Fisher 信息场(OFIF):把每个体素里"能观测到多少可匹配的局部特征点"压缩成可复用的位置因子,查询时再乘上姿态相关的可见性,常数时间拿到任意相机位姿的定位信息量。
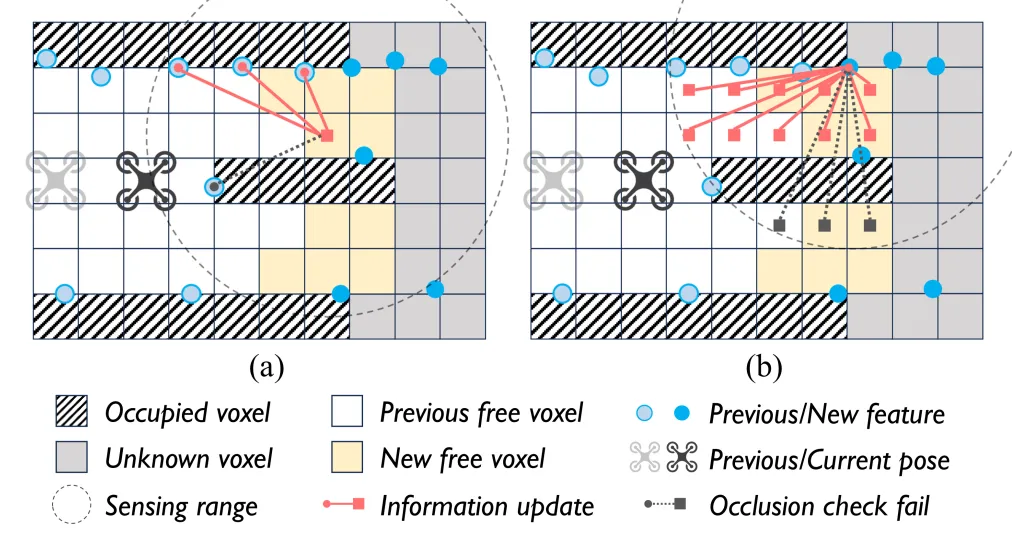
图 | OFIF 增量构建的两步更新流程。(a) 步骤 1:每个新的自由 OFIF 体素更新感知范围内历史可定位特征;(b) 步骤 2:每个新检测到的可定位特征更新周边全部自由 OFIF 体素。©【深蓝AI】编译
两个关键设计:
-
旋转不变的 Fisher 度量:论文特意对比了左扰动和右扰动两种参数化。左扰动的 Fisher 信息会随特征点离世界原点的距离变大而虚高,跨位置没法比;改用右扰动后,信息量只取决于相机系坐标,T-最优性保持旋转不变,还能写成闭式解——这是 OFIF 能在体素里存、能实时查的基础。
-
感知敏感的轨迹优化:位置轨迹先做一次 info-A* 搜索(把"信息惩罚"加进路径代价,让初始路径主动绕开无纹理、没特征的区域),再做 B-spline 最小时间优化;偏航轨迹也类似,先在关键点上采样偏航候选、用图搜索找最优偏航方向路径,再做带感知代价的偏航优化。这样飞行动作本身就在给定位"攒信息",而不是消耗它。
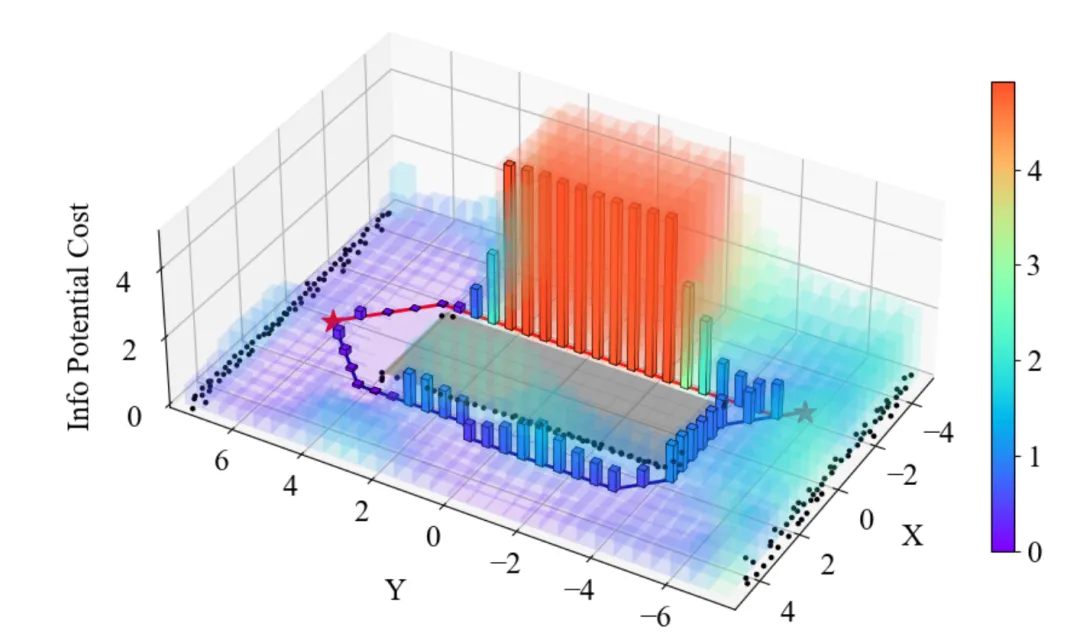
图 | info-A* 搜索与标准 A* 搜索的 2D 对比。中央矩形为障碍、黑点为局部特征;透明彩虹直方图表示每个体素的信息势代价。info-A* 路径(深蓝)偏好纹理丰富、信息惩罚低的区域,标准 A*(红)走最短路径、穿越特征稀少区 ©【深蓝AI】编译
4.1 仿真基准:RAVEN 撑起帕累托前沿
EPEE+ 仿真器(在 EPEE 上加了多相机渲染、IMU 噪声和视觉 SLAM)里,与 SRE、REAL、ExplORB、FALCON 四个 SOTA 在 Corridor、Warehouse、Office、Apartment 四个场景对比,每场景 10 次运行。
核心结论很清晰:
-
FALCON 只图快:探索时间最短(Office 64.6s),但只优化探索效率、不做回环也不做感知规划,ATE 最高(0.49m);
-
RAVEN-0.0(λ=0) 探索时间和 FALCON 相当(Office 76.3s),但靠感知敏感规划把 ATE 压到 0.26m;
-
RAVEN-1.0(λ=1) 疯狂回环(Office 平均 204 次回环),ATE 压到全场最低 0.08m,代价是探索时间拉到 120.4s;
-
RAVEN-0.5 是折中,探索 95.2s、ATE 0.14m,均衡表现优于三个主动 SLAM 前辈(SRE/REAL/ExplORB 探索更久、误差还更高)。
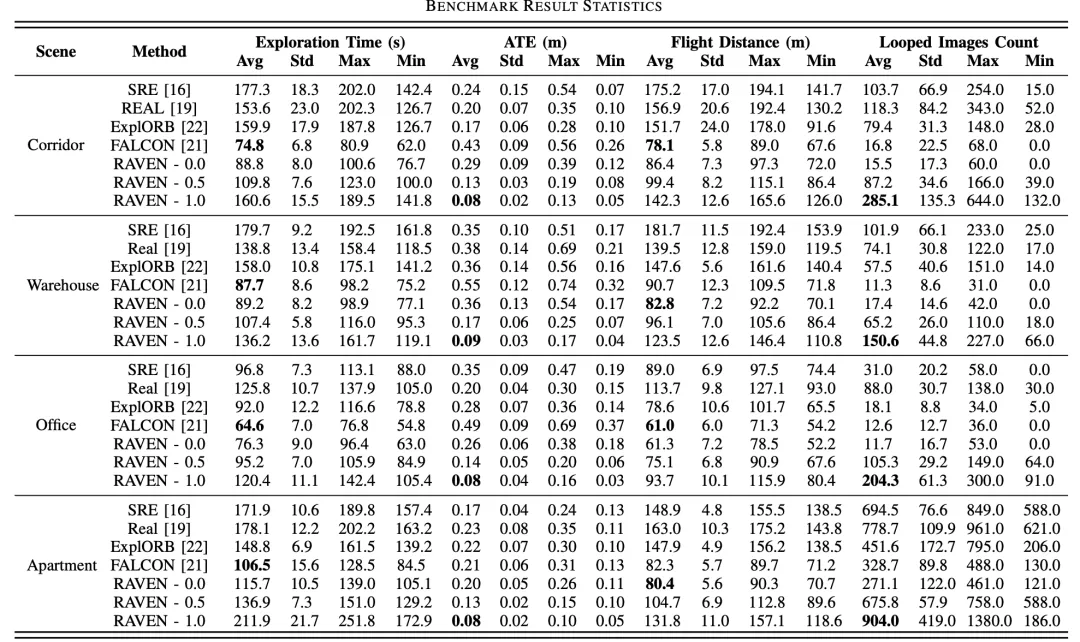
表 | 基准结果统计。SRE、REAL、ExplORB、FALCON 与 RAVEN在四个场景下 10 次运行的平均/标准差/最大/最小统计,覆盖探索时间、ATE、飞行距离与回环图像对数 ©【深蓝AI】编译
指标要先说清口径:ATE 是估计轨迹相对仿真真值的 RMSE,单位米,越小越好;回环图像对数只是"SLAM 匹配成功的图像对数量",是回环频率的代理,不代表回环质量。而 λ=1 的低 ATE 是拿时间换的——不是所有任务都值得把探索时间拉长一倍去抠那 0.1 米精度,这也是论文强调"任务优先级"而非"一味求准"的原因。
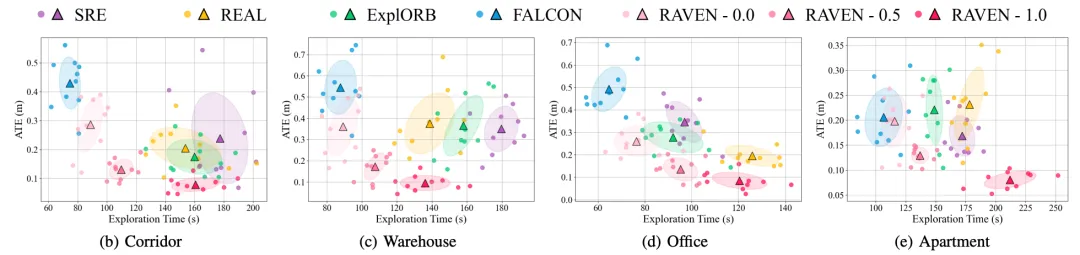
图 | 基准结果图:探索时间与 ATE 的权衡,平均值为三角、1-σ 置信椭圆为色块。RAVEN(三档 λ)与 FALCON 共同构成四场景下的帕累托前沿 ©【深蓝AI】编译
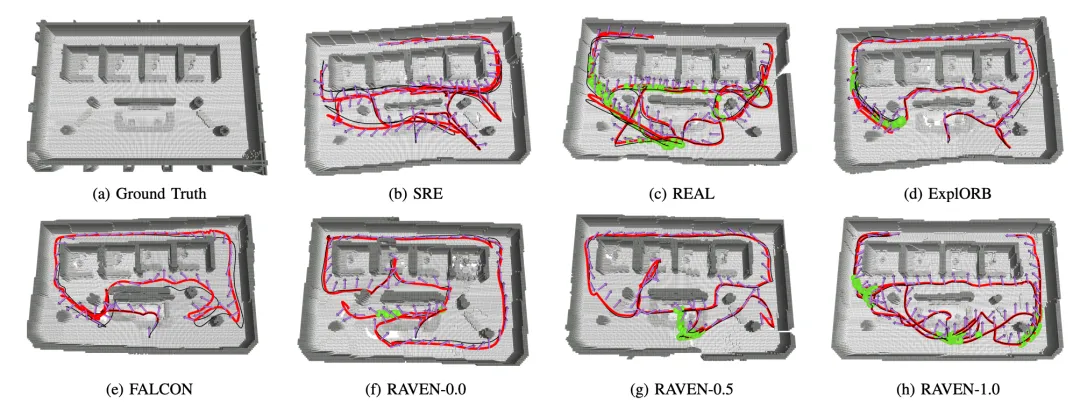
图 | Office 场景下所有基准算法的最终执行轨迹与重建体积地图。黑线为真值轨迹,绿点为检测到的回环 ©【深蓝AI】编译
4.2 消融:三个机制各有各的价值
-
感知敏感规划到底值不值:关掉感知(PAG)后,各 λ 下平均 ATE 比感知敏感版高 12.74%——花不到 5% 的时间,换最高 60% 的定位精度,这笔账很划算;
-
λ 是个好旋钮:λ 从 0 到 1 渐变,探索时间单调升、ATE 单调降,验证了它作为任务级控制变量的有效性,而不是玄学参数;
-
回环概率加权不可省:不做概率加权,系统因为"怕绕路"一直拖延回环,平均只做 10 次回环、ATE 0.45m;用统一阈值又太保守,只做 71.8 次、ATE 0.46m;而 RAVEN 的概率加权在"理论收益 × 实操可行性"间取平衡,做 150.6 次回环、ATE 压到 0.09m——回环不是越多越好,能成的回环才算数。
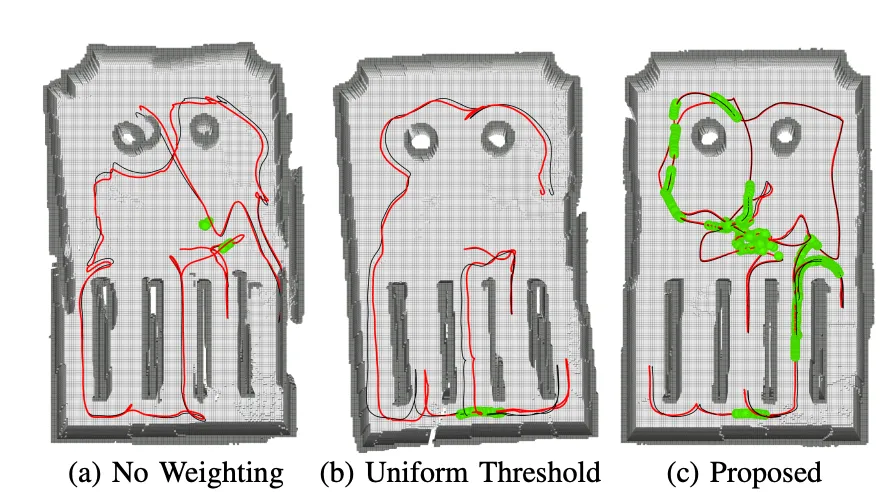
图 | 回环概率加权消融结果:(a) 无加权、(b) 统一阈值、(c) 本文方法的重建地图与估计/真值轨迹(红/黑曲线)及检测回环(绿点)©【深蓝AI】编译
4.3 大场景可扩展 + 全机载实飞
80×20×2m 的密集植被"森林"仿真场景,λ=0.5 完成探索耗时 1081.6s、轨迹长 759.6m、最终 ATE 0.664m;每次重规划平均仅 0.057s,内存全程封顶 2.8GB——实时性和可扩展性都达标。
真实世界三个场景(带 OptiTrack 真值的 Flight Arena、纯白墙挑战的 Campus Hallway、大型地下 Parking Lot)全机载飞行,三档 λ 各 3~5 次试飞(表4)。结论与仿真一致:λ 从 0 升到 1,探索时间/距离上升、定位精度改善;在无真值轨迹的另外两场景用"重建地图到真值点云最近邻距离(NND)"间接评估,λ=1 相对 λ=0 的 NND 误差分别降 50% 和 62.5%——Campus Hallway 里两根圆柱在 λ=0 下被漂移压变形,λ=1 下恢复原样。
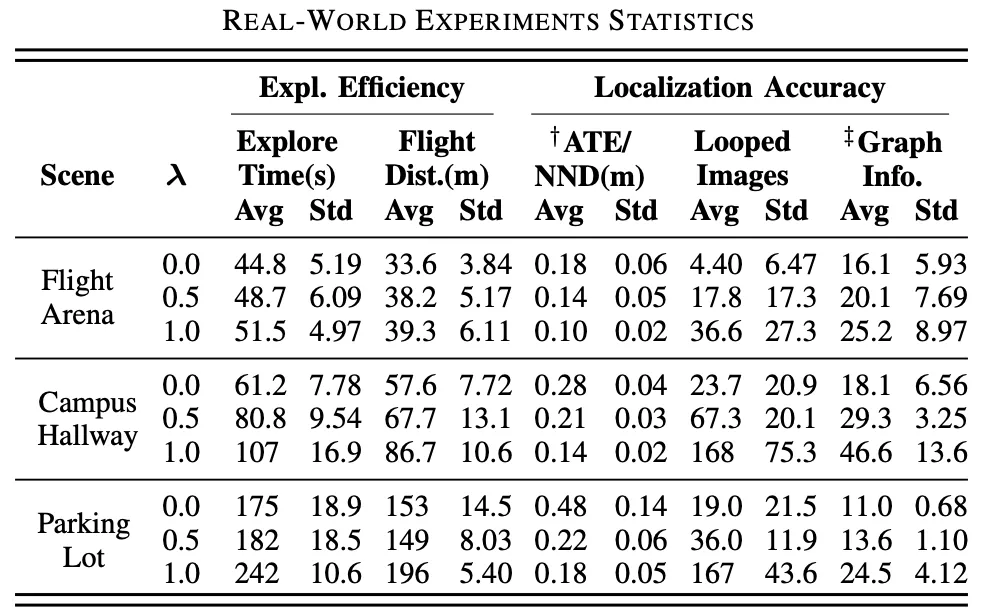
表 | 真实世界实验统计。Flight Arena 用动捕真值算 ATE;Campus Hallway 与 Parking Lot 无真值里程计,改用重建地图与真值场景点云的 NND 评估;图信息为探索完成时整个 CPG 图的近似 Fisher 信息 ©【深蓝AI】编译
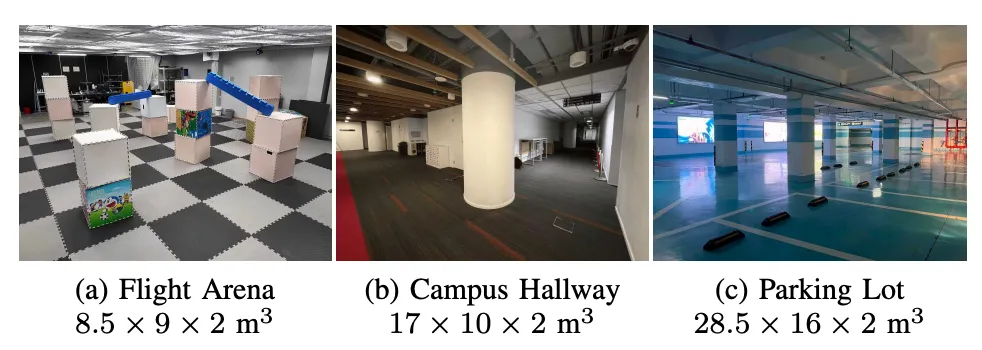
图 | 真实世界实验场景照片:Flight Arena、Campus Hallway、Parking Lot ©【深蓝AI】编译
RAVEN 的启示在于一个"分而治之"的工程哲学:把两个量纲不同、不可比的目标拆开算,用帕累托最优保住所有合理折中,再用一个 0~1 的优先级参数把"选择权"还给用户——比硬塞权重函数、或默默替你平衡,都更透明也更实用。配合"精简位姿图 + 在线 Fisher 信息场 + 感知敏感轨迹",它把定位不确定性从头到尾纳入了主动 SLAM 的每个环节,且全程机载实时。
当然,实机大场景、弱纹理鲁棒性、统计严谨性仍是它前路上的硬骨头。作为把"主动探索"和"主动定位"真正统一起来的空中机器人方案,它给这个冷门赛道立了一个可复现、可调参的实用标杆。
编辑|小小怪博士
审核|阿蓝
参考论文:
论文标题:RAVEN: A Unified Active SLAM System for Rapid Autonomous Visual Exploration with Aerial Robots under Localization Uncertainty
论文链接:https://arxiv.org/pdf/2610.37111
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
