

“数据是具身智能界的石油”——其实不是。
——50万小时的困境
遗憾地说,标题甚至不算夸大。
先看一组行业账目。
某国内头部具身智能企业,在预计投入的20亿元科研创新费用中,仅数据基础设施建设一项的占比就超过40%。
某上市公司,公开财报显示2025年全年在数据相关领域的硬性投入达1.5亿元,占到了全年研发投入的30%。
特斯拉在Optimus项目上的账本则更为庞大,2022-2024 年直接研发投入累计已超过 30-40 亿美元,其中数据采集与处理占比约三分之一,超10亿元。
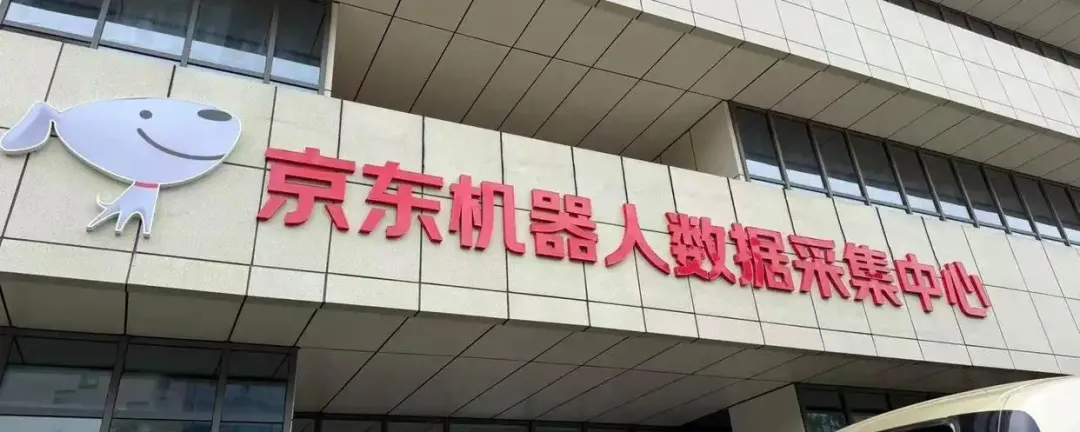
▲图源网络 | 京东机器人数据采集中心,投资1亿。©【深蓝具身智能】编译
数据,是一门生意。
可惜,数量欺骗不了质量。
但在错误的卷采集时长、卷规模的路上狂奔,不是勇气,是惊人的浪费。
当前有超过60%的公司选择直接删除至少一半此前花费重金采集的历史数据(因为早期质量太差、格式不统一、与新模型架构完全不兼容)。
据斯坦福大学今年4月发布的《AI Index Report 2026》显示,通用人形机器人在真实家庭场景任务成功率仅12%左右,从 2024 到 2026 年,真实家庭场景性能几乎停滞不前,两年间提升不到 2 个百分点。
截至2026年初,即便在如此万马奔腾的投入规模下,全球所有的高质量真实物理交互数据加在一起依然只有约50万小时(不及大语言模型训练数据的两万分之一)。
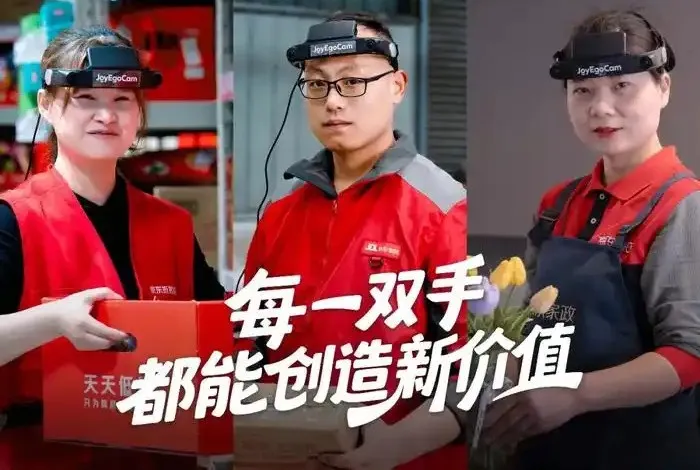
▲图源网络 | 某大厂开展“人类历史上规模最大的数据采集行动”。©【深蓝具身智能】编译
真正有效的10%,是什么?
只有在认清“90%投入无效”这个残酷前提之后,剩下的10%才能真正聚焦到改变格局的事情上。(从眼前各种光鲜的融资额和百万小时规模PR中抽离出来)
不同于大语言模型可依托互联网上近乎无限的高质量文本,具身智能走向通用人工智能(AGI)的最大阻碍之一,恰恰是操作数据的极度匮乏。
而从早期的网络视频预训练,到耗资巨大的遥操作采集,再到仿真器中的海量合成,机器人操作数据的采集范式经历了一场漫长而艰难的进化。
本文将沿上述进化脉络,结合各路线的代表性成果,系统对比各阶段数据范式的价值与局限,并重点阐释通用机器人操作能力的数据之关键。
阶段一:从互联网汲取——网络视频数据的早期尝试
面对机器人操作数据的短缺,研究人员最直观的反应是:
能否像训练语言模型那样,直接利用互联网上海量的现成视频?网络视频(如YouTube上的烹饪、组装教程)蕴含着极其丰富的人类活动语义和常识知识。
在这一阶段,代表性工作如R3M(2022年,Meta AI/Stanford University)尝试利用Ego4D视频预训练视觉表征,在下游机器人任务中提升了数据效率。
RT-2(2023年,Google)则更进一步,将网络图文数据与机器人遥操作数据联合训练,使机器人具备了初步的语义理解和常识推理能力。
这些工作证明了网络视频在提供通用视觉表征方面的价值,使得机器人在面对新环境和新物体时具备了初步的常识理解能力。
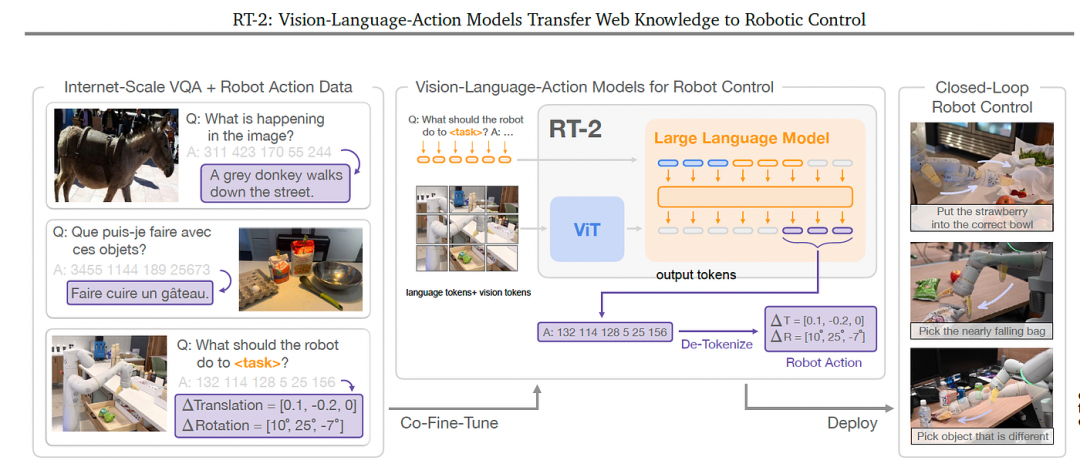
▲图1 | RT-2模型架构。通过联合训练互联网规模的视觉-语言-动作(VQA)数据和机器人动作数据,使模型具备了初步的常识推理能力。©【深蓝具身智能】编译
然而,网络视频用于机器人操作学习的局限性同样明显。
EgoDex(2026年,Apple,ICLR 2026)研究中指出,未经结构化的原始视频数据在图像分布上与灵巧操作任务之间存在着难以弥合的鸿沟。
更关键的是,这些视频大多是第三人称视角,摄像机机位固定,与机器人执行任务时的视角差异巨大。
此外,网络视频缺乏精确的手-物交互细节,更没有机器人控制所需的动作标注(如关节角度、末端执行器位姿)。
这使得“网络视频数据”只能停留在"提供视觉特征"的浅层应用,无法直接教会机器人如何完成精细操作。
阶段二:让机器人自己演示——遥操作数据的规模化
既然网络视频缺乏动作标注,研究人员便转向了最直接、最精确的数据获取方式:遥操作(Teleoperation)。
这一阶段见证了机器人操作数据集的爆发式增长:
-
从Google的RT-1、BridgeData V2;
-
到汇聚了22种机器人、来自21个研究机构的60个数据集、包含100万以上轨迹的Open X-Embodiment(2024年);
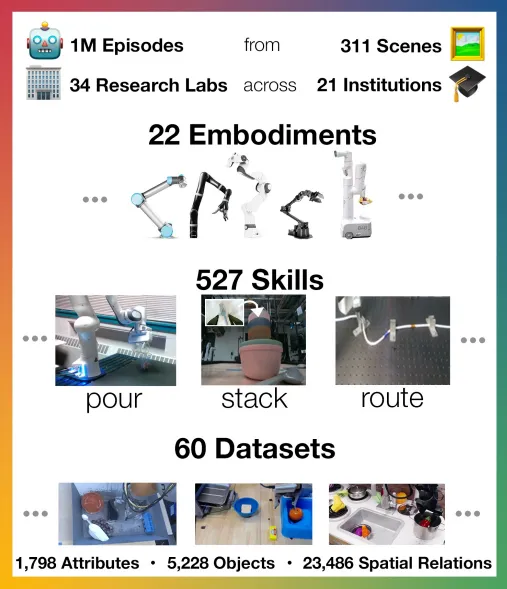
▲图2 | Open X-Embodiment 数据集概览。汇聚了22种不同的机器人本体、60个数据集,总计包含超过100万条操作轨迹。©【深蓝具身智能】编译
-
再到覆盖564个场景、86种任务、50位采集者、共7.6万条轨迹的DROID数据集(2024年),遥操作数据在规模和多样性上不断突破。
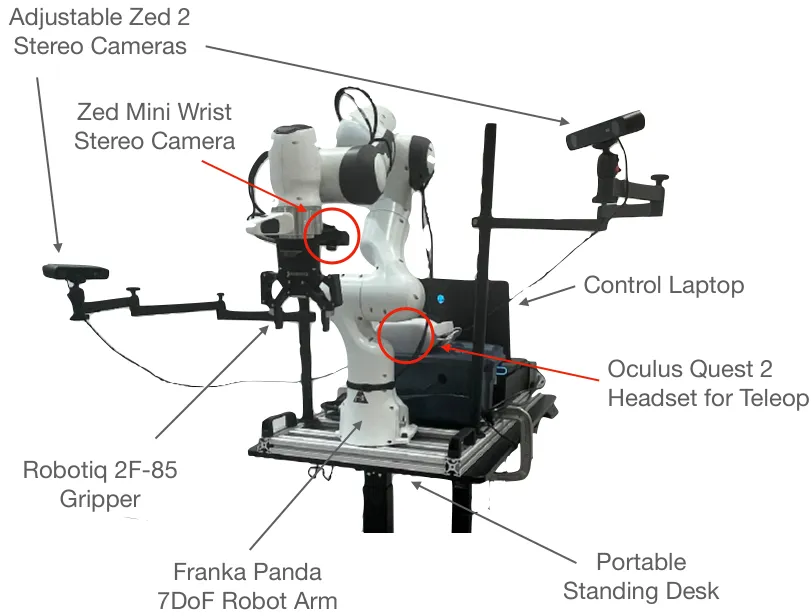
▲图3 | DROID数据集的采集系统。包含Franka Panda机械臂、两个可调节的Zed 2立体摄像头、腕部Zed Mini摄像头和Oculus Quest 2遥操作头显,展示了遥操作数据采集的硬件复杂性。©【深蓝具身智能】编译
这些数据集为机器人提供了精确的动作标签,使得端到端的模仿学习成为可能,并直接催生了跨具身(Cross-Embodiment)学习。
然而,遥操作模式存在一个难以突破的规模瓶颈。
每一条遥操作轨迹的背后,都需要昂贵的机器人硬件、复杂的标定系统,以及一位熟练的人类操作员耗费大量时间进行演示。
EgoDex研究团队明确指出,遥操作受限于物理机器人的操作瓶颈,目前尚不清楚如何将这种范式继续扩展到更大的规模。
同时,NVIDIA在发布GR00T N1基础模型时也指出,由于不同机器人在传感器、自由度、控制模式上的巨大差异,现有的遥操作数据往往形成了一个个"数据孤岛"(Data Islands),难以整合成像互联网文本那样连贯的、可用于训练真正通用模型的大规模语料库。
阶段三:让仿真器生产数据——合成数据的崛起
为了摆脱对人类操作员的严重依赖,研究人员将目光投向了物理仿真器。如果能在虚拟世界中自动生成数据,那么数据的边际成本将趋近于零。
MimicGen(2023年,NVIDIA/UT Austin)及其后续工作DexMimicGen展示了合成数据的巨大潜力。
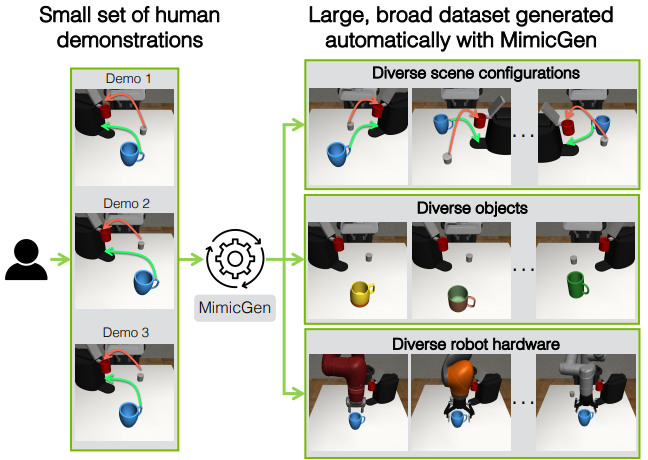
▲图4 | MimicGen 系统概览。通过对少量的人类演示进行轨迹变换和场景随机化,自动生成大规模的机器人操作数据集。©【深蓝具身智能】编译
这类方法通过将少量人类初始演示作为种子,在仿真器中进行轨迹变换、物体替换和场景随机化,从而批量生产出海量的操作数据。
在NVIDIA的GR00T N1模型训练中,研究团队利用DexMimicGen在短短11小时内生成了780,000条仿真轨迹
——这相当于人类操作员连续工作6,500小时(约9个月)的工作量。
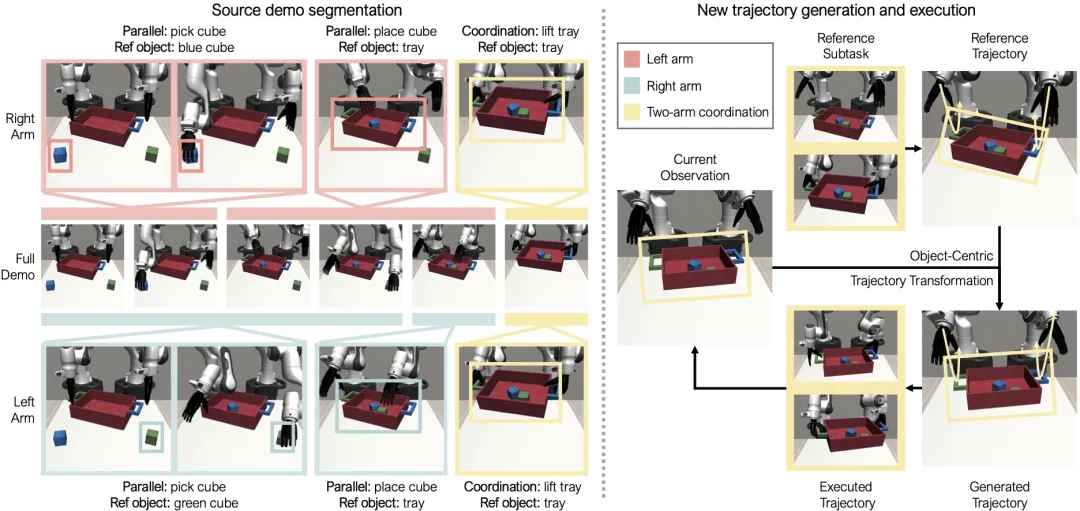
▲图5 | DexMimicGen的数据生成流程。展示了在仿真环境中如何对源演示进行分割,并生成新的双臂协调操作轨迹。©【深蓝具身智能】编译
同样的,仿真数据并非万能解药。仿真器中的物理引擎(如接触、摩擦、柔性形变)与真实世界之间始终存在着Sim-to-Real Gap。
NVIDIA的研究人员坦言,某些复杂任务(例如将网状杯子中的液体或细小颗粒倒入垃圾桶)在仿真环境中极难生成和模拟。
此外,仿真数据的任务分布受限于预先构建的3D资产库,缺乏真实世界中无限长尾的语义多样性。
阶段四:回归人类视角——第一视角数据的独特价值
历经了网络视频的"失焦"、遥操作的"昂贵"、仿真的"失真",具身智能的数据进化路线最终收敛到了一个兼具规模与精度的范式:人类第一视角(Egocentric)数据。
以Ego4D(2022年,Meta/CMU等,3,670小时日常活动视频)和EPIC-KITCHENS为代表的早期第一视角数据集已经证明了其在捕捉人类日常活动方面的潜力。
而最近爆发的一系列研究:Georgia Tech的EgoMimic(CoRL 2024 Workshop)、EgoDex 以及AoE系统(Always-on Egocentric,2026,蚂蚁集团),则彻底将第一视角数据推向了机器人灵巧操作的舞台中央。
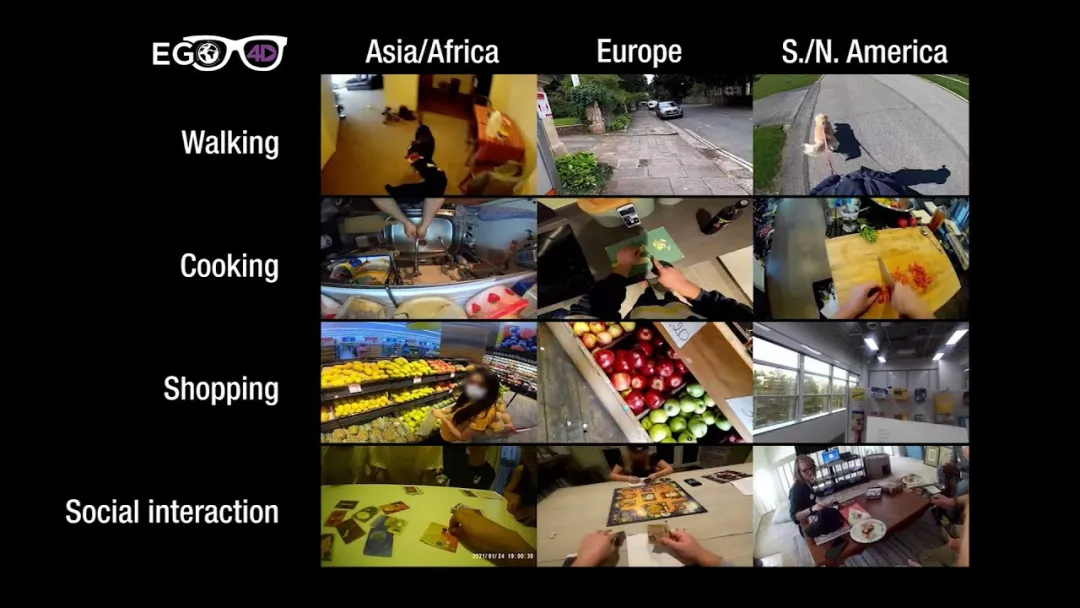
▲图6 | Ego4D 数据集概览。展示了跨越全球多个国家和地区的日常人类活动第一视角视频,为具身智能提供了丰富的场景先验。©【深蓝具身智能】编译
在NVIDIA发布的GR00T N1基础模型中,研究团队明确提出了"数据金字塔"的训练框架:
-
海量的网络数据和人类第一视角视频,包括Ego4D、EPIC-KITCHENS、HOI4D等,构筑了金字塔的底层基础,提供广泛的视觉和行为先验;
-
仿真合成数据充实了中层的技能多样性;
-
而少量高精度的真实机器人遥操作数据则在塔尖完成最终的物理对齐。
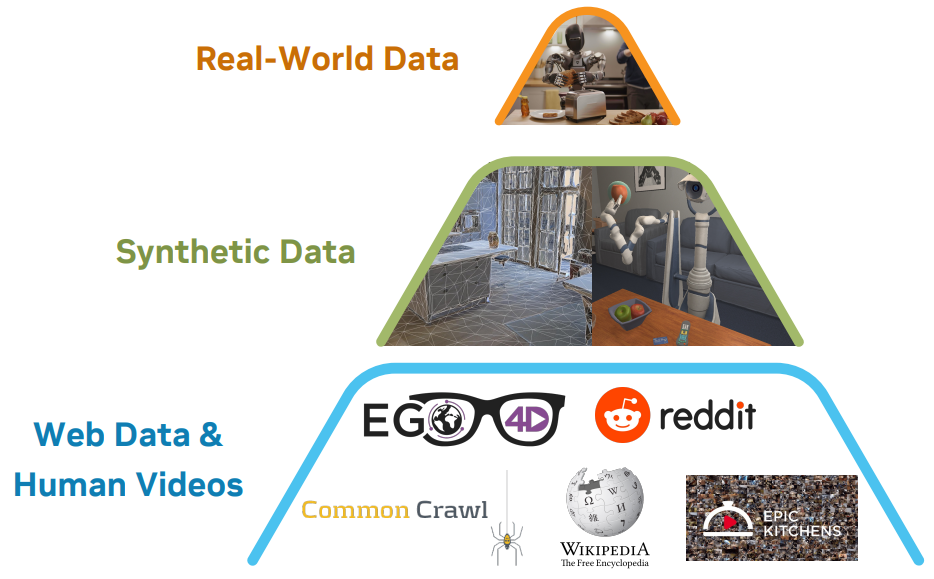
▲图7 | NVIDIA GR00T N1 提出的数据金字塔。将海量人类第一视角视频和网络数据作为底层基础,支撑起整个具身模型的训练框架。©【深蓝具身智能】编译
其中,第一视角数据的独特价值体现在以下三个核心维度:
极致的"被动可扩展性"(Passive Scalability)
与遥操作需要人类刻意去"教"机器人不同,第一视角数据的采集可以是被动且无感的。
Apple的EgoDex数据集利用Vision Pro头显,在日常生活中自然采集了829小时、涵盖194种任务的灵巧操作数据,规模比现有的手部操作数据集大了近一个数量级;
而AoE系统更是将采集门槛降到了极致:通过一个成本不到20美元的颈挂式手机支架和端云协同的APP,任何人都可以随时随地采集高质量的操作数据。
这种被动可扩展性,使得操作数据有望像互联网文本一样,实现自然的规模增长。
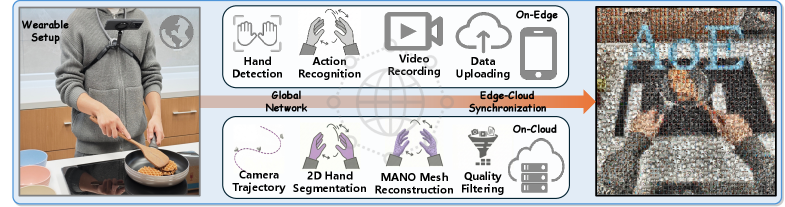
▲图8 | AoE (Always-on Egocentric) 系统概览。利用低成本的颈挂式手机支架,结合端云协同架构,实现随时随地的大规模第一视角数据采集。©【深蓝具身智能】编译
较好的"视角对齐"与迁移潜力
人类佩戴头显或胸前挂载设备采集的第一视角视频,人形机器人也大多在头部或胸部配备了主摄像头,在视角上保持高度一致。
这种"视角对齐"有望减少从人类演示到机器人执行过程中的Domain Gap。
EgoMimic的研究表明,在机器人遥操作数据的基础上,加入人手第一视角数据进行协同训练,机器人策略的任务得分相比纯遥操作基线(ACT)最高可提升228%,绝对成功率最高提升33%。
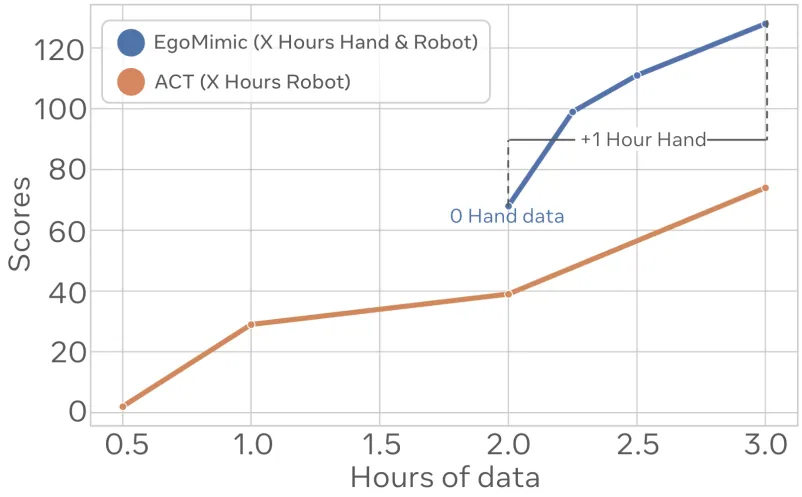
▲图9 | EgoMimic 实验结果。蓝线(EgoMimic)在固定2小时机器人数据的基础上,加入人手第一视角数据后,性能显著优于仅使用机器人数据的ACT基线(橙线)。图中标注的"+1 Hour Hand"对应了显著的性能跃升。©【深蓝具身智能】编译
极其丰富的精细操作语义
第三人称网络视频往往看不清手部细节,而第一视角数据则能以极近的距离捕捉手-物交互的微妙动态。
EgoDex不仅提供了高清视频,还利用设备自带的SLAM和多摄像头系统,精确追踪了人体上半身以及双手每只手25个关节的3D位姿。
这种包含精确3D骨骼信息的灵巧操作数据,涵盖了系鞋带、折叠衣物、拧开瓶盖等高度复杂的任务,为机器人学习精细的接触力和空间关系提供了不可替代的监督信号。
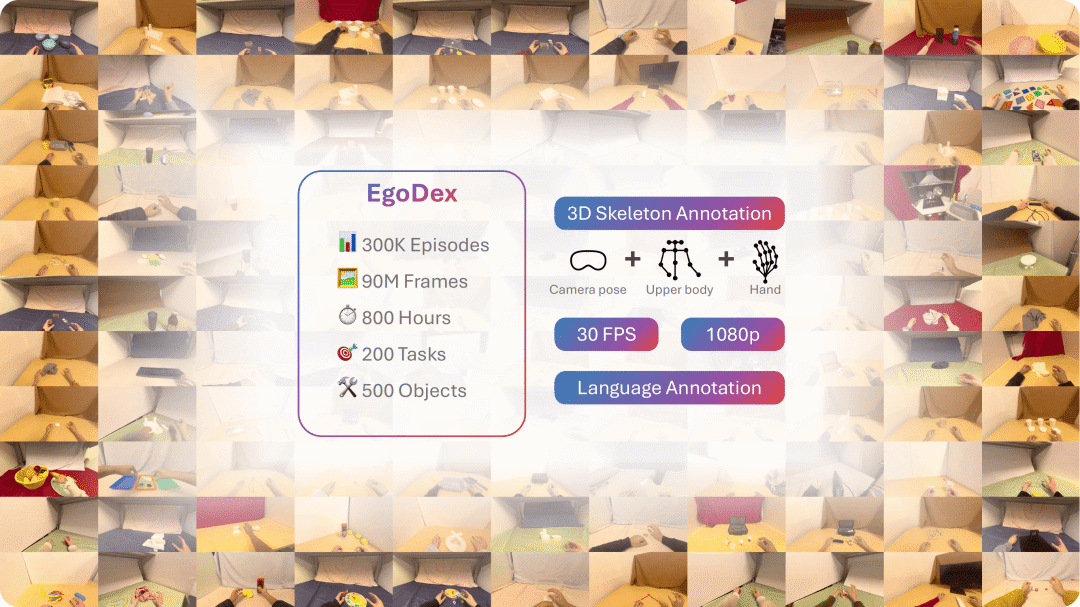
▲图10 | EgoDex数据集概览。利用Apple Vision Pro采集,包含338K个演示片段、90M帧画面、829小时视频,涵盖194种任务,并提供相机位姿、上半身骨骼和手部3D骨骼标注。©【深蓝具身智能】编译
各阶段数据范式对比分析
网络视频(如 R3M, RT-2)的核心价值在于提供通用视觉表征与常识语义。
然而,其主要局限性在于缺乏动作标注,视角与机器人执行时不匹配,且操作细节往往比较模糊。
遥操作(如 Open X-Embodiment, DROID)的核心价值在于提供精确的动作标注,支持端到端学习。
但其局限性也非常明显,即采集成本极高,扩展性差,容易形成数据孤岛。
仿真合成(如 MimicGen, DexMimicGen)的核心价值在于零边际成本和极高的生成效率。
不过,其主要局限性在于 Sim-to-Real Gap,难以模拟复杂的物理交互和长尾场景。
第一视角(如 EgoDex, EgoMimic, AoE)的核心价值在于被动可扩展、视角对齐以及丰富的精细操作语义。
需要指出的是,第一视角数据并非没有挑战。
-
首先是动作标注问题。
Ego4D等早期数据集缺乏精细的动作标注,需要通过后处理(如姿态估计、手部追踪)来提取可用的动作信号,而这些后处理的精度往往不如直接采集时的标注。
EgoDex通过在采集时直接记录3D手部骨骼解决了这一问题,但代价是需要专用硬件(Apple Vision Pro)。
-
其次是具身迁移(Retargeting)问题。
人手与机器人末端执行器在形态上存在显著差异,如何将人手的精细动作准确映射到机器人的夹爪或多指手,仍然是一个开放的研究问题。
目前,EgoMimic等工作通过共享视觉观测空间(而非直接迁移动作)来规避这一问题,但这并不能完全解决所有场景下的迁移挑战。
-
最后是数据质量控制问题。
AoE等被动采集系统虽然极大地降低了采集门槛,但也引入了大量噪声数据(如非操作场景、遮挡、运动模糊等),需要复杂的自动化过滤和标注流水线来保证训练数据的质量。
数据供给的答案远未定型
具身智能的数据探索还处在极早期。没人确切知道通用操作能力最终需要怎样的数据配方,在这个意义上,试错本身就是探索的必要部分。
但“试错”与“在已验证低效的路线上持续下注”是两码事。
纵观机器人操作数据的进化历程,从网络视频提供的语义先验,到遥操作赋予的精确动作指引,再到仿真器中近乎零成本的规模化合成——
每一次范式转移本质上是具身智能领域在"规模"与"精度"之间不断寻找最优解的过程。
然而一个基本事实仍未改变:高质量真实交互数据的总量尚不足50万小时,这一量级鸿沟远非单一采集手段所能弥合。
更关键的是,规模与精度往往不可兼得:网络视频规模庞大却缺乏动作标注,遥操作精度极高却难以扩展,仿真数据取之不尽却面临难以消除的sim-to-real gap。
任何单一范式,都无法同时承载通用操作能力所要求的规模、精度与真实性。
这意味着,问题已不再是“选择哪一条路线”,如何让这些各具短长的数据源在统一的框架下形成合力。
这四个阶段并非相互排斥的替代关系,而是构成了一个互补的数据生态。正如NVIDIA在GR00T N1中所构建的"数据金字塔"——
在这座金字塔中,人类第一视角数据凭借其被动可扩展性、视角一致性和精细操作语义,正在成为承上启下的关键基石:向下衔接语义理解,向上支撑技能迁移。
在这条通往可泛化物理交互的漫长道路上,数据供给的答案远未定型。每一次突破,都要求我们对看似确定的路线保持追问。
数据不是石油,是稀土。
数据不是新时代的石油,石油挖出来就能烧。
具身智能的数据,是稀土。
一吨矿石里,只有几克能点亮反应堆。真正的壁垒,从来不在你囤了多少矿石,而在你从矿石里提纯出了多少浓缩物。
这才是价值。
编辑|阿豹
审编|具身君
Ref
3. EgoDex: Learning Dexterous Manipulation from Large-Scale Egocentric Video(https://arxiv.org/pdf/2505.11709)
4. Open X-Embodiment: Robotic Learning Datasets and RT-X Models(https://arxiv.org/pdf/2310.08864)
5. DROID: A Large-Scale In-the-Wild Robot Manipulation Dataset(https://arxiv.org/pdf/2403.12945)
6. GR00T N1: An Open Foundation Model for Generalist Humanoid Robots(https://arxiv.org/pdf/2503.14734)
7. MimicGen: A Data Generation System for Scalable Robot Learning using Human Demonstrations(https://arxiv.org/pdf/2310.17596)
8. Ego4D: Around the World in 3,000 Hours of Egocentric Video(https://arxiv.org/pdf/2110.07058)
9. EgoMimic: Scaling Imitation Learning via Egocentric Video(https://arxiv.org/pdf/2410.24221)
10. AoE: Always-on Egocentric Human Video Collection for Embodied AI(https://arxiv.org/pdf/2602.23893)
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
