

WAM狂奔八年,行业却连定义共识都没达成
——但它正在逼近具身智能的某种本质
当前 WAM 领域呈现出技术快速迭代与核心争议并存的格局:
一方面,"大视频基座 + 轻量动作头" 的工业落地路线得到初步验证;
另一方面,关于 "推理时显式未来预测是否为刚需"、"WAM 与 VLA 的能力边界如何划分" 等核心问题,行业仍处于“争论”当中
——行业对WAM的定义本身尚未形成共识。
但其实早在2018年,WAM的核心概念就已有伏笔:
彼时提出的“在隐空间中模拟世界以替代真实试错”,至今仍是WAM体系的思想原点。
那么,从这一思想原点出发:
“
本文将沿着8年技术发展时间线,系统拆解WAM从理论筑基到闭环自主决策的完整演进脉络。
技术溯源:纯世界模型筑基,埋下动作融合伏笔
WAM的核心内核源自早期世界模型研究,这一阶段研究重心聚焦让AI学会理解并预判世界,暂未正式结合动作生成,却为后续WAM搭建起底层逻辑框架。
早在2018年,经典论文《World Models》率先提出开创性思路,依托VAE结合循环神经网络构建基础环境表征,让智能体在隐空间内学习环境规律、预测未来状态。
首次确立“以模型模拟世界替代真实试错”的核心思想,彻底改变强化学习依赖海量真实交互数据的旧模式。
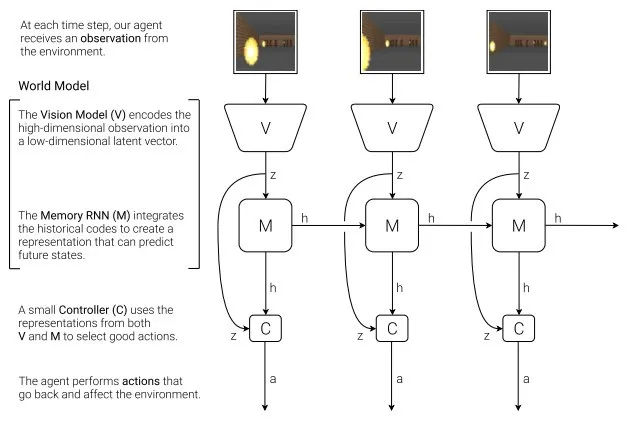
▲世界模型(World Model)核心组件:视觉编码、时序记忆与动作控制协同流程©【深蓝具身智能】编译
此后Dreamer系列论文持续迭代升级,创新性采用RSSM时序建模结构,把环境观测信息压缩至紧凑隐空间,依托虚拟环境完成策略规划与训练。
这套成熟的世界预测体系,搭建起环境感知、时序推演的基础能力。但也暴露出核心短板:
仅能完成场景想象,无法输出可落地的控制动作,认知与执行彻底割裂。
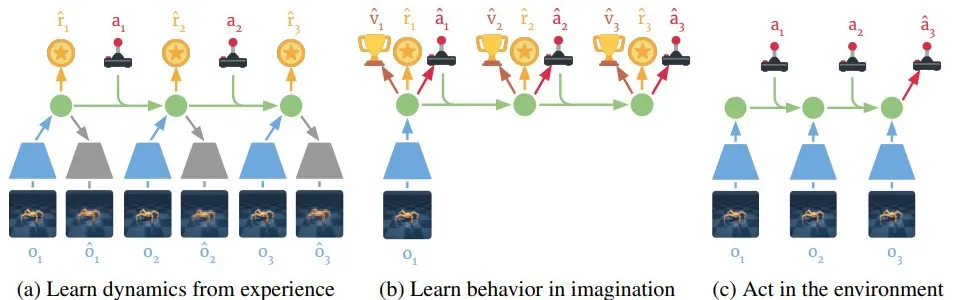
▲Dreamer 算法的三大核心组件:动力学学习、想象中行为优化与环境执行流程©【深蓝具身智能】编译
2022年掩码世界模型相关研究的出现,将视频画面视作序列数据开展自回归预测,进一步强化长时序场景推演能力,把视觉时序建模精度推向新高度。
至此,能看懂世界、能预判未来的基础能力全部成型,行业正式迎来从“纯世界建模”向“世界+动作融合建模”转型的技术拐点
——WAM雏形显现。
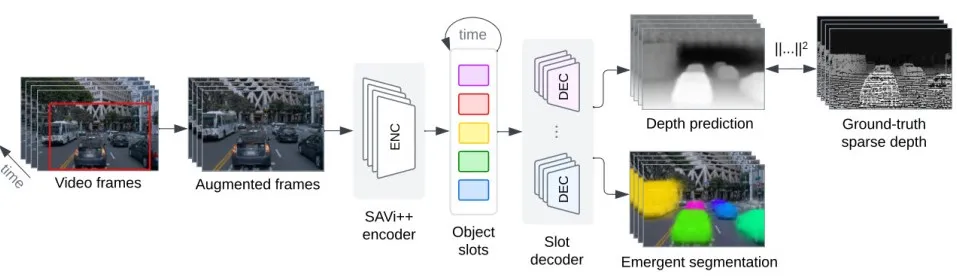
▲基于 Slot Attention 的目标中心视频模型 SAVi++ 架构与训练流程©【深蓝具身智能】编译
雏形探索:解耦式架构落地,视频先验打通动作链路
2023年行业正式开启WAM雏形探索,主流思路走向世界建模与动作生成完全解耦。
依托成熟大视频预训练模型作为环境认知主干,额外搭建轻量化动作映射分支,以低成本方式实现“场景预判+动作输出”基础组合。
这一阶段以UniPi为标志,首次抛出“策略即视频”颠覆性理念,构建起文本指令生成未来行为视频、再通过逆动力学模型反推实操动作的完整流程。
研究证实,海量通用视频预训练积累的物理常识、行为逻辑,能够完美填补智能体物理认知短板,轻松实现跨场景基础行为迁移。
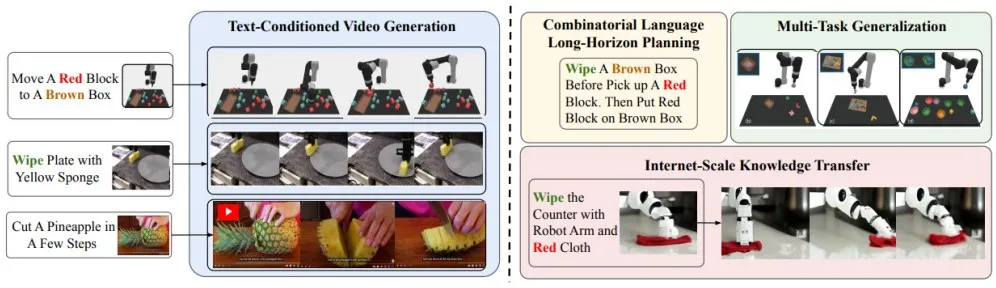
▲UniPi :基于文本条件视频生成的通用策略框架©【深蓝具身智能】编译
但解耦架构的先天缺陷也随之暴露:
视频预测模块与动作决策模块独立训练,二者表征空间无法深度对齐,长时序推演极易出现画面失真、动作偏移;
同时双模块并行运行算力开销庞大,控制精度偏低,仅能适配简单低速场景,复杂实操任务难以胜任。
即便实用性受限,这套架构依旧成为早期低成本搭建WAM系统的通用范式。
迭代优化:两阶段对齐升级,隐动作降低适配门槛
迈入2024年上半年,行业针对解耦架构的割裂痛点开展优化,进入两阶段对齐WAM发展阶段,依旧保留双模块独立训练模式,但重点强化两大模块表征对齐能力,同时引入隐动作思路降低视频到实体动作的转化难度。
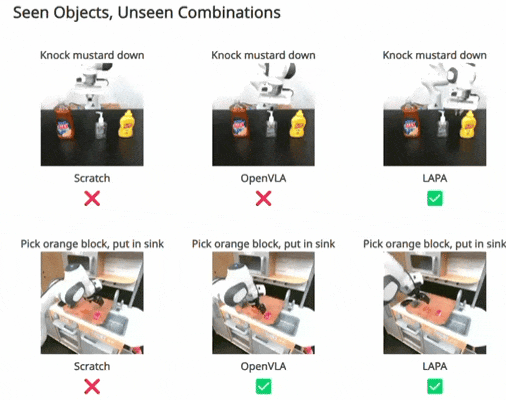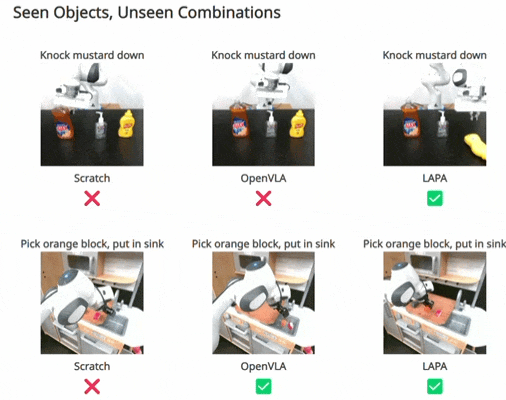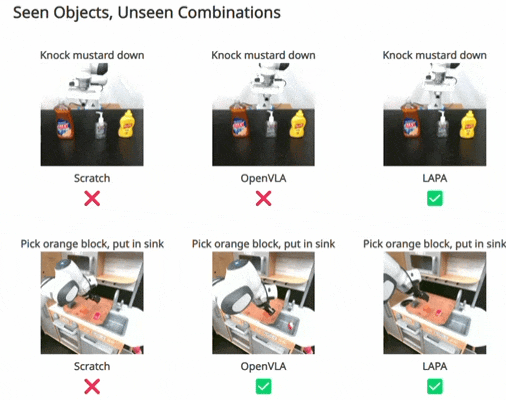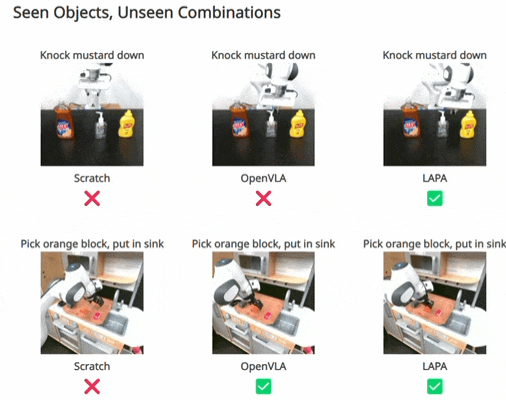
以 LAPA 框架为代表,提出了隐动作预训练方案。
研究不再直接搭建视频与真实机械动作的映射通道,而是先从无标注通用视频数据中学习抽象隐式动作表征,再完成隐动作到实体控制动作的二次映射。
这种分层转化思路,大幅降低跨设备、跨场景动作适配难度,充分盘活海量无标注视频训练资源。
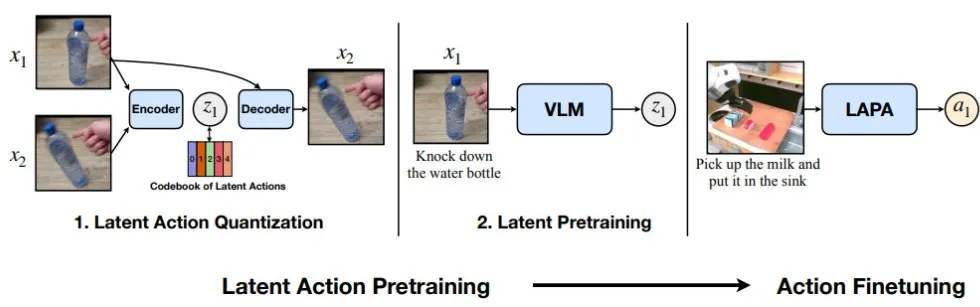
▲LAPA 模型整体框架:基于视频的无监督隐动作预训练流程©【深蓝具身智能】编译
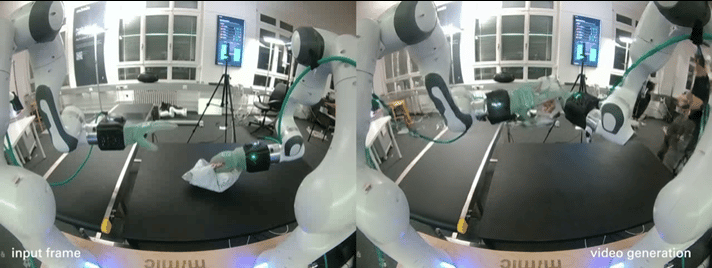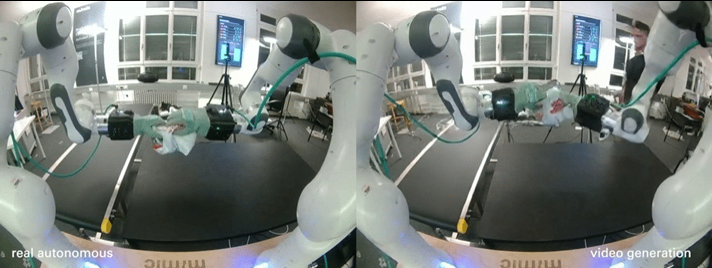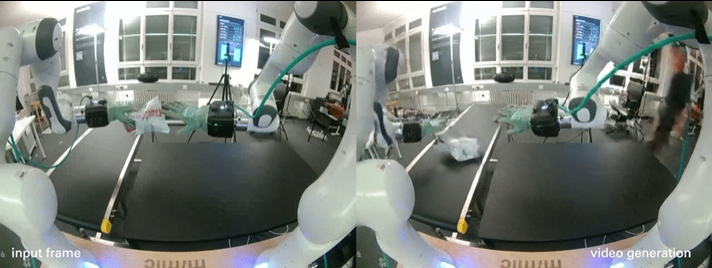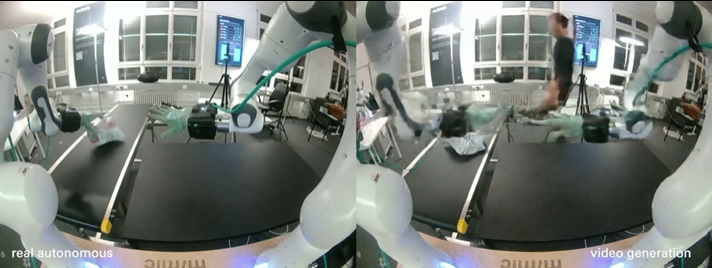
同期 Mimic-Video 进一步落地工程化优化,直接冻结成熟大规模视频预测骨干网络,仅轻量化微调动作解码分支。
该方案在保障环境预测精度不变的前提下,极大缩减训练成本与部署门槛,验证了通用视频先验无缝迁移至机器人实操控制的可行性,让WAM从理论研究逐步走向轻量化落地场景。
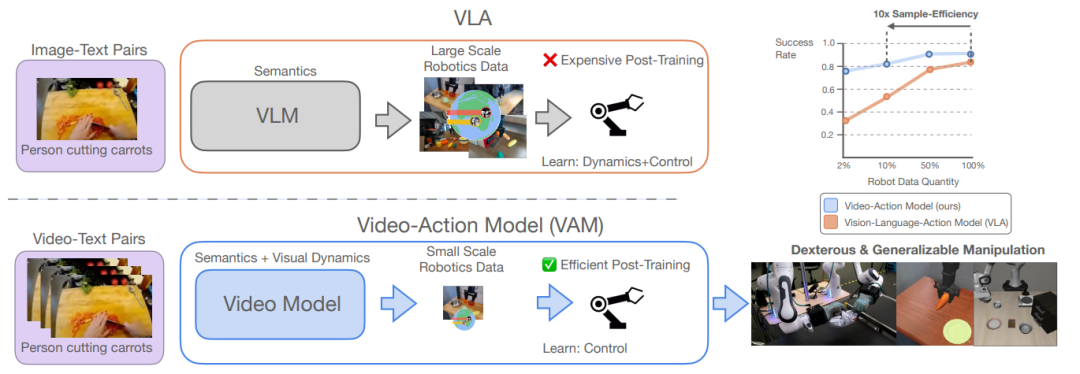
▲视频 - 动作模型(VAM)与传统 VLA 的范式对比:Mimic-Video 的核心架构与样本效率优势©【深蓝具身智能】编译
同样,两阶段架构依旧没能根除核心矛盾:
先后训练的模式无法实现环境变化与动作调整的实时联动,智能体无法根据实时推演的环境变化动态修正动作,临场应变能力依旧薄弱。
架构革新:联合统一建模,WAM正式确立核心形态
2024年下半年至2025年上半年,WAM迎来里程碑式技术变革,共享骨干联合优化架构正式取代传统两阶段架构,标志着标准形态的WAM全面成型
——也是现阶段学术研究与工业落地的主流核心路线。
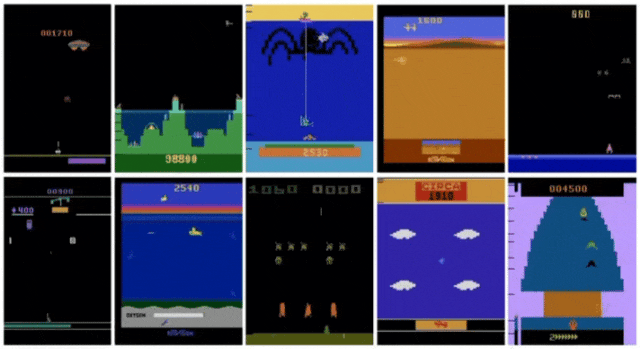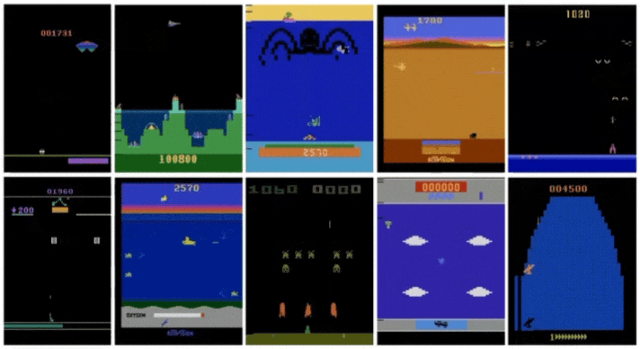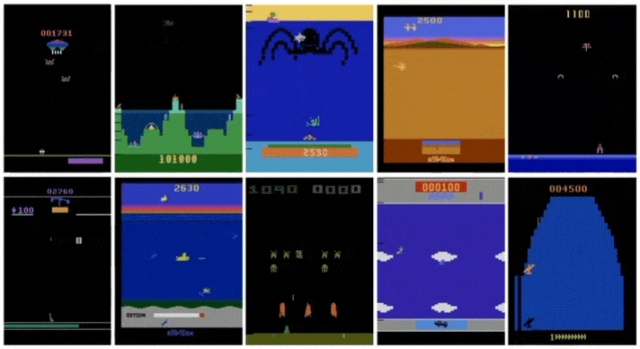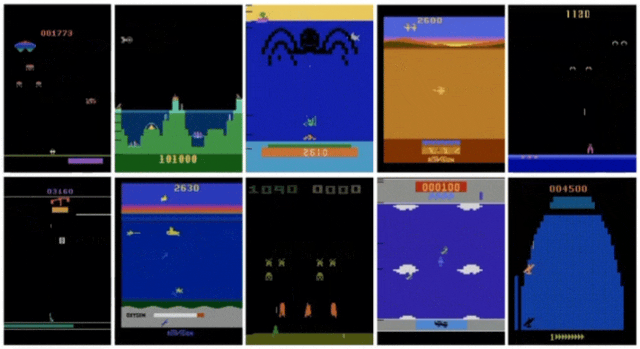
联合式 WAM 标志研究《Scaling Offline Model-Based RL via Jointly-Optimized World-Action Model Pretraining》,打破模块壁垒,采用同一套Transformer主干网络,同步完成环境未来状态预测与连续动作序列生成,实现世界认知与动作决策端到端协同优化。
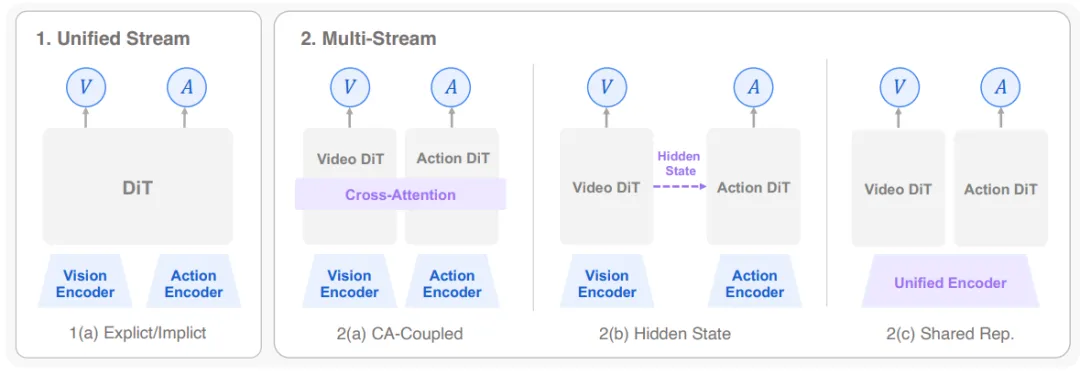
▲联合 WAM 架构示意图:单流 / 多流耦合©【深蓝具身智能】编译
统一表征空间彻底解决表征错位问题,模型既能精准预判环境演变趋势,又能同步输出适配场景变化的连贯动作,仅依靠少量专家演示轨迹,即可快速完成全新场景任务迁移,综合性能实现质的飞跃。
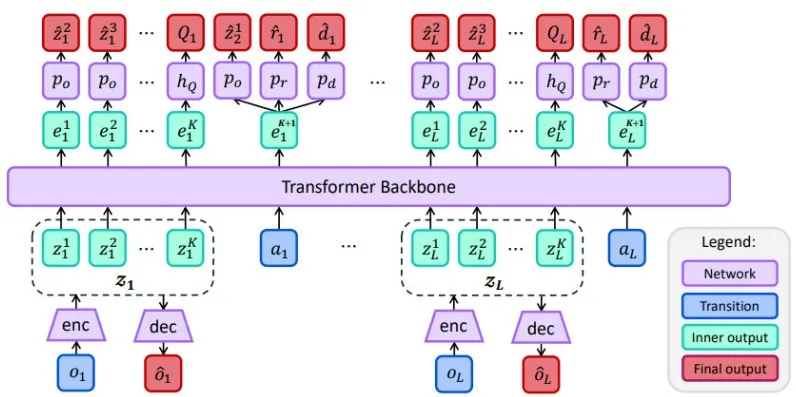
▲JOWA:面向世界 - 动作联合优化的端到端 Transformer 架构©【深蓝具身智能】编译
随后 WorldVLA 进一步完成多模态融合升级,将视觉图像、自然语言指令、连续控制动作统一转化为离散Token序列,依托自回归生成逻辑实现多模态协同推演。
模型实现环境预测与动作生成双向赋能,场景预判结果优化动作决策,动作执行反馈反向修正环境推演偏差,在各类机器人实操基准测试中成绩大幅提升。
后续迭代衍生出适配连续动作的优化版本,进一步拓宽实用边界。
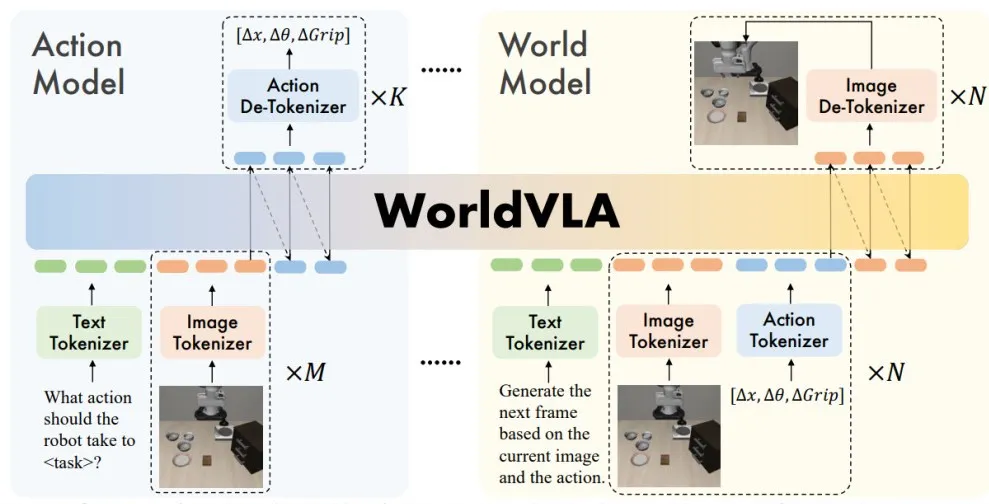
▲WorldVLA 模型架构:动作模型与世界模型双向增强的自回归 WAM 设计©【深蓝具身智能】编译
联合建模架构补齐了WAM核心能力短板,兼具认知深度与执行灵活性,但想要实现真正意义上的通用具身智能,还需突破场景、设备、任务的泛化壁垒。
能力突破:大规模预训练赋能,实现零样本跨域泛化
2025年末至2026年初,WAM技术发展聚焦通用泛化能力,依托千亿级大规模视频扩散预训练模型赋能,打造具备零样本适配能力的高阶WAM体系,彻底摆脱场景与设备定制化训练束缚。
NVIDIA推出的 Dream Zero 作为该方向标杆成果,依托超大参数视频扩散主干网络,搭配极简轻量化动作适配头,仅依靠极少量遥操演示数据,就能实现跨品类机器人、未知作业物体、全新陌生场景的零样本自主操控。
这项研究直接证实,通用视觉世界先验足以支撑绝大多数基础具身任务,无需针对细分场景重复大规模训练。
也让行业正式确立“大视频基座+轻量动作头”的极简高效工业落地路线。
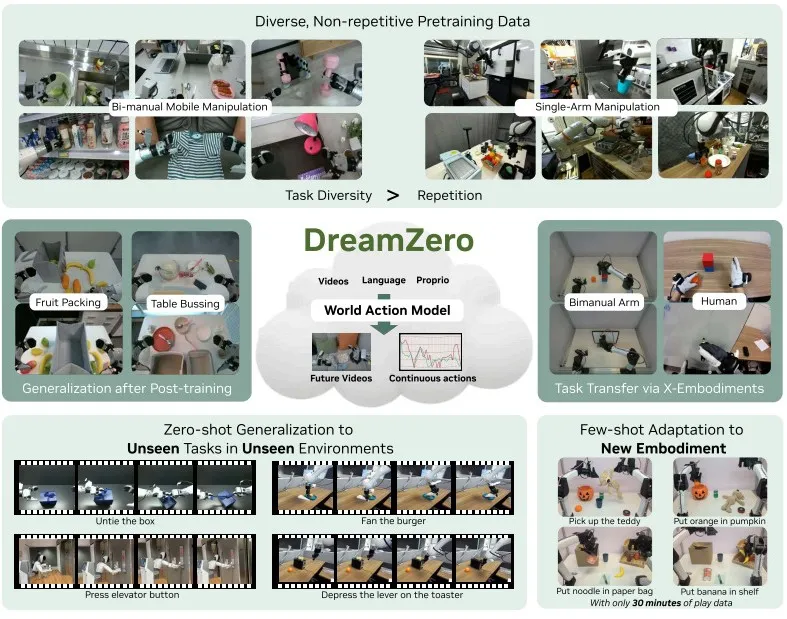
▲DreamZero 模型概览:基于 WAM 的零样本泛化与跨具身学习能力©【深蓝具身智能】编译
同期《Co-Evolving Latent Action World Models》针对性解决联合训练极易出现的表征坍塌问题,采用分步预热协同训练策略:
先完成世界模型与隐动作模型基础对齐预训练,再开展双向协同迭代优化,让环境推演模块与动作决策模块相互适配、共同进化,进一步提升复杂动态场景下的运行稳定性与决策合理性。
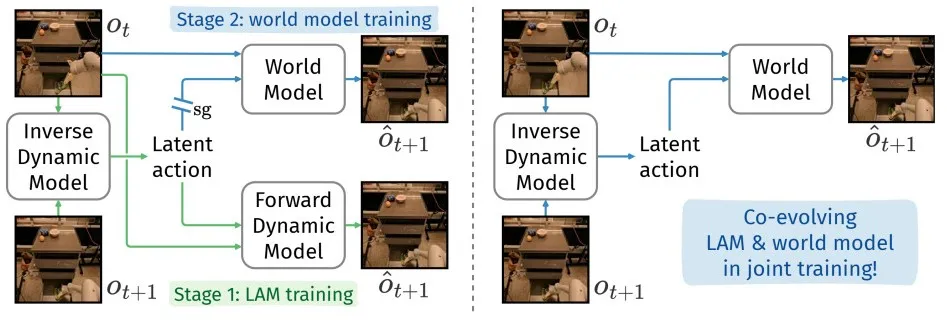
▲CoLA-World 的核心创新:从两阶段到单阶段的 LAM 与世界模型协同进化训练范式©【深蓝具身智能】编译
终极演进:双向交互闭环,打造可行动真实世界模型
当下,WAM技术正式迈入成熟终局形态,研究重心从“同步生成”升级为双向动态交互迭代,彻底告别单向推演、单向输出的固有模式,构建起闭环自主决策体系。
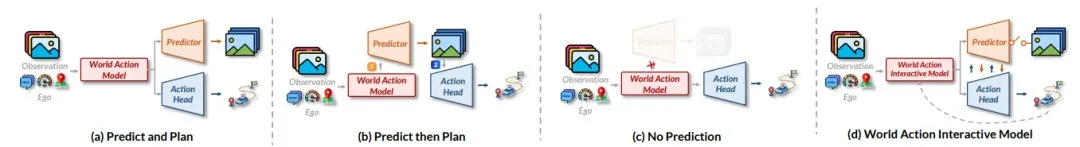
▲从 WAM 到 WAIM:世界动作模型从单向生成到递归交互的范式演进©【深蓝具身智能】编译
最近一项研究 DAWN 搭建起全新交互运行逻辑:
-
模型先依据当前场景完成未来世界状态推演,以此为条件生成精准可控的原始动作序列;
-
再通过动作去噪模块优化动作精度;
-
最终将动作执行带来的场景实时变化反向回传,二次修正优化后续环境推演结果。
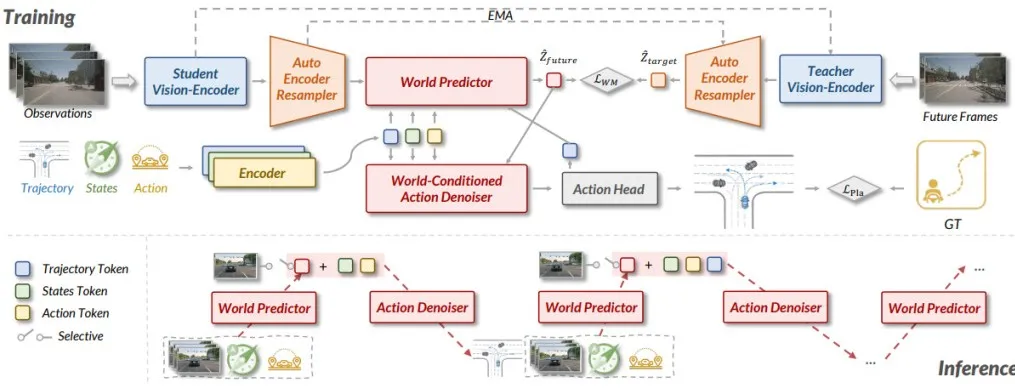
▲DAWN 模型架构:隐空间下世界预测与动作去噪的交互增强 WAM©【深蓝具身智能】编译
这种循环往复的双向反馈机制,让WAM具备实时临场调整、长时序精细规划的核心能力,不再是死板的预判执行工具。
而是能够深度融入真实物理世界、自主适配环境波动的可行动世界模型,无限贴近人类观察思考、调整行为的自然决策逻辑。
也为家用服务机器人、工业智能操控、自主移动智能体等高端落地场景扫清最后技术障碍。
锚定行业未来格局
走完完整技术演进链路后,也推荐两篇最新综述研究,能够帮助大家快速梳理行业全貌、厘清未来研究方向:
-
其一为复旦联合多所高校推出的《World Action Models: The Next Frontier in Embodied AI》。
首次完成WAM权威定义,清晰划分级联式、联合式两大主流技术架构,系统性梳理数据集、评测基准、现存技术瓶颈与优化方向。
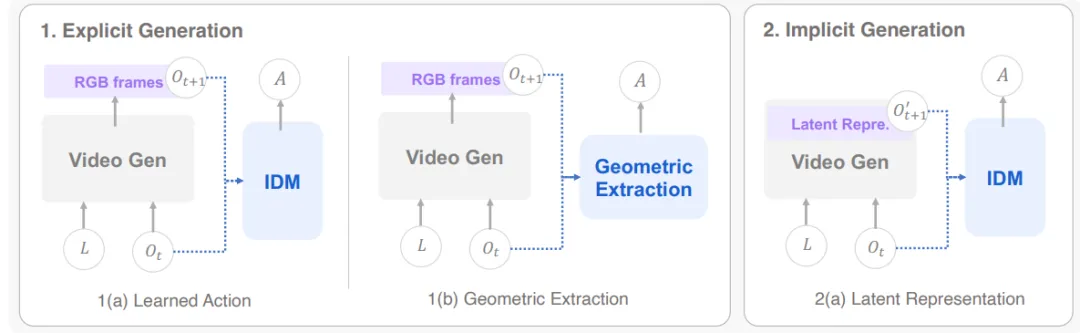
▲级联 WAM 架构示意图:显式 / 隐式规划©【深蓝具身智能】编译
-
其二为华为产业视角综述《World Models and World Action Models (WAM): From Foundation Simulators to Embodied Action》。
复盘从传统世界模型到新一代WAM的完整产业演进历程,梳理六大核心技术支柱,同时结合产业落地场景绘制清晰技术发展路线图。
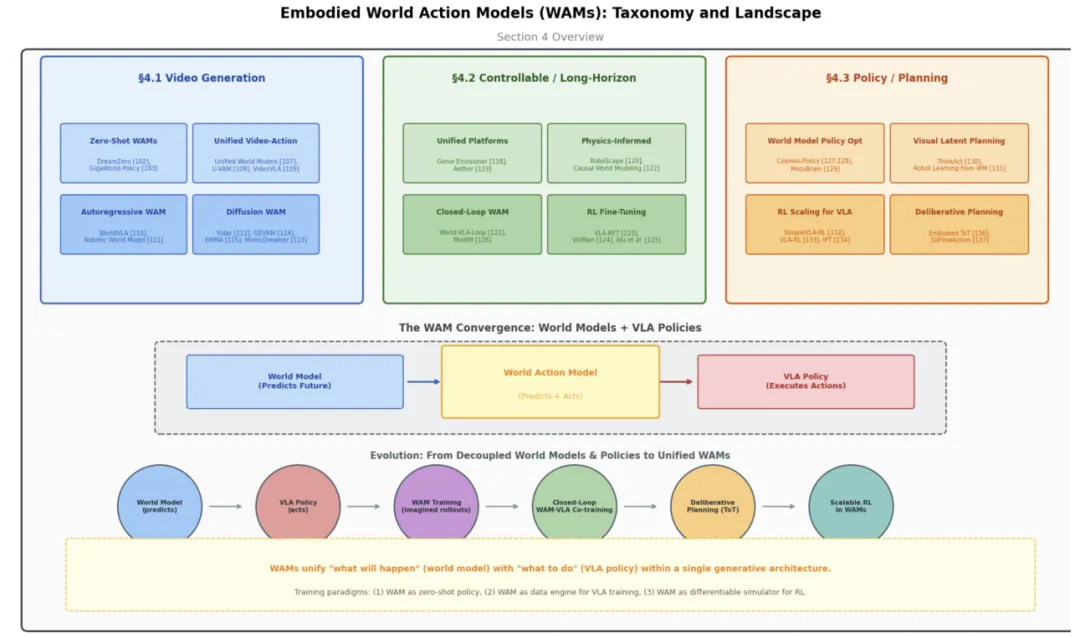
▲具身世界动作模型(WAMs)的分类与全景:三大技术分支与范式演进©【深蓝具身智能】编译
纵观整场技术演进,WAM始终沿着一条主线持续进化:
分离对齐 → 融合统一 → 泛化通用 → 闭环交互
每一次架构跃迁,本质上都是在回答同一个问题——如何在隐空间中更高效地建立对物理世界的认知,并据此产出可执行的动作。
但值得注意的是,行业对WAM的定义共识远未达成。
不同研究团队口中的“WAM”可能指向完全不同的架构范式与能力范畴,这在一定的客观程度上增加了技术对比和工程选型的难度。
WAM的演进史本身也在提醒我们:每一阶段的“最优解”都带着特定场景和工程约束的烙印。
本文梳理WAM全貌的目的,希望能为从业者提供一个审视这一技术方向的历史纵深与逻辑线索。在众声喧哗的舆论场中,厘清哪些是底层能力的真实突破,哪些是工程层面的路径选择。
编辑|小小怪博士
审编|具身君
Ref
