

不到一年时间,四项研究,接连登上三大顶会
——完整离散 VLA 加速体系
当7自由度机械臂预测单个动作块需要运行数十次前向传播时,推理频率就被卡在了5Hz以下。
倒水、折毛巾这类灵巧操作要求更高的控制频率,离散VLA的推理速度已成为实际部署的瓶颈。
来自香港科技大学(广州)的研究团队为解决这一问题,接连提出四套完整离散 VLA 加速体系,全部被顶会收录:IROS、ECCV(x2)、ICLR。
走出一条自回归并行解码、一致性蒸馏加速、多模态统一扩散、扩散模型实时优化全技术链路。
01
PD-VLA
IROS 2025:首个在解码端加速VLA推理的工作,无需训练即可实现2.52倍执行频率提升,且性能不降反升。
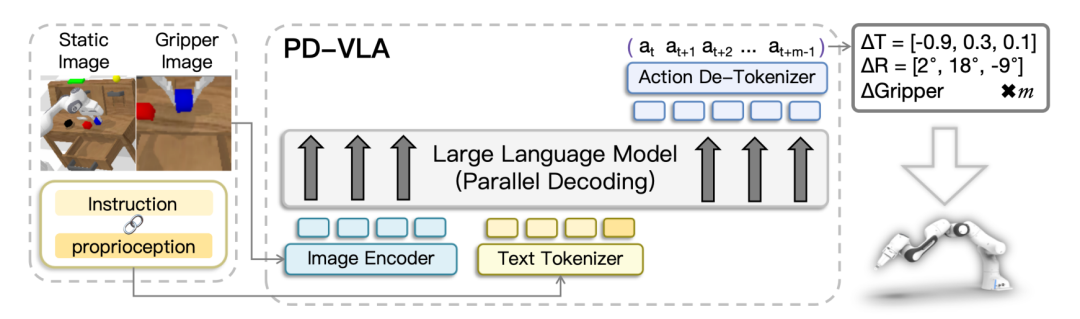
▲PD-VLA的网络架构©【深蓝具身智能】编译
PD-VLA核心是将传统VLA自回归逐token解码模式,重构为可通过Jacobi定点迭代求解的非线性方程组,摒弃逐次前向传播的低效逻辑,通过双向注意力替换原有因果注意力,解除token预测的时序依赖,实现所有动作token同步迭代更新、并行收敛。
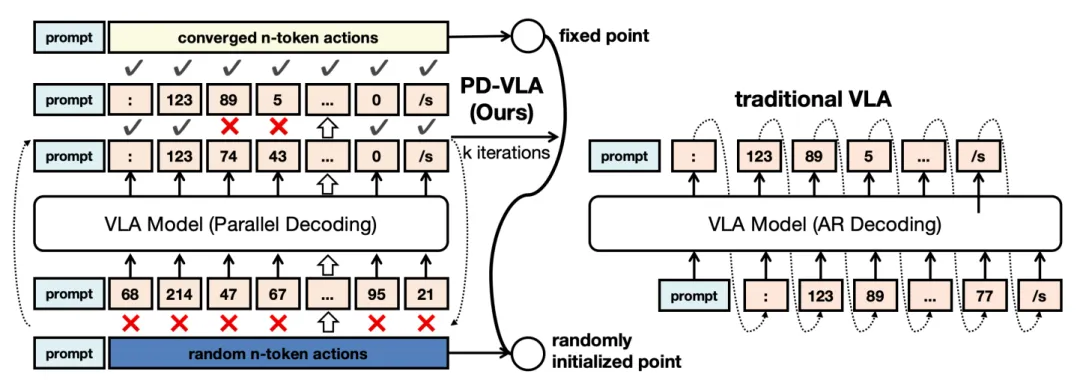
▲并行解码 PD-VLA 与传统自回归 VLA 解码流程对比©【深蓝具身智能】编译
-
首个面向action chunking VLA的并行解码框架:
将自回归解码重构为定点迭代求解,用数学保证维持模型性能的同时消除逐token生成的效率瓶颈。
-
三重训练自由特性:
无需重新设计模型架构、无需额外训练、无需修改预训练模型,即插即用,可直接与量化、token剪枝等现有加速技术叠加。
-
解码范围最优选择:
系统对比三种解码horizon,证明全token并行解码(n=37)在固定token数量、解码速度和操作能力上全面占优。
-
揭示固定token加速现象:
发现夹爪状态等离散二值token具有"预判正确"的能力,即使在错误上下文中也能稳定收敛,为后续工作提供了重要启发。
在CALVIN基准上,执行频率从1.81Hz提升至4.56Hz(2.52×),成功率从72.0%提升至94.1%;在LIBERO-Long上达到91.7%,平均成绩94.7%。真实世界实验中,倒水任务成功率从10%提升至60%。
02
CEED-VLA
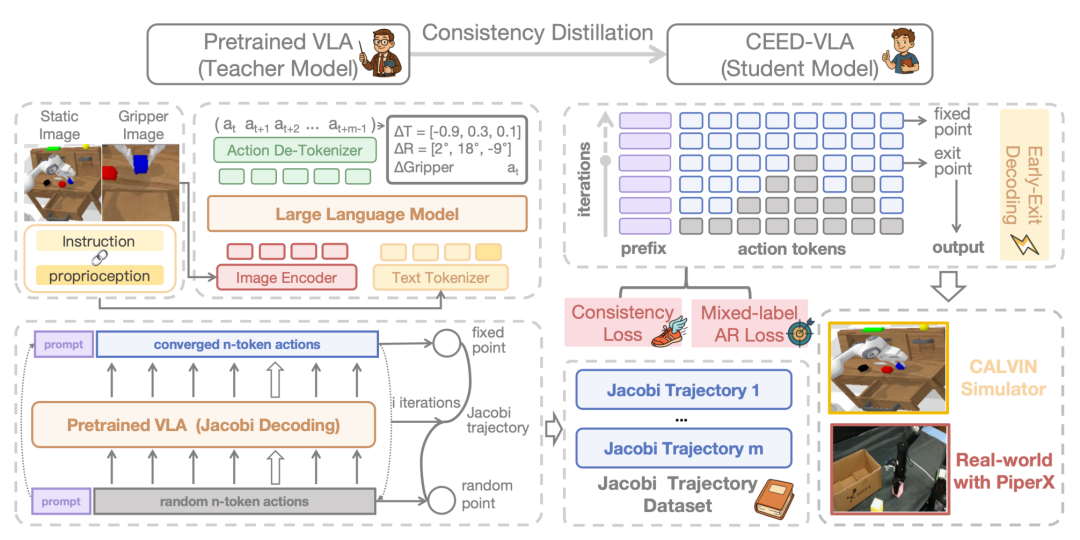
▲CEED-VLA框架©【深蓝具身智能】编译
-
首先利用预训练教师模型生成完整Jacobi迭代轨迹,通过一致性蒸馏训练学生模型,使其可将任意中间迭代状态直接映射至最终定点,解决传统迭代单次仅能固定单个token的缺陷;
-
同时引入混合标签监督机制,根据教师预测与真实标签的L1距离自适应切换监督信号,杜绝蒸馏过程的误差累积;
-
最后针对Jacobi解码严格收敛、无效迭代过多的瓶颈,结合机器人任务关键状态稀疏的特性,设计早退出解码策略,适度放松收敛条件、提前终止迭代。
实验结果显示,在LIBERO基准(OpenVLA基座)上实现4.1倍加速、25.60Hz频率;在CALVIN基准(LLaVA-VLA基座)上实现2.0倍加速。真实世界实验中,倒水任务从15%提升至80%,折毛巾从5%提升至75%,平均成功率从33.25%提升至77.50%。
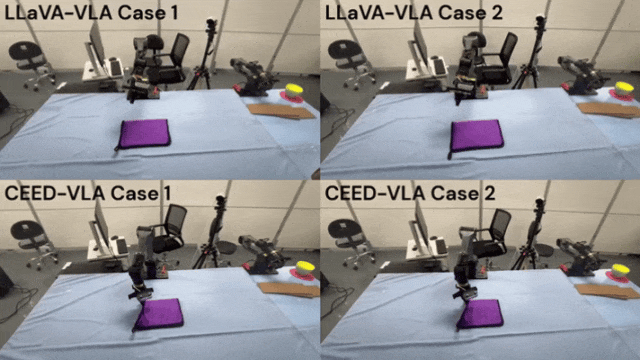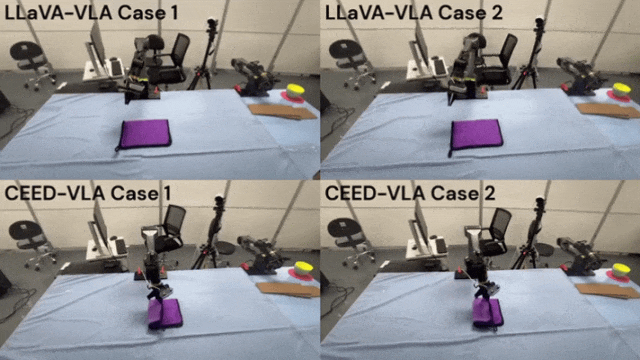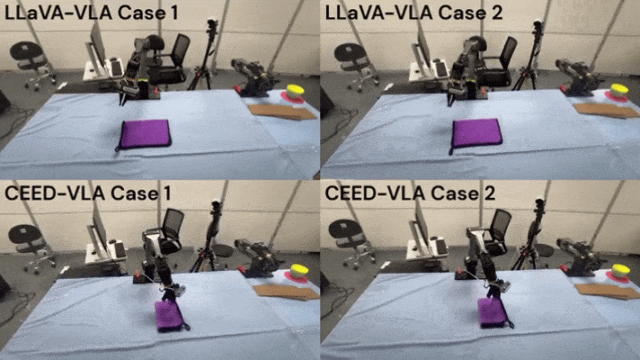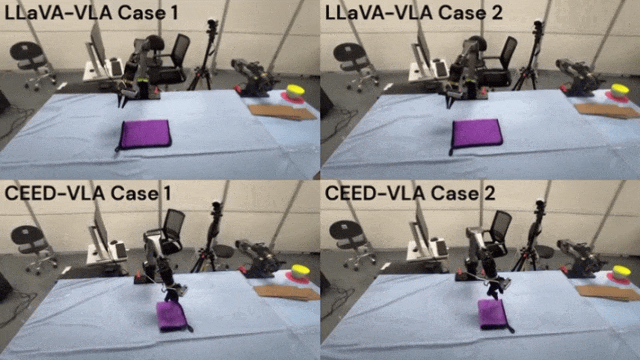
不改变骨干网络架构,不添加辅助组件,无额外GPU内存开销,在LLaVA-VLA和OpenVLA两种基座上均有效。
03
Unified Diffusion VLA
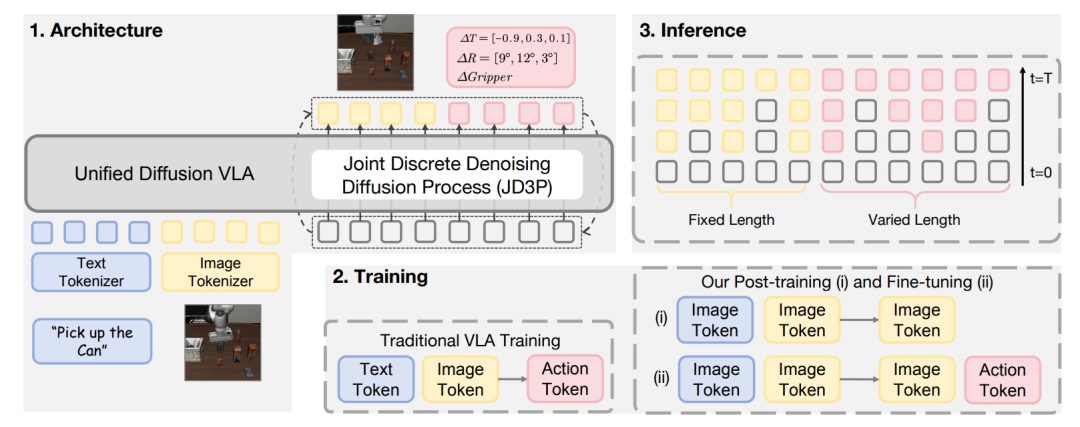
▲统一扩散视觉动作模型 UD-VLA 整体框架总览图©【深蓝具身智能】编译
UD-VLA跳出自回归解码范式,构建全新的多模态协同生成框架。
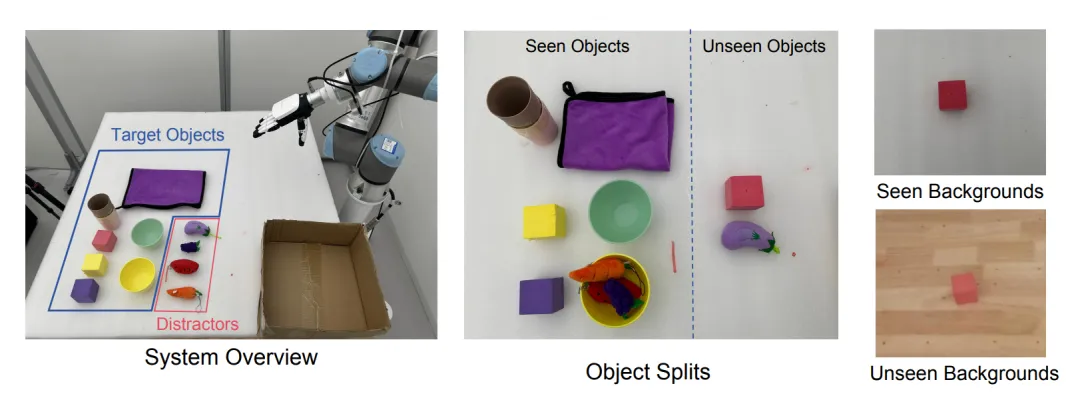
▲实物机器人实验平台、物体数据集与背景划分设置一览©【深蓝具身智能】编译
-
联合离散去噪扩散过程(JD3P):
首次将图像生成和动作预测统一到单一去噪轨迹中,动作在视觉去噪的持续引导下迭代精炼,实现真正的协同优化而非简单多任务拼接。
-
混合注意力机制:
模态内双向+跨模态因果的混合策略,既保证各模态内部的充分交互,又维持"视觉引导动作"的因果结构,消融实验证明该设计使CALVIN平均长度从4.04提升至4.64。
-
统一token空间与两阶段训练:
将语言、视觉、动作统一为离散token,通过后训练注入视觉生成能力,再联合训练激活跨模态协同,无需外部编码器/解码器。
-
推理时优化技术组合:
Prefix KV Cache、置信度引导解码(余弦mask调度+TopK选择)、解码空间映射三项技术协同,确保4.3倍加速下的高性能。
实验证明,CALVIN平均长度4.64(SOTA),LIBERO平均92.7%,SimplerEnv总体62.5%(SOTA),推理速度219.3 tokens/s(比自回归快4.3倍)。
在SimplerEnv的Stack Block任务中比具备3D感知的SpatialVLA高出24.9个百分点。
04
Fast-dVLA
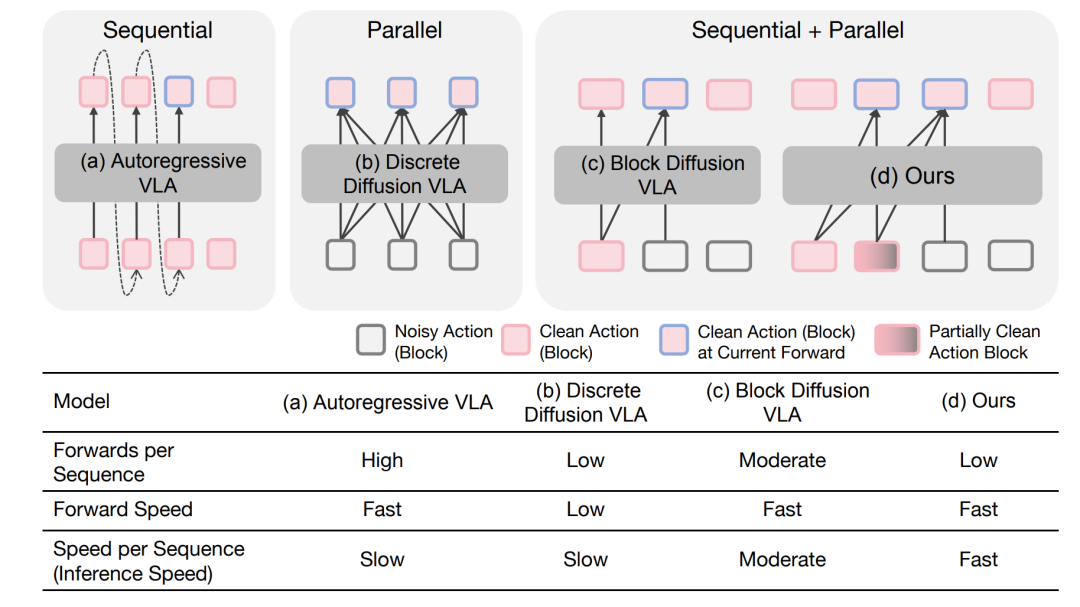
▲四种离散解码范式的机制与性能对比(含Fast-dVLA 方案)©【深蓝具身智能】编译
Fast-dVLA针对扩散VLA推理速度不足、难以实时部署的问题:
-
首先挖掘出双向扩散VLA隐含的从左到右块级自回归解码特性,据此改造全局双向注意力为块级因果注意力,让已完成解码的动作块实现KV缓存复用,减少重复计算;
-
同时引入扩散强制机制,为不同动作块分配差异化噪声水平,实现前后动作块的并行去噪迭代,打破传统解码的时序束缚;
-
训练阶段采用非对称蒸馏策略,将高精度双向教师模型的能力迁移至高效块级学生模型,大幅降低训练收敛成本;
-
推理时搭载双状态流水线解码机制,平衡解码置信度与推理速度。
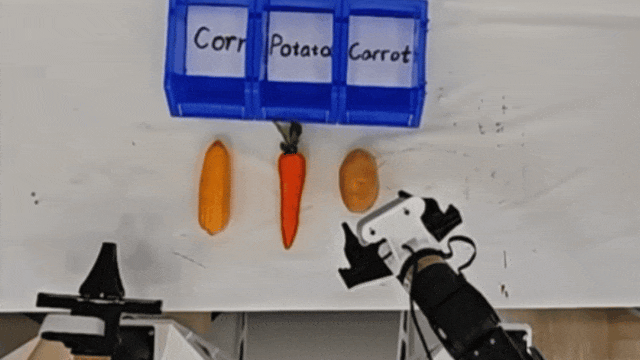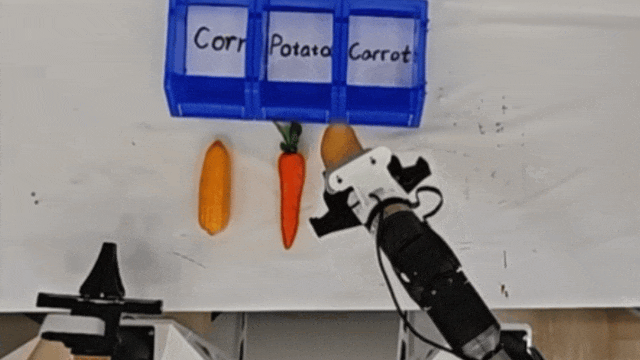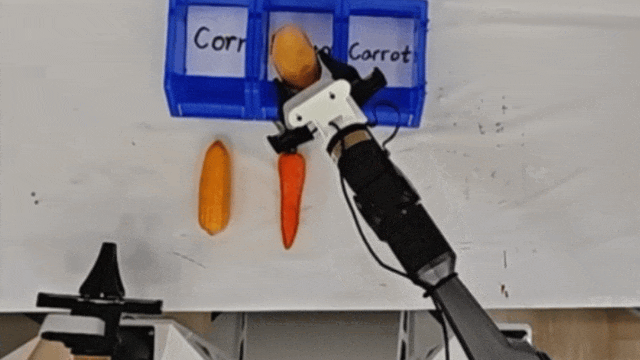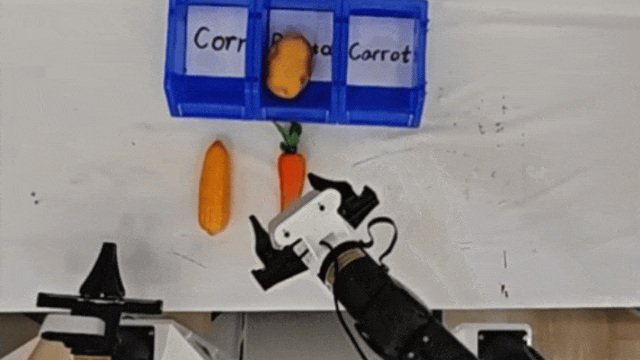
在LIBERO上对DDVLA基座实现4.1倍加速(402.7 tokens/s),成功率保持96.6%;
在CALVIN上对UD-VLA实现2.8倍加速;在SimplerEnv上达到366.4 tokens/s。
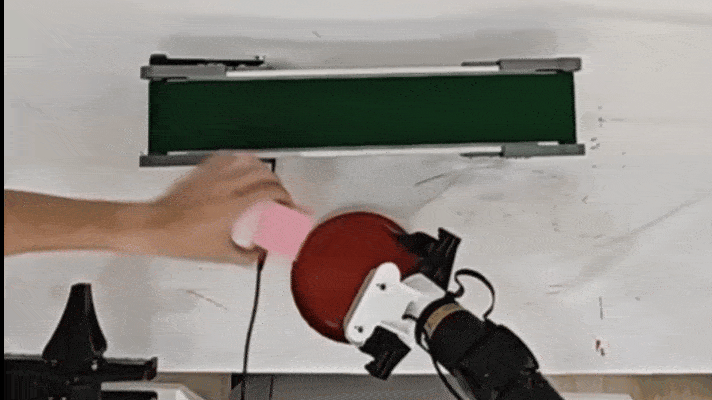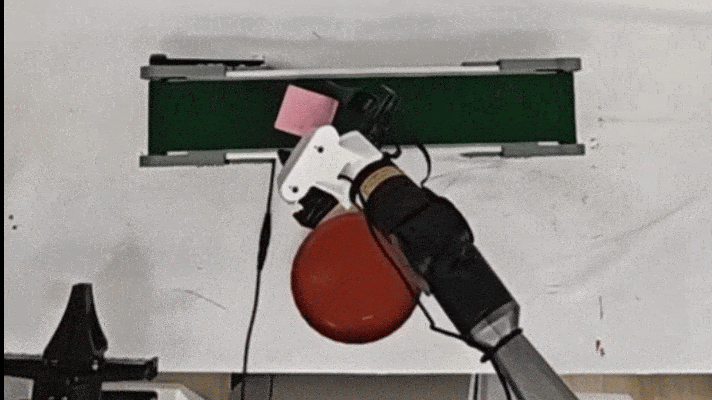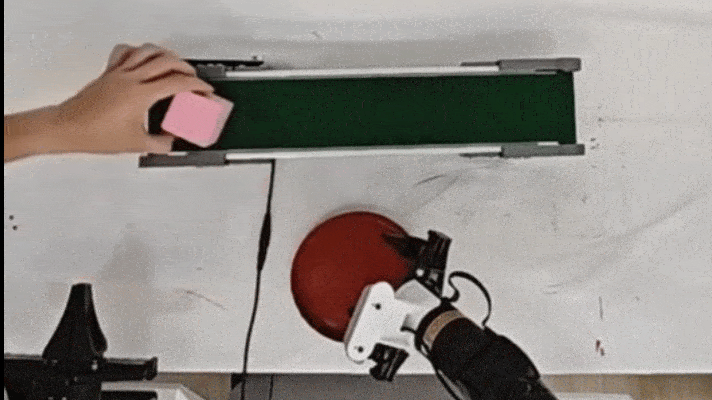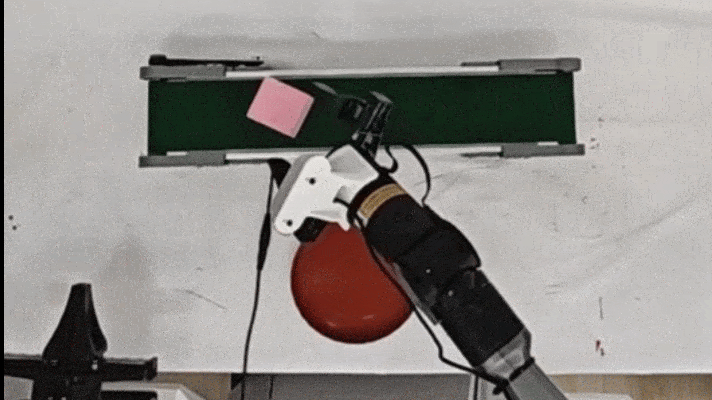
真实世界双臂平台所有任务一致维持30Hz执行频率,传送带抓取效率接近基线2倍。
4篇离散VLA加速论文,藏着什么"共性密码"与"差异化打法"?
都在啃"推理速度"这块硬骨头
-
痛点瞄准真需求:
四篇研究全部聚焦"VLA推理太慢导致无法实时控制"这个部署核心瓶颈。从2.52倍到4倍再到30Hz,每一步都在往"能用"的方向推。
-
并行解码成主线:
从PD-VLA的Jacobi并行到CEED-VLA的一致性蒸馏加速并行,从UD-VLA的联合扩散并行到Fast-dVLA的块间流水线并行,"并行"是贯穿四篇论文的核心加速手段。
-
不牺牲性能为底线:
四篇研究在加速的同时均保持甚至提升了任务成功率,没有一个靠牺牲精度换速度。PD-VLA甚至出现了加速后性能反升的现象(72%→94%)。
各有各的"加速战场"
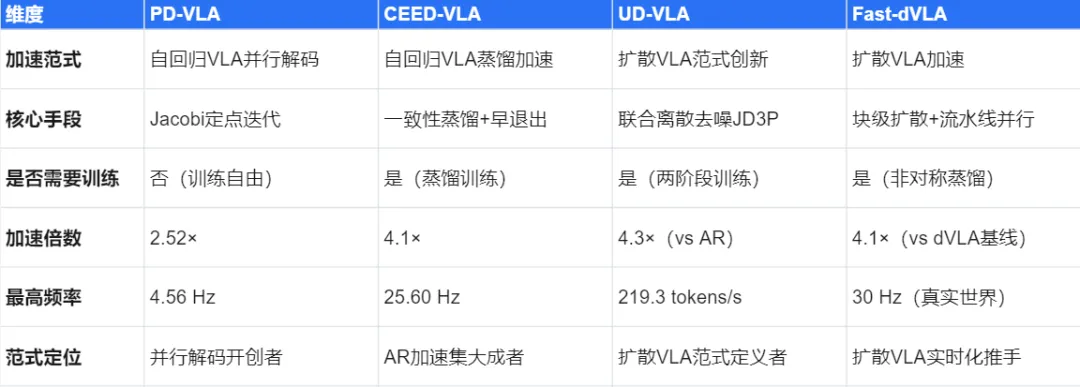
离散VLA正从"实验室频率"迈向"实时控制频率"
四篇论文的核心都是让离散VLA从"能跑"变成"能高频跑、能实时跑"。
从PD-VLA的4.56Hz到Fast-dVLA的30Hz,不到一年时间,离散VLA的推理频率提升了一个数量级。
这说明离散VLA的效率瓶颈并非不可逾越,关键在于找到正确的解码结构和加速策略。
后续值得关注的方向:
扩散VLA与更高效token化方案(如FAST)的结合是否能进一步突破频率上限;以及在embodied chain-of-thought等需要大量中间推理token的场景中,这些加速技术能否同样奏效。
编辑|小小怪博士
审编|具身君
Ref
1. PD-VLA: Accelerating Vision-Language-Action Model Integrated with Action Chunking via Parallel Decoding(IROS 2025)
2. CEED-VLA: Consistency Vision-Language-Action Model with Early-Exit Decoding(ECCV 2026)
3. Unified Diffusion VLA: Vision-Language-Action Model via Joint Discrete Denoising Diffusion Process(ICLR 2026)
4. Fast-dVLA: Accelerating Discrete Diffusion VLA to Real-Time Performance(ECCV 2026)
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
