

机器人操作学习的年度「参考答案」
——数据、表征、泛化都聊了
如何让机器人像人类一样灵巧、泛化地操作物体,始终是具身智能领域的核心难题之一。
2026年上半年,机器人领域的顶级期刊 IEEE Transactions on Robotics (T-RO) 发表了一系列突破性研究,展示了操作学习的全新范式。
从数据多样性的重新定义,到等变策略的三维表征,再到深度生成模型的系统性应用,这些研究共同指向一个趋势:
在规模化数据的驱动下,更高级的表征和生成模型正在重塑具身智能的操作能力。
今天这篇文章,我们精选了 T-RO 2026年上半年在“机器人操作学习”方向的5篇代表性论文,看看顶尖实验室是如何攻克操作泛化难题的。
数据怎么收才有效?操作学习的规模化法则
论文标题:Is Diversity All You Need for Scalable Robotic Manipulation?
一句话推荐:在"规模化定律(Scaling Law)"席卷AI领域的今天,这篇论文直击具身智能数据的痛点:单纯增加数据量是否足够?研究通过严谨的实证分析给出了答案。
发文团队:香港大学、AgiBot、北京航空航天大学等
研究团队深入探讨了机器人学习中数据多样性的微妙作用,并将其拆解为三个关键维度:
任务多样性(做什么)、本体多样性(哪款机器人)、演示者多样性(谁来示教),从而系统性地挑战了"多样性越高越好"的直觉认知。
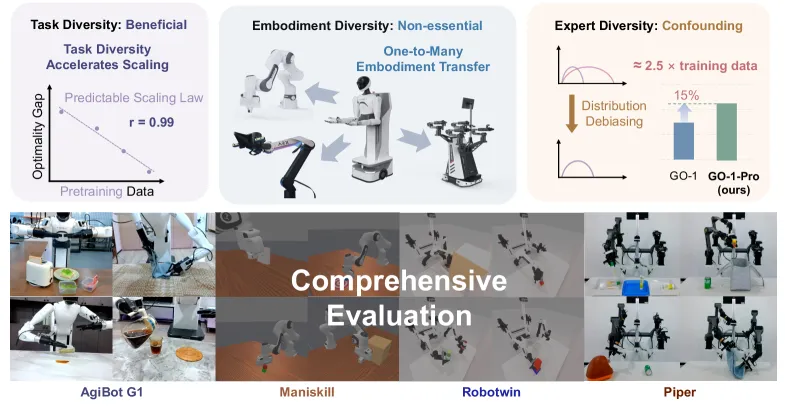
▲图1 | 机器人操作数据多样性的三个维度分析©【深蓝具身智能】编译
通过在多个机器人平台上的大量实验,研究得出了三条具有实践价值的结论:
-
第一,任务多样性比单任务演示数量更关键
在多样化任务上预训练的模型,能更好地迁移到新的下游场景,而单纯堆砌同一任务的数据收益递减明显;
-
第二,跨本体预训练数据并非必要
在高质量单本体数据上训练的模型,在微调阶段展现出比多本体预训练更理想的扩展特性,这对降低数据采集成本有重要意义;
-
第三,演示者多样性可能适得其反
人类示教时因个体操作习惯和随机变化带来的"速度多模态性(velocity multimodality)",会对策略学习造成干扰。
基于第三条发现,研究团队提出了一种分布去偏(distribution debiasing)方法来消除速度歧义,由此得到的 GO-1-Pro 模型实现了15%的性能提升,等效于使用了2.5倍的预训练数据量。
少量示教,任意姿态都能操作:三维规范化策略的突破
论文标题:Canonical Policy: Learning Canonical 3D Representation for SE(3)-Equivariant Policy
一句话推荐:如何让机器人学会抓取一个杯子后,就能应对任意摆放角度的杯子?研究巧妙地利用了 SE(3) 等变性,将复杂的三维操作问题转化为标准空间中的策略学习,大幅提升了操作的泛化能力。
发文团队:浙江大学、普渡大学
在三维空间中,物体的位置和姿态千变万化。传统的模仿学习往往需要海量数据来覆盖这些变化,而且对训练时未见过的视角和物体摆放方式泛化能力有限。
研究提出的规范化策略框架,建立了一套三维规范化表征(Canonical 3D Representation)的理论体系,通过将点云观测统一映射到一个标准参考坐标系,使得观测到动作的映射天然满足 SE(3) 等变性。
无论物体在现实中如何旋转或平移,系统都能将其"归一化"到标准坐标系下进行决策,再将生成的动作反变换回真实空间执行。
这种设计不依赖于对特定视角或物体姿态的记忆,而是从几何对称性中提取泛化能力。
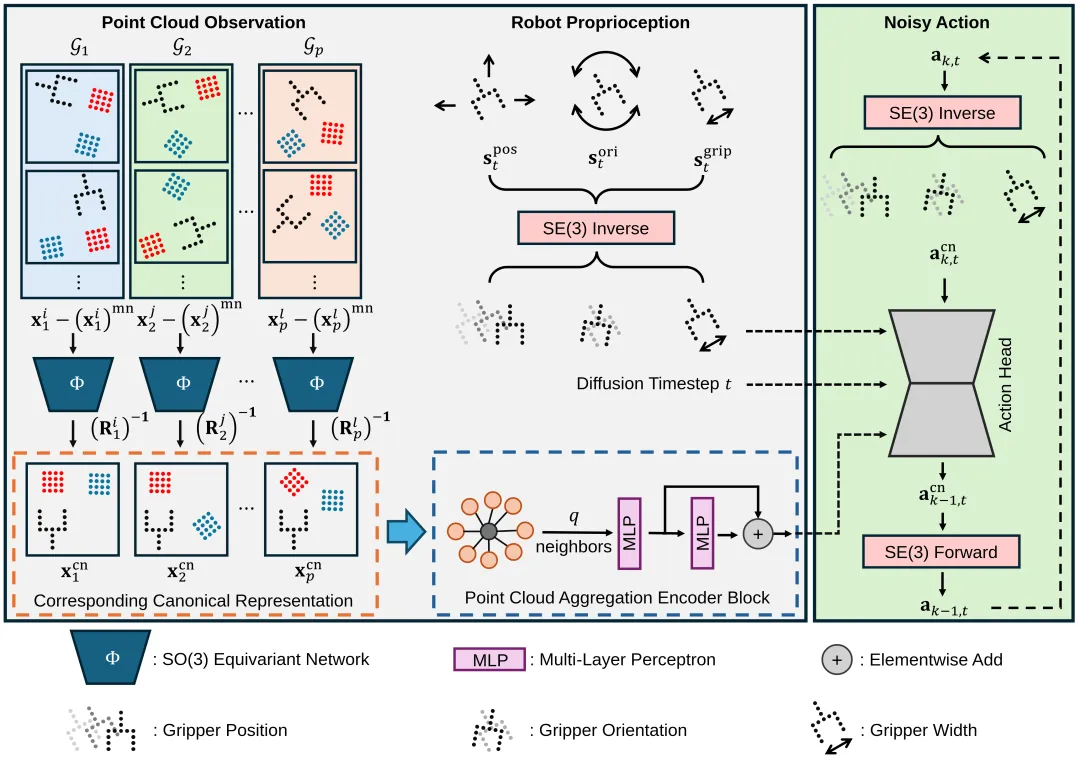
▲图2 | Canonical Policy 框架:将点云观测映射到规范化空间©【深蓝具身智能】编译
在12个多样化的仿真任务和4个真实世界操作任务上进行了实验验证,涵盖物体颜色、形状、摄像头视角和机器人平台等16种配置的变化。结果显示,Canonical Policy 在仿真中平均提升了18.0%,在真实世界实验中更是提升了39.7%,同时展现出更高的样本效率。
这意味着机器人只需更少的示教数据,就能掌握更鲁棒的操作技能。
灵巧手如何学会抓取千种物体:手物几何表征的突破
论文标题:DexRepNet++: Learning Dexterous Robotic Manipulation With Geometric and Spatial Hand-Object Representations
一句话推荐:研究深入挖掘了手与物体交互时的几何与空间关系,为灵巧操作提供了极具启发性的表征学习方案。
发文团队:浙江大学、新加坡国立大学等
相比于简单的平行夹爪,多指灵巧手拥有极高的自由度,这使得其控制策略的学习面临巨大挑战:
高维动作空间、复杂的接触动力学,以及如何在不同物体形状之间泛化。
研究团队提出的 DexRepNet++,核心创新在于提出了 DexRep 这一新型手物交互表征,专门用于捕捉物体表面特征以及手与物体之间的空间关系。
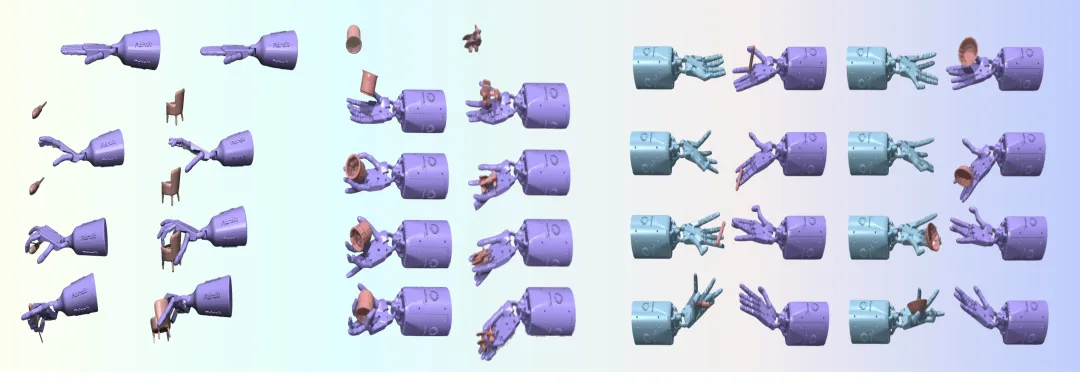
▲图3 | DexRepNet++:灵巧手与物体的几何交互表征©【深蓝具身智能】编译
DexRep 不仅关注物体本身的三维形状,更强调灵巧手各指节与物体表面的相对空间关系,将这种精细的几何信息融入深度强化学习(DRL)框架中。
研究团队在抓取、手内重定向(in-hand reorientation)和双手交接(bimanual handover)三类灵巧操作任务上进行了验证。
在抓取任务中,仅用40个训练物体学习的策略,在超过5000个未见过的多类别物体上实现了87.9%的成功率,大幅超越了用数千个物体训练的现有方法;
在手内重定向和双手交接任务上,相比现有手物表征方法,成功率和其他指标提升了20%至40%。
此外,研究团队还将 DexRep 策略部署到了真实世界,在多摄像头和单摄像头两种配置下均展现出较小的仿真到现实(sim-to-real)差距。
用人类操作视频训练机器人:图生成模型的新路径
论文标题:Learning From Videos Through Graph-to-Graphs Generative Modeling for Robotic Manipulation
一句话推荐:互联网上有着海量的人类操作视频,但如何将这些无动作标签的视频转化为机器人的控制策略?研究提出了一种新颖的"图到图(Graph-to-Graphs)"生成模型,为无监督视频预训练开辟了新路。
发文团队:北京理工大学
收集带有精确关节力矩标签的机器人演示数据成本极其高昂,而人类操作视频则随处可见。然而,视频数据缺乏机器人控制所需的动作标签,如何跨越这道鸿沟是具身智能数据扩展的核心挑战之一。
北京理工大学团队提出的 G3M(Graph-to-Graphs Generative Modeling,图到图生成建模) 框架,将视频帧抽象为结构化的图表征:
物体顶点(object vertices) 捕捉场景中操作对象的状态;
视觉动作顶点(visual action vertices) 捕捉手部与物体的交互关系;
边则编码这些元素之间的空间关系。
在预训练阶段,模型学习在给定当前帧图结构的条件下,生成未来帧的图结构,从而隐式地学习到操作的物理规律和行为逻辑。
预训练完成后,生成的图结构作为条件信号,驱动下游控制策略将其映射为机器人动作。
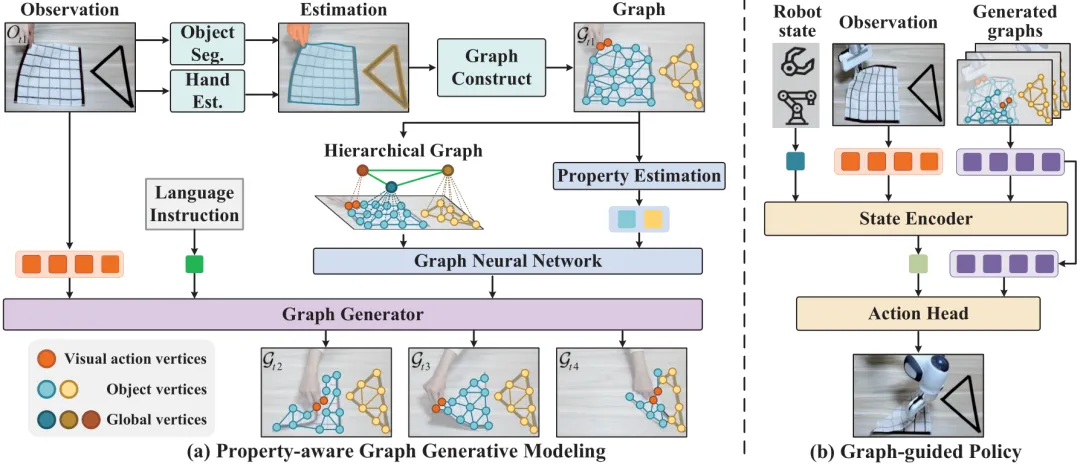
▲图4 | G3M 框架:从人类演示视频中提取结构化图进行生成建模©【深蓝具身智能】编译
实验结果表明,G3M 仅用20%的带标签数据,就能达到与使用全量数据相当的策略性能;
在仿真和真实世界实验中,分别比当时最优方法高出17%和23%;在跨本体迁移实验中,更实现了超过33%的提升。
这一结果证明:图结构表征有效地捕捉了操作任务中可迁移的空间关系,而非本体特定的动作细节。
扩散模型如何重塑操作学习:生成模型在具身智能中的系统梳理
论文标题:A Survey on Deep Generative Models for Robot Learning From Multimodal Demonstrations
一句话推荐:全面梳理了近年来生成模型在多模态机器人演示学习(Learning from Demonstrations)中的应用进展。
研究团队:FAIR、英伟达等
从 Diffusion Policy 到各类行为克隆算法,深度生成模型(Deep Generative Models, DGMs)正在重塑机器人的模仿学习。
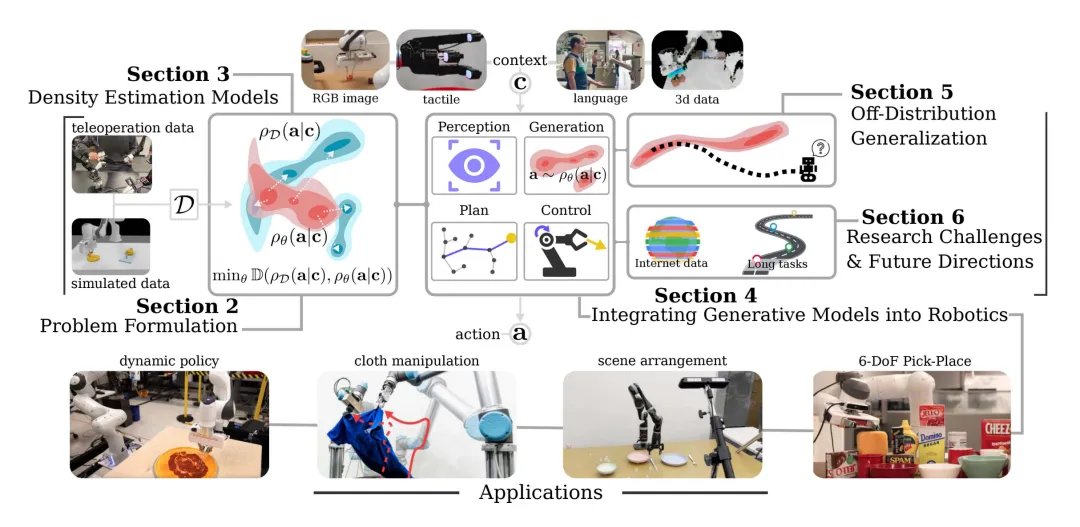
▲图5 | 深度生成模型在多模态机器人演示学习中的应用框架©【深蓝具身智能】编译
综述从模型类型和应用场景两个维度展开。
在模型类型上,文章系统梳理了能量基模型(Energy-Based Models)、扩散模型(Diffusion Models)、动作值映射(Action Value Maps)和生成对抗网络(GANs)等主流生成模型在机器人学习中的应用,并追溯了从早期变分自编码器(VAE)到最新流匹配(Flow Matching)方法的技术演进脉络。
在应用场景上,文章涵盖了从抓取生成、轨迹生成到代价函数学习的广泛任务。
而且,研究还对生成模型的泛化能力进行了深入分析,这也是具身智能落地的核心瓶颈。以及在提升分布外泛化(out-of-distribution generalization)方面的各种设计决策,并客观指出了当前方法在实时推理速度、多模态输入对齐以及安全性保障方面的局限性。
机器人操作学习的年度「参考答案」
回顾 T-RO 2026年上半年的这些代表性工作,我们可以清晰地看到具身智能操作技术的发展脉络:
-
数据层面,更注重任务、场景与本体的正交多样性,演示者差异性的影响也被首次系统量化;
-
表征层面,三维等变性和精细的手物几何关系正在解决泛化与高自由度控制的难题;
-
数据来源层面,从无标签视频中提取可迁移的结构化知识,正在成为降低数据采集成本的重要路径;
-
模型层面,从扩散模型到流匹配,生成式AI正以前所未有的深度融入机器人的决策中。
具身智能的突破,不仅需要算法的创新,更需要对物理世界交互本质的深刻理解,理论上成立不等于部署层面的问题已经解决。领域内的共有局限依然明确:
场景复杂度与现实环境仍有距离;示范数据获取成本虽有所缓解,标注依赖问题尚未根本解决;性能提升幅度需结合具体实验条件审慎解读……
编辑|阿豹
审编|具身君
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
