

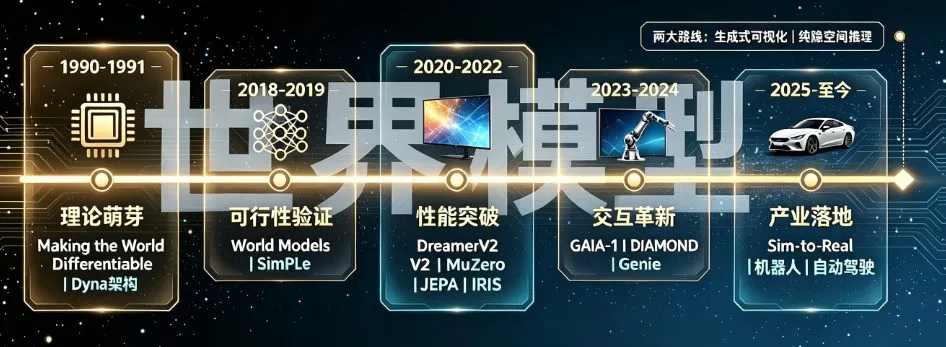
五波浪潮背后,世界模型始终在回答同一个问题
——35年发展脉络
世界模型走到今天,行业内部的分歧远比外界看到的更大。
一派坚持生成式可视化:让模型输出高清画面、构建可交互的虚拟世界;
另一派押注纯隐空间推理:放弃像素,只在抽象表征中完成因果推演。
但这种技术路线的根本分歧,早在 1990 年深度学习尚未兴起的行业寒冬期便埋下伏笔。彼时全球算力、数据体量与当下差距悬殊,早期世界模型理论更像是一场超前的人工智能思想实验。
此后三十年,世界模型经历了五次清晰的进化浪潮:
1990-1991:理论萌芽,建立世界模型底层数学原理
世界模型的雏形诞生于深度学习尚未兴起的低算力时代,这一阶段的核心命题极为纯粹:
世界模型的核心逻辑是什么?AI能否在自我模拟的虚拟环境中学习进化?
Making the World Differentiable
1990年,尤尔根·施密特胡伯发表《Making the World Differentiable》,提出世界模型最核心的底层原理:
让物理环境可微分(Differentiable World)。
传统仿真引擎是“硬编码规则”,只能固定执行预设物理公式,无法被训练优化;而可微分世界可以把环境的每一次状态变化转化为梯度信息,支持神经网络反向传播更新参数。
研究设计的循环神经网络(RNN)双任务架构,奠定了后世所有世界模型的基础:
一是环境预测任务,输入当前状态输出未来状态;二是智能体训练任务,在模型生成的虚拟环境中优化动作策略。
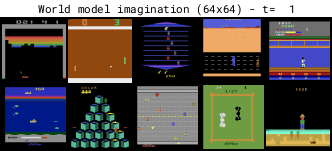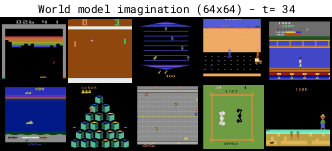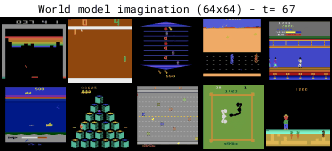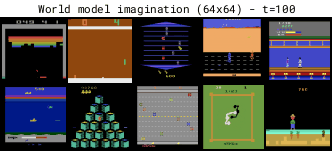
▲图| 早期简陋的世界模型©【深蓝具身智能】编译
Dyna架构
次年(1991年),强化学习泰斗理查德·萨顿提出Dyna架构,确立“观测—学习—仿真—行动”四步闭环原理。
传统AI将模型学习、策略规划、环境执行拆分为独立模块,效率极低,Dyna首次将三者统一:
智能体既可以在真实环境采样数据,也可以利用学习到的世界模型自主生成虚拟样本,用“梦境仿真”补充真实数据,解决了早期强化学习采样成本高、数据稀疏的核心痛点。
这两大理论确立了世界模型的本质:远远不是渲染画面那么简单,而是学习环境因果梯度,用仿真替代真实试错。
受限于当时的算力与数据短板,这两项开创性理论无法落地实践,更像是一场人工智能的思想实验。彼时全球算力总量、数字数据体量与当下相差亿万倍,没有任何硬件与工程能力支撑虚拟世界仿真训练。但这波萌芽浪潮奠定了行业终极方向:
真正的智能,源于对世界动态的模拟与动作因果的试错,不是静态符号的堆砌。
2018-2019:可行性验证,现代世界模型标准架构落地
沉寂近三十年是因为那时候算力不足,随着深度学习框架成熟、GPU算力普及、海量视频数据积累,世界模型正式迈入工程化探索阶段。
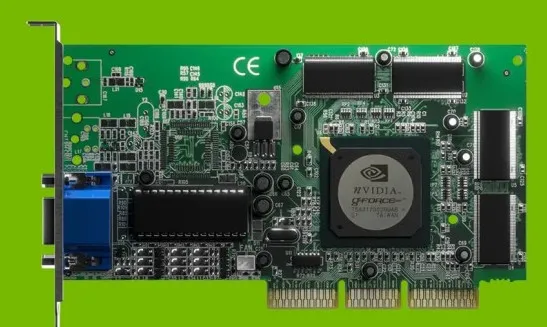
▲图 | 1999年的英伟达显卡©【深蓝具身智能】编译
这一阶段的核心命题是:世界模型的理论逻辑能否落地?AI在虚拟梦境中学习的模式是否真的有效?
World Models
2018年,大卫·哈与施密特胡伯发表的《World Models》,落地了行业首个标准化、可端到端训练的世界模型三层架构(V+M+C):
视觉编码器V + 记忆预测模型M + 动作控制器C新智具身智能
其核心技术原理是高维视觉压缩+时序动态预测:
-
视觉模型(VAE变分自编码器)将千万像素的高维画面,压缩为低维稳定隐向量,过滤冗余画面信息;
-
记忆模型(RNN循环网络)基于隐向量与时序信息,预测环境未来状态变化;
-
控制器根据预测结果输出最优动作。
整套架构不依赖任何人工物理规则,纯数据驱动学习环境动态。
该论文首次验证了纯梦境训练、仿真现实迁移(Sim-to-Real)的核心逻辑:
智能体全程在模型生成的虚拟场景中训练,零真实环境交互,依然能适配真实游戏场景,证明世界模型具备泛化能力。
SimPLe
2019年的SimPLe算法进一步优化工程落地能力,针对性解决传统强化学习真实交互步数过多的问题。
其核心技术创新是模型自适应采样机制:优先用世界模型仿真样本训练,仅在模型预测失效时补充真实环境数据。
在Atari 100k极简基准测试中,仅用10万步真实交互(约2小时游戏时长),即可精通26款游戏,样本效率是传统DQN算法的数十倍。
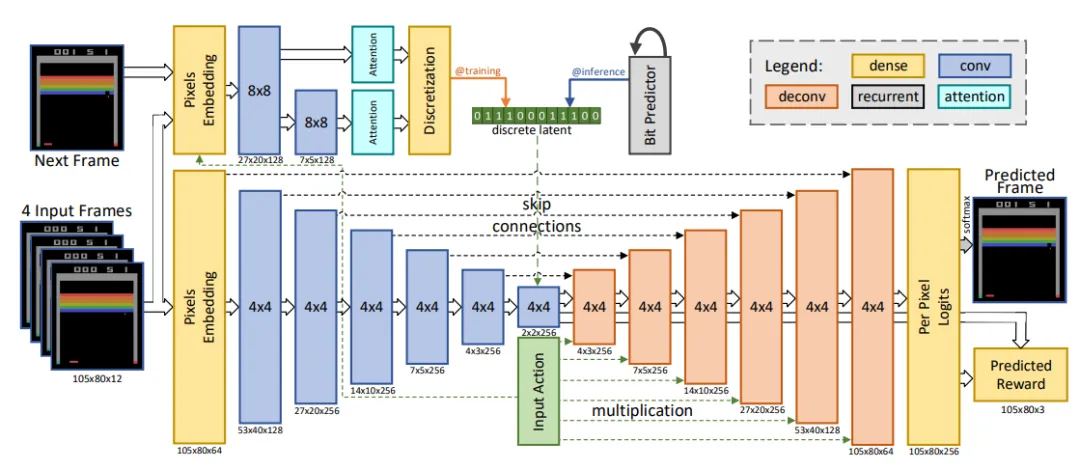
▲图| SimPLe的内部结构©【深蓝具身智能】编译
这一波浪潮确立现代世界模型核心范式:隐空间压缩(就是用小空间表示大空间)、时序预测、虚拟预训练、现实迁移,为后续性能迭代打通工程壁垒。
2020-2022:性能突破,两大核心技术路线定型
解决“能不能做”的问题后,行业探索重心转向“能不能做好”。
这一阶段的核心命题是:世界模型训练的智能体,性能能否比肩甚至超越人类?
这一阶段行业分化出沿用至今、原理完全对立的两大技术路线,定义了世界模型的技术上限。
DreamerV2
第一条是生成式可视化路线(DreamerV2,2020年),核心技术为RSSM循环状态空间模型。
区别于传统RNN,RSSM引入离散随机隐状态建模,不再预测单一固定未来画面,而是建模环境的随机性(环境随机不确定性),可以输出多种合理未来场景。同时通过循环记忆机制,持续累积历史时序信息,适配长序列任务。
凭借该原理,DreamerV2仅用单GPU训练,无需任何真实交互,就在55款Atari游戏达到人类平均水平,解决了早期模型时序记忆缺失、预测单一僵化的短板。
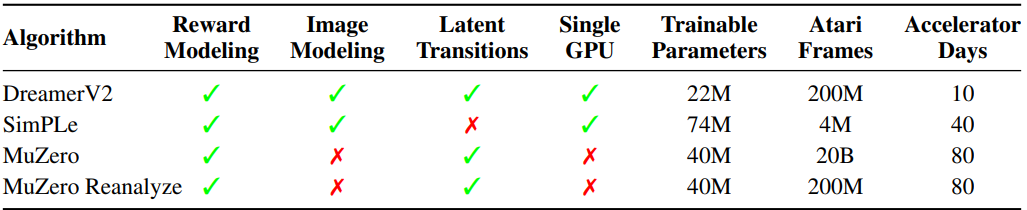
▲图| DreamerV2和其它模型对比,但请注意,这个来自Dreamer V2自己的论文©【深蓝具身智能】编译
MuZero
第二条是纯隐空间推理路线(MuZero,2019年),核心技术创新是无规则隐态建模+蒙特卡洛树搜索(MCTS)融合。
MuZero最大的突破在于完全舍弃了人工编写的游戏规则、物理参数、奖励函数,仅通过观测画面与最终结果,从零学习环境动态规律。
它不生成任何可视化画面,只在自主构建的抽象隐空间中完成状态推演与决策规划,大幅降低算力消耗。
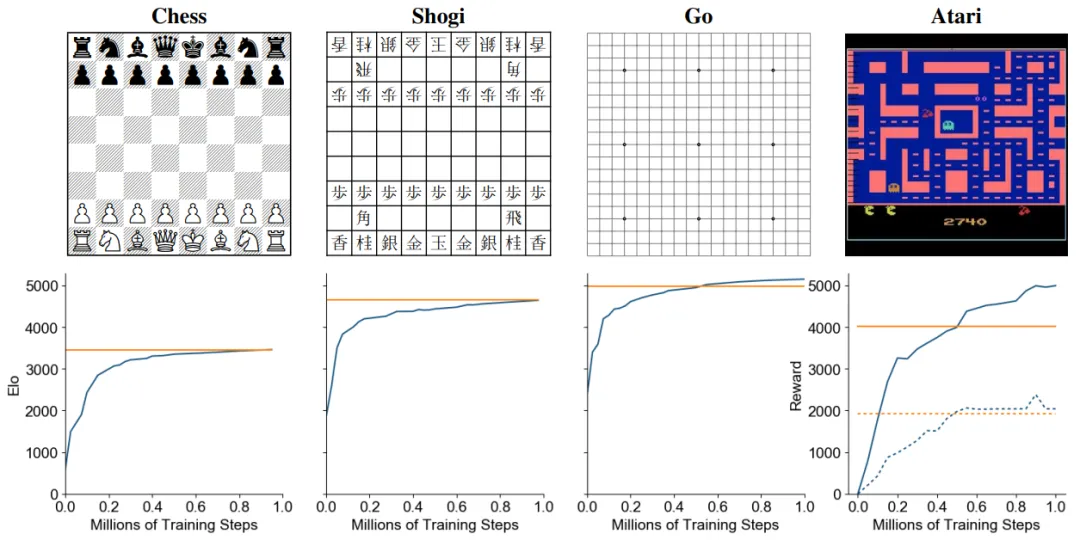
▲图| MuZero玩各种棋类和Atari©【深蓝具身智能】编译
凭借该原理,MuZero全面超越AlphaGo系列,不仅精通棋类博弈,更适配无固定规则的Atari游戏,证明抽象因果推理比像素生成更适配复杂决策任务。
JEPA
2022年两大里程碑技术,进一步完善两大路线的底层逻辑。
杨立昆提出的JEPA(联合嵌入预测架构),是隐式世界模型的集大成者,核心原理为屏蔽预测、因果表征学习。
JEPA刻意放弃像素级细节生成,只预测环境的高阶因果表征,主动舍弃光照、纹理、微小抖动等无意义随机噪声,只保留物体位置、运动趋势、物理约束等核心规律。
这一设计彻底解决生成式模型的“模糊预测、算力冗余”问题,推理速度更快、泛化性更强,成为机器人领域的核心架构。
▲图| 杨立昆的JEAP论文,少见的唯一作者论文©【深蓝具身智能】编译
IRIS
同年诞生的IRIS架构,将大语言模型的缩放能力引入世界模型,核心技术是视觉令牌化+自回归Transformer预测。
它把连续的图像帧离散为固定词汇表的视觉Token,模仿LLM预测下一个文字的逻辑,预测下一个视觉Token与动作结果。该创新让世界模型继承了Transformer的注意力机制、缩放定律、工程生态,首次实现同等数据量下AI性能超越人类,解决了传统循环模型无法大规模扩容的痛点。
这一波浪潮标志着世界模型彻底摆脱“玩具级应用”,在标准化任务中实现对人类能力的超越。
同时确立了生成式可视化仿真、隐式因果推理两大技术路线,为后续场景落地提供了核心技术支撑。
2023-2024:交互革新,动作条件建模与实时仿真技术成熟
随着模型性能达标,行业瓶颈转变为交互能力缺失,这一阶段的核心命题是:
能否打造真正可交互、可干预的实时世界模型,区分于普通视频生成模型?
这一阶段的核心技术分水岭,是确立动作条件概率建模(Action-Conditioned)的核心原理,彻底区分普通视频模型与真正的世界模型。
-
普通视频生成模型的数学逻辑为,仅根据历史画面预测下一帧,无交互、无因果;
-
而世界模型的核心公式为 ,将当前状态+人为/智能体动作作为输入,动作是环境变化的唯一干预变量,实现“动作变、场景变”的实时因果交互。
GAIA-1
2023年GAIA-1落地真实场景规模化世界模型,核心技术为时序序列建模+多条件融合。
模型以真实驾驶视频为训练数据,同时接收方向盘操作、车速、天气、文本指令等多维度条件输入,统一编码到时序特征中,实时推演车辆动态与路况变化。
同时首次验证:
世界模型完全遵循大模型缩放定律,数据量、参数量提升,推理精度与真实度稳定上涨,为行业规模化迭代提供理论支撑。
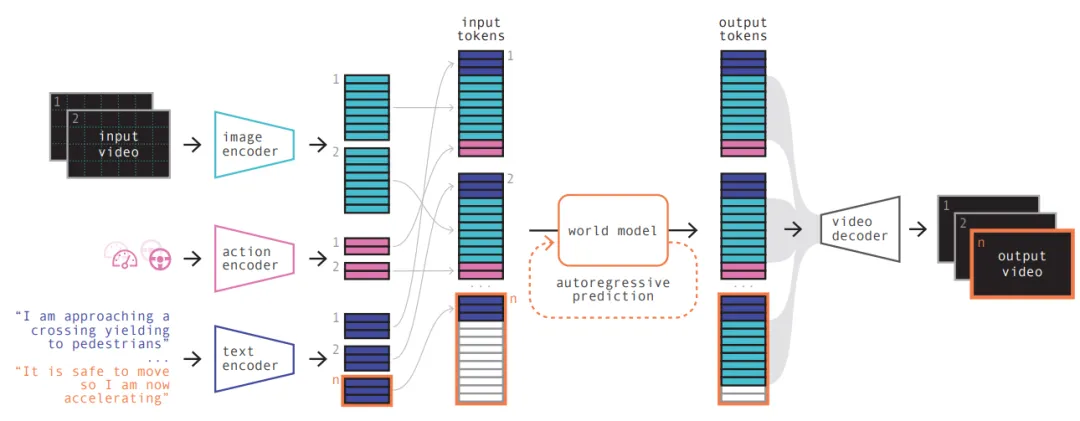
▲图| GAIA-1的架构。©【深蓝具身智能】编译
DIAMOND
2024年DIAMOND架构带来生成式世界模型画质与交互精度的质变,核心技术是隐空间扩散模型+光流匹配。
区别于传统自回归逐Token预测,扩散模型通过反向降噪迭代生成高清帧,保留纹理、光影、物体细微运动等细节;
搭配光流匹配技术,精准建模物体运动轨迹,解决了早期模型动作响应滞后、画面跳变、细节失真的问题。
仅用87小时游戏视频数据,即可训练出可实时操控、物理逻辑自洽的交互式虚拟场景,实现低成本、高精度仿真。
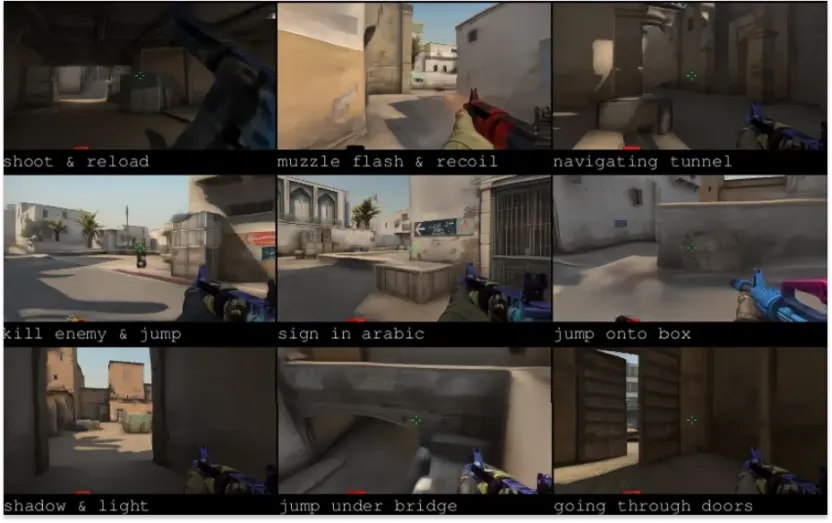
▲图| DIAMOND生成的反恐精英游戏世界©【深蓝具身智能】编译
Genie
同期谷歌Genie(2024年)模型实现了弱监督通用世界建模,核心创新是自监督动作空间挖掘。
无需人工标注按键、操控等动作标签,模型通过视频帧间的环境变化差异,自主聚类、学习人类操控动作空间,可从任意静态图像生成完整、可交互、符合物理逻辑的虚拟世界。
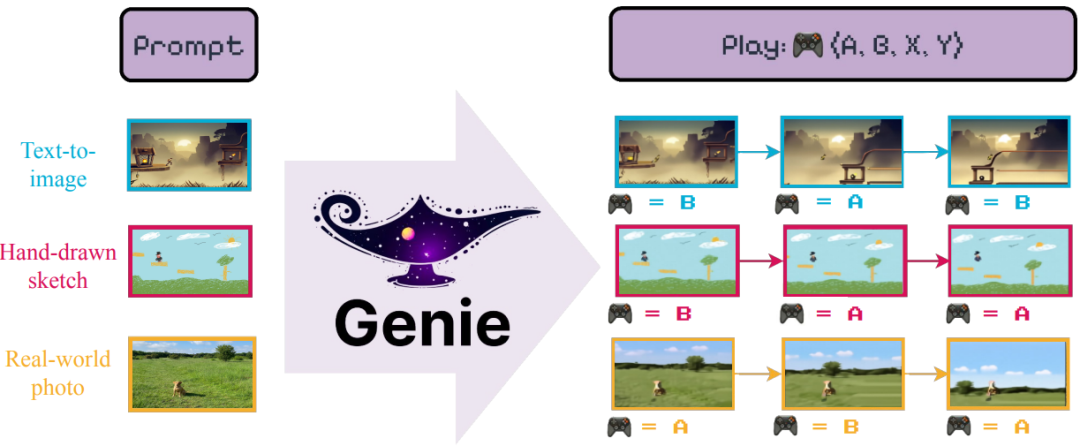
▲图| Genie模型示意图©【深蓝具身智能】编译
至此,行业彻底明确技术边界:视频模型是时序画面拟合,世界模型是动作驱动的因果环境仿真,具备可干预、可控制、可训练三大核心特性。
2025-至今:产业落地,仿真现实迁移与具身智能技术闭环
当前行业正处于第五波核心浪潮,也是世界模型从技术研发走向商业落地的关键阶段,核心命题升级为:
虚拟训练的世界模型,能否真正赋能真实物理世界的机器人、自动驾驶等实体设备?
本阶段核心技术突破是高保真Sim-to-Real(仿真到现实迁移),解决了长期以来“虚拟仿真完美、现实落地失效”的域偏移问题。
核心原理是:
世界模型训练时不再拟合理想化虚拟物理,而是学习真实世界的随机性、不确定性、微小扰动,让虚拟环境的物理规律、场景分布、故障模式与现实世界无限对齐,实现虚拟训练策略零适配迁移到真实硬件。
自动驾驶领域
GAIA-2搭载时空因子化Transformer+流匹配扩散模型,支持多摄像头环视仿真,可精准模拟极端天气、突发障碍物、人车随机交互等现实稀有场景,补齐真实路测数据不足、高危场景无法采集的行业短板;
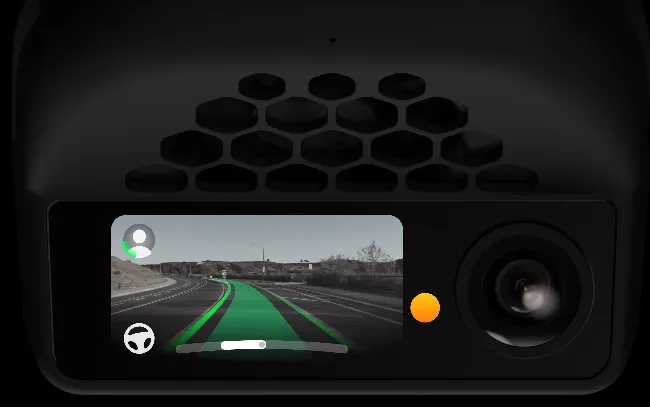
Comma.ai则落地端到端世界模型驾驶策略,彻底抛弃传统规则化自动驾驶算法,纯仿真训练模型直接量产上车,验证了世界模型在工业级场景的可用性。
机器人领域
V-JEPA 2优化了隐式世界模型的具身适配能力,核心技术为掩码自监督预训练+少样本微调。
通过百万级无标注视频预训练,学习通用物理因果、物体交互、运动规律,仅需数十小时机器人实操数据,即可完成下游任务适配,实现零样本新环境规划。相比传统机器人模型分钟级的推理耗时,V-JEPA 2依托轻量化隐空间推理,将决策耗时压缩至秒级,大幅提升实操效率。
SIMA 2则开创大模型融合路线,核心技术是语言时序推理+3D空间建模,将LLM的语义理解、多步规划能力与世界模型的空间动态仿真能力结合。
既能理解复杂自然语言指令,又能在三维物理空间中推演动作后果、自主拆分任务、适配未知场景,打通了“语言思考、物理行动”的智能闭环,成为通用具身智能的核心方向。
产业端
李飞飞World Labs、杨立昆AMI Labs、通用直觉等头部企业纷纷斩获十亿级美元融资,全球资本与人才持续涌入。
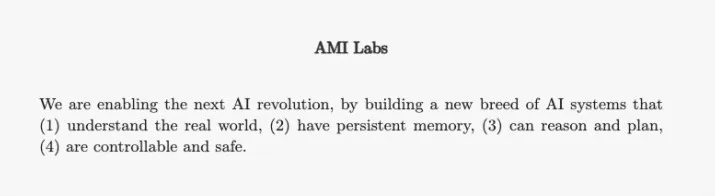
▲图| AMI实验室介绍©【深蓝具身智能】编译
发展到现在,世界模型彻底走出实验室,成为自动驾驶、通用机器人、工业仿真、智能游戏引擎等领域的核心底层技术。
写在最后
从1990年的理论萌芽,到现在的产业落地,世界模型的五波浪潮构成了一条比较明确的进化之路:
从思想构想验证技术可行性,从性能迭代超越人类水平,从交互突破搭建虚拟世界,从场景落地赋能真实物理空间。
相较于大语言模型的符号化智能(乔姆斯基的理念),世界模型补齐了AI的空间认知、因果推理、动作交互短板。
未来,随着两大技术路线持续融合、仿真迁移精度不断提升,世界模型将彻底重构人工智能的发展格局,也许真的会成为复刻我们所在的这个世界的平行宇宙,甚至会发现我们没有发现的我们的世界的规律,因为被世界模型自己学习到了。
编辑|咖啡鱼
审编|具身君
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
