

RSS 2026释放明确信号
——集体“回归物理”
作为机器人领域公认最具学术影响力的国际会议之一,今年 RSS 录用210篇,接收率不足 30%(比去年略高2%)。
最近RSS官方也最终公布了获奖论文的Final List;以及获得 Outstanding Paper、Outstanding Student Paper 与 Outstanding Systems Paper的三篇顶尖工作。
如果我们把这八篇论文放在一起看,会发现具身智能的研究正在向底层控制、轨迹优化、物理硬件甚至仿真引擎上转变。
接下来,我们将逐一盘点。
RSS 2026 Outstanding Paper
FlashSAC: Fast and Stable Off-Policy Reinforcement Learning for High-Dimensional Robot Control
-
发文团队:Holiday Robotics、韩国科学技术院、KRAFTON等
-
研究内容:
强化学习在控制高自由度机器人(如灵巧手、双足人形机器人)时,往往面临训练慢、误差容易累积的问题。
目前广泛使用的近端策略优化(PPO)算法虽然稳定,但数据效率较低;而离策略(Off-Policy)方法虽然能利用更广泛的数据,却经常因为价值函数的自举误差累积而导致训练崩溃。
FlashSAC 提出:减少梯度更新次数,转而利用更大的模型和更高的数据吞吐量,并对网络权重、特征和梯度施加严格的范数约束,从而在保持稳定性的同时大幅缩短训练时间。
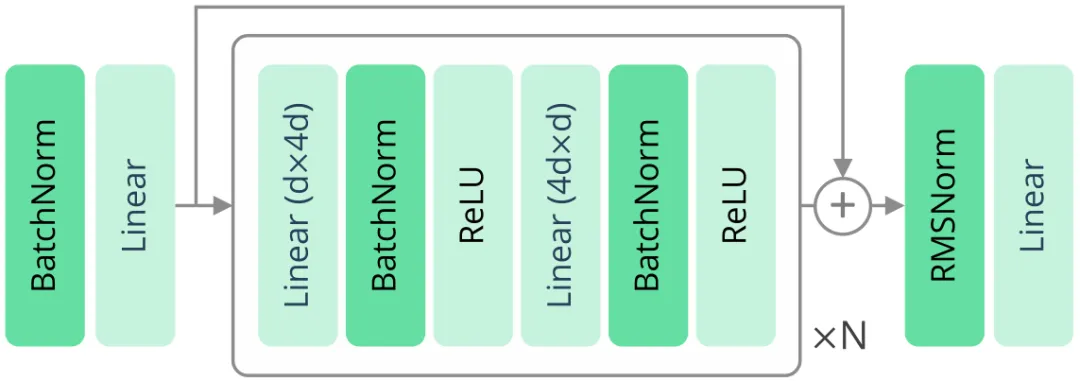
▲FlashSAC 的网络架构
该算法的核心在于重新平衡计算与数据,在 GPU 设置中使用了 1024 个并行仿真环境和千万级的经验回放池,并引入了倒残差骨干网络、层归一化以及分布式的评论家架构来压制误差。
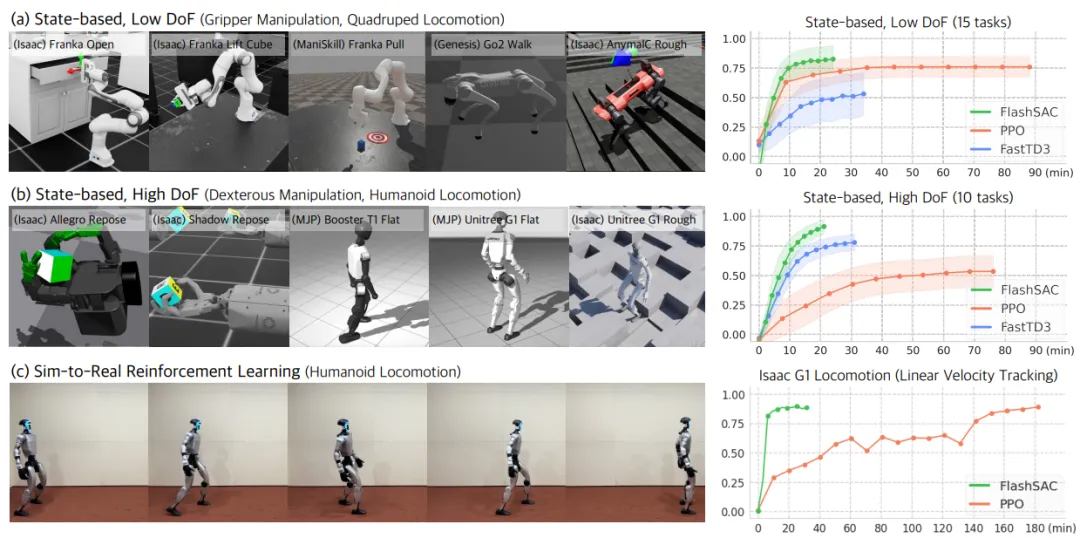
在覆盖 10 个仿真器的大规模评测中,FlashSAC 均展现出优势。
特别是在真实的人形机器人(Unitree G1)平地盲行走实验中,FlashSAC 仅需约 20 分钟就能达到稳定步态,而传统 PPO 方法则需要约 3 小时;在 15cm 高台阶场景中,FlashSAC 约 4 小时即可达到相近能力,证明了离策略强化学习完全可以胜任高维机器人的高效控制。
RSS 2026 Outstanding Student Paper
Muninn: Your Trajectory Diffusion Model But Faster
-
发文团队:伊利诺伊大学厄巴纳 - 香槟分校、佛罗里达国际大学普罗维登斯学院
-
研究内容:
扩散模型生成的轨迹平滑且考虑了多模态未来,但其反复去噪的过程实在太慢,难以用于需要高频响应的实时闭环控制。如果强行截断去噪步数或压缩网络,又容易牺牲轨迹质量或导致安全风险。
为了给扩散轨迹模型装上“免训练缓存”,Muninn 没有去重新训练一个小模型,而是设计了一个“缓存封装器”。
它把扩散模型的内部计算看作一种资源,在线评估复用上一步计算结果的风险。只有当容许的偏差预算耗尽时,它才真正去调用那个沉重的去噪网络。Muninn 利用一个轻量的探针来监测内部轨迹表征的变化,并结合解析系数来刻画去噪误差如何影响最终采样。
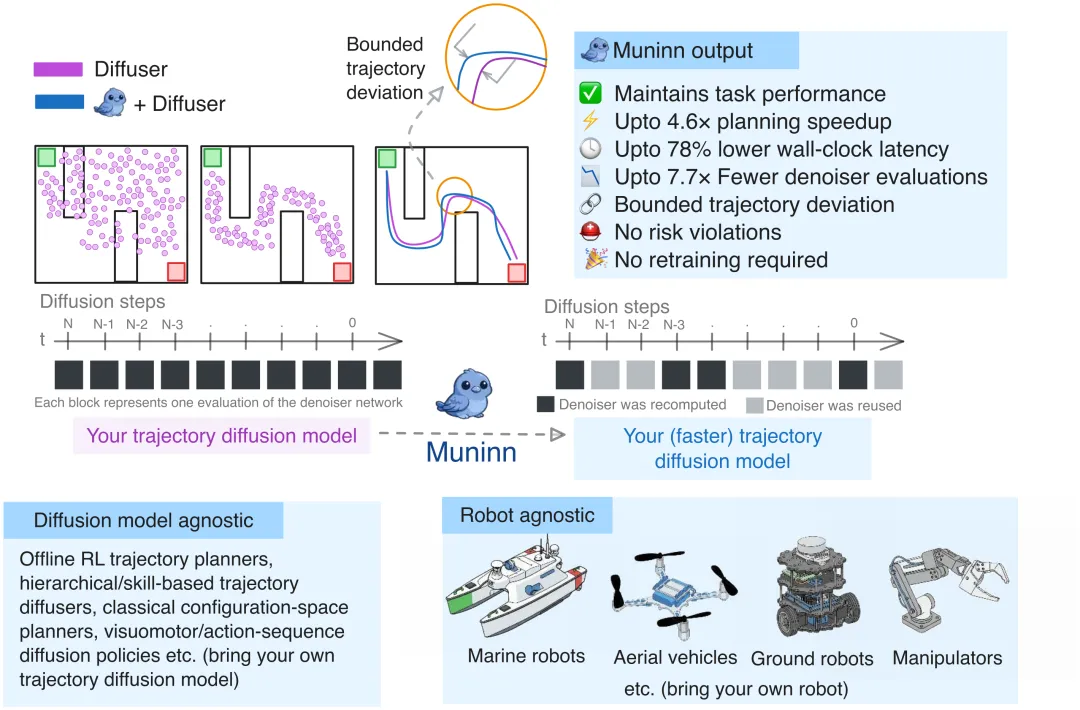
▲Muninn 的方法总览。© 深蓝具身智能 编译
在 NVIDIA A10 GPU 上的评测涵盖了离线强化学习、配置空间规划和视觉运动扩散策略,硬件测试包括水面无人船的航行、四旋翼无人机的航点导航以及机械臂的抓取放置。
RSS 2026 Outstanding Systems Paper
NeuralActuator: Neural Actuation Modeling for Robot Dynamics and External Force Perception
-
发文团队:麻省理工学院、亚马逊机器人
-
研究内容:
在低成本的机械臂上,由于齿轮摩擦、间隙和热效应,电机电流与实际输出的关节力矩之间并不是简单的线性关系。这种非理想特性导致了巨大的仿真与真机差异(Sim-to-Real Gap)。
NeuralActuator 提出,与其花大价钱安装高精度的力矩传感器,不如用神经网络把这些低成本电机的非线性状态“背”下来。
它不仅能预测准确的关节力矩,还能顺带预测外部接触力,让机器人在其设置下“白嫖”了力觉感知。该工作设计了一个基于 Transformer 的神经执行器模块,输入命令姿态、电流、电压、温度等历史状态,输出力矩、接触力以及电机工况评分。
团队采集了近 95 分钟的双臂遥操作数据,并在成本从约 500 美元到 3 万美元不等的三类机械臂上进行了验证。
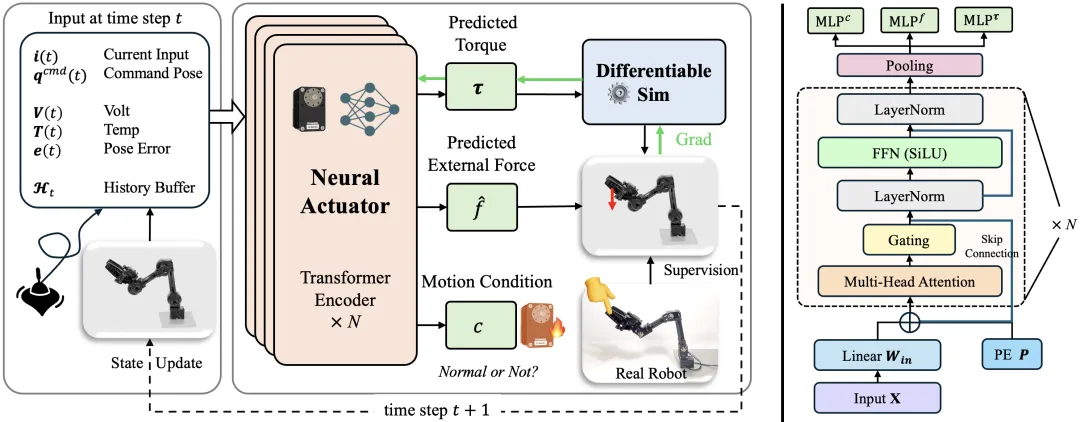
▲图3|NeuralActuator 的系统架构。© 深蓝具身智能 编译
在推力计验证中,预测外力的平均绝对误差仅为 0.0150.037 N;整体载荷评测误差在 0.080.12 N。将该模块作为冻结的感知节点接入行为克隆后,抓取放置任务的成功率从 80% 显著提升至 92.5%。
RSS 2026 Finalist
OAT: Ordered Action Tokenization
-
发文团队:哈佛大学、斯坦福大学
-
研究内容:
现有的自回归机器人动作分词方案存在无法调和的三重权衡:
逐维度分箱方法生成超长 token 序列、推理速度极差;
频域分词会产生无法完整解码的无效序列;
传统隐变量分词虽压缩与解码稳定,但 token 无层级有序结构,适配自回归预测效果差。
为了把连续动作压缩成有顺序的 Token,本研究提出的 OAT 设计了一种有序动作分词方法。
它把一段连续动作压缩成有因果顺序的短序列:
前面的 token 决定大致的动作轮廓,后面的 token 则像画笔一样逐步补充细节。
这种设计使得自回归策略可以根据当前的计算预算灵活选择生成深度,而不是死板地一次性计算全部细节。
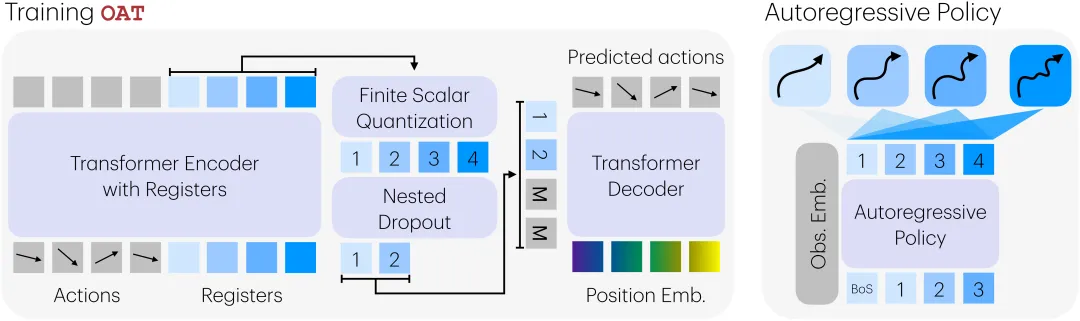
▲图4|OAT 的核心流程图。© 深蓝具身智能 编译
这种“由粗到细”的解码方式,不仅保持了较高的动作保真度,还赋予了机器人在推理时动态取舍速度与精度的能力,为高频动作生成提供了一种极具潜力的分词范式。
Emerging Extrinsic Dexterity in Cluttered Scenes via Dynamics-aware Policy Learning
-
发文团队:中国科学院自动化研究所、北京人工智能研究院、银河通用、北京大学等
-
研究内容:
在杂乱的环境中,目标物体往往被遮挡,机器人不能总是依赖直接抓取。
DAPL(Dynamics-aware Policy Learning)框架,让机器人学会了推、拨等非抓取式的“外在灵巧操作”,从而能够“借力打力”。
DAPL 先通过显式的世界模型学习物体碰撞、滑动时的动力学表征;、再用它来指导强化学习。
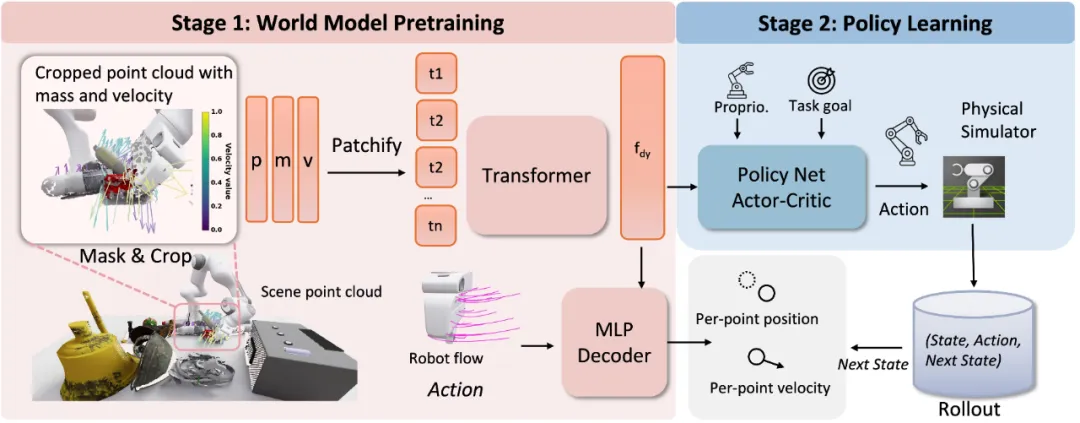
▲图5|DAPL 的两阶段学习框架。 © 深蓝具身智能 编译
这种动力学感知使得策略能够聪明地避开不必要的物体,或者借助接触翻转难以直接抓取的目标。
在未见过的仿真杂乱场景中,其成功率较几何基线高出逾 25%;在 10 类真实杂乱场景中成功率达到约 50%,并在货架整理中展示了实际部署潜力。
cuNRTO: GPU-Accelerated Nonlinear Robust Trajectory Optimization
-
发文团队:佐治亚理工学院,加州大学圣地亚哥分校
-
研究内容:
面对模型误差和外部扰动,机器人需要生成安全的鲁棒轨迹。但这通常涉及庞大的计算量,过去可能需要数十分钟甚至数小时。
本研究提出的 cuNRTO 重新设计了适合 GPU 并行计算的优化架构,用 CUDA 加速了最耗时的投影和增益更新步骤。
该架构将鲁棒优化拆解为适合异构计算的两层:
CPU 负责外层的连续线性化,GPU 则并行求解最耗时的内层问题。在单轮车、四旋翼和 Franka 机械臂的仿真中,该架构最高实现了 139.6 倍的加速。
对于 7 自由度 Franka 机械臂,NRTO-FullADMM 相对 CPU 基线达到 25.9 倍墙钟加速;搭配 NRTO-LE 线性化误差补偿扩展后,可实现 100% 约束满足,将原本耗时的鲁棒优化推向更快求解区间。
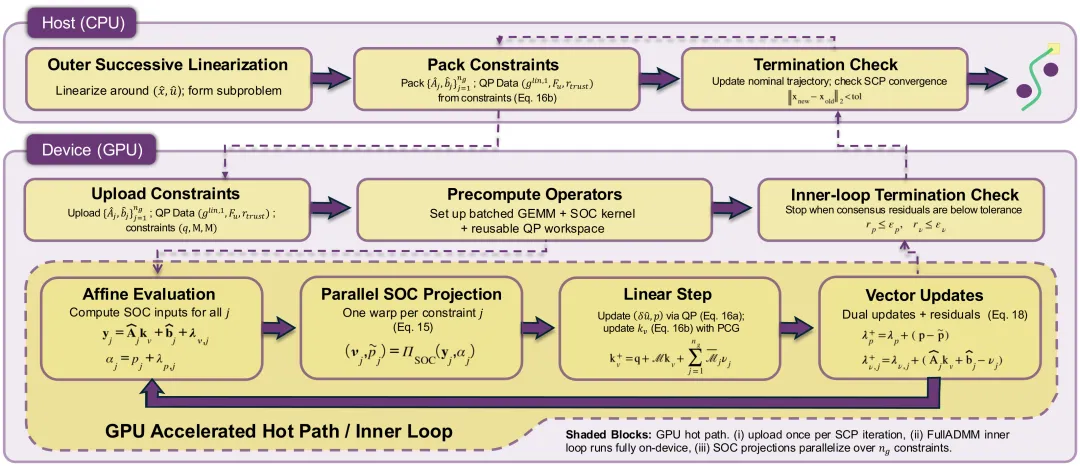
▲图6|cuNRTO 的异构计算架构。© 深蓝具身智能 编译
Realizing Robotic Swimming with Unified Fluid-Robot Multiphysics
-
发文团队:CMU、MIT
-
研究内容:
水下机器人的控制难题在于:处理机器人多体动力学与流体 Navier–Stokes 方程之间的强耦合效应。
传统方案多采用分离式求解,流体与刚体动力学分步计算,再通过界面交换力实现耦合,计算成本高,在多体机器人场景下易产生数值病态问题。
本研究将机器人与流体整合为单一系统,由变分法直接推导耦合控制方程;借助离散变分力学设计稳定积分格式,并改进浸入边界法,得到适配多体系统、条件良好的流体 - 机器人无滑移约束。
整套框架拥有更高的物理一致性,能够更好保持动量与能量守恒。该方法在游动和抓取物体的仿真中,将计算速度提升了两个数量级(从数百秒缩短至数秒),并且在能量耗散和动量传递上展现出极高的物理一致性。
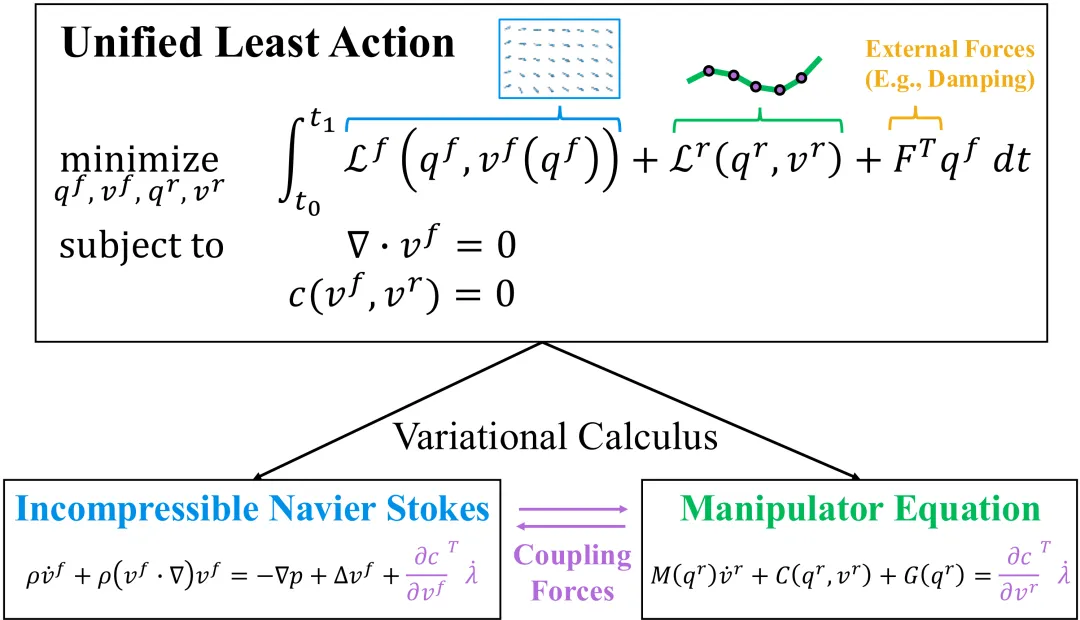
▲图7|统一最小作用量模型。© 深蓝具身智能 编译
Automated Synthesis of Facial Mechanisms for Conversational Animatronic Robots
-
发文团队:清华大学、BAAI、北京航空航天大学
-
研究内容:
传统仿生机器人头部需要工程师手工反复调试连杆规避运动干涉,设计周期漫长、难以批量定制。
本文研究提出的一套全自动分层机械设计体系,仅输入单张 2D 人像即可完成实体头部机构生成:
先重建 3D 人脸与语义地标,内层循环基于人体解剖约束、人类标准表情轨迹优化各连杆模块运动学参数;
再通过外层全局 CAD 装配碰撞检测,计算最小平移向量调整模块位置或缩减表情幅度,迭代输出无干涉、可直接制造的连杆结构。
整套算法十余分钟即可完成单脸型设计,远快于人工。
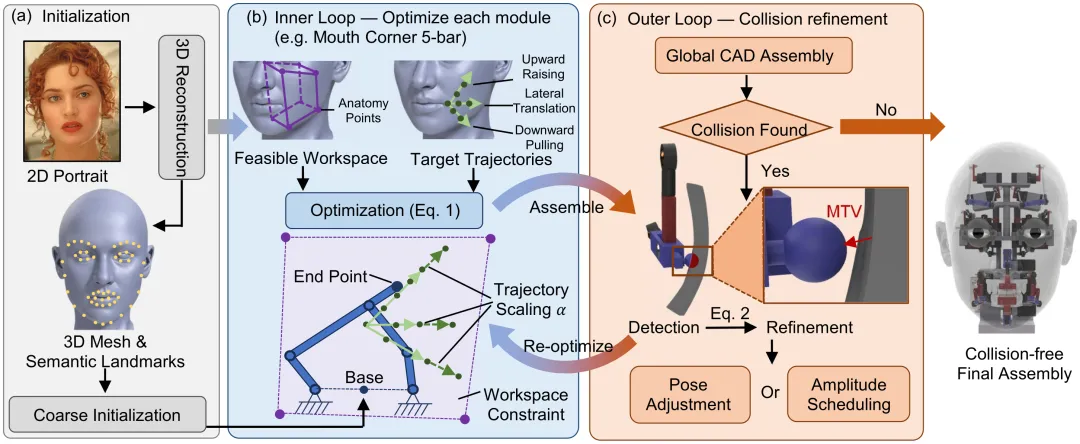
▲图8|面部自动设计的分层管线。© 深蓝具身智能 编译
写在最后
从今年的 RSS Final List 中,无论是 FlashSAC 在高维强化学习上的效率革命,Muninn 在扩散模型推理上的缓存加速,还是 NeuralActuator 对底层电机的神经感知化,都在致力于消除大模型与物理世界之间的“摩擦力”。
同时,OAT 的动作分词创新、DAPL 的动力学感知,以及 cuNRTO 和流固耦合模型在计算层面的重构,无一不在证明:
强大的机器人,须在算法、算力、物理规律与硬件设计之间找到完美的平衡。
编辑|阿豹
审编|具身君
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
