

明明是同一个房间,为什么需要六种不同的“地图”?
——在正确层级,选择正确表征
在具身智能、SLAM与机器人导航的研究中,我们经常看到2D视觉、深度、点云、占据栅格、语义地图和隐式地图等概念同时出现。
它们很容易被混为一谈:有人把深度图直接叫点云,把TSDF统称为占据栅格,或者把所有神经隐式表示都称为NeRF。
这些不能被简单定义为「术语偏差」,而是感知栈的「层级混淆」:
“
其实每一种表征都分别处在机器人感知栈的不同层级,依次回答了物体是什么、空间哪里可通行、场景需要长期记住什么这一系列根本问题。
这篇内容,我们便理清这条层级链。
它们并不处在同一层级
2D视觉、深度、点云、占据栅格、语义地图、隐式地图,这六个概念看起来像“并列的数据格式”,但是实际上横跨了传感器观测、几何表达、空间记忆和可学习场景表示多个层级。
为了把它们理清,我们可以先看其具身用途:
-
2D视觉回答“画面里有什么”,服务于识别与视觉伺服。
-
深度回答“沿视线看表面有多远”,服务于尺度估计与RGB-D SLAM。
-
点云回答“观测到的表面在哪里”,服务于配准、几何测量与抓取。
-
占据栅格与距离场回答“哪里空闲、离障碍多远”,服务于碰撞检查与导航。
-
语义地图回答“这里是什么、与任务有何关系”,服务于目标导航与指令落地。
-
隐式地图回答“任意坐标处的几何或外观是什么”,服务于稠密重建与连续空间查询。
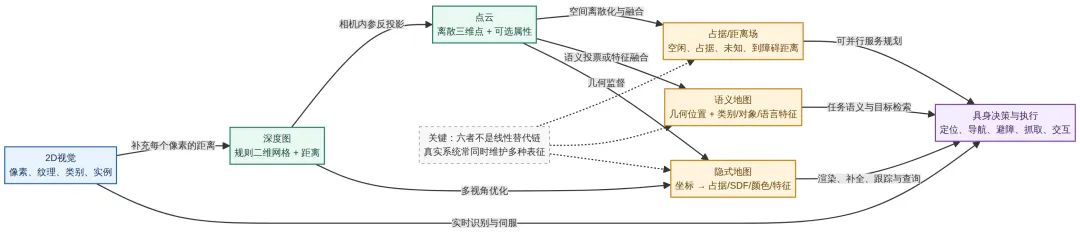
▲图1 | 具身感知并不是从二维到三维的单向“升级路线”。真实系统往往同时维护多种表征,让它们分别承担识别、定位、规划与执行任务。©【深蓝具身智能】编译
这里有两个最容易误解的地方。
第一,点云之后不一定必须进入占据栅格,点云可以直接用于抓取和三维检测,也可以分别进入距离场或语义地图;
第二,语义地图与隐式地图不是前后替代关系,前者描述地图保存“什么内容”,后者描述地图“如何表示”。
理解了整体定位,我们再逐一拆解这六类表征的本质边界。
2D视觉:回答“画面里有什么”,但不天然拥有三维尺度
对机器人而言,一张RGB图像首先只是一个规则的像素数组。
2D视觉的任务,是在图像坐标系中提取对行动有用的结构。
根据输出粒度不同,同一幅图像可以经过多种视觉模型:
图像分类输出整幅图的类别;
目标检测输出类别和边界框(如YOLO系列);
语义分割给每个像素分配类别;
实例分割则输出逐实例掩码(如Mask R-CNN);
关键点估计输出结构点;
可供性预测进一步尝试判断“哪里可抓、哪里可打开”。
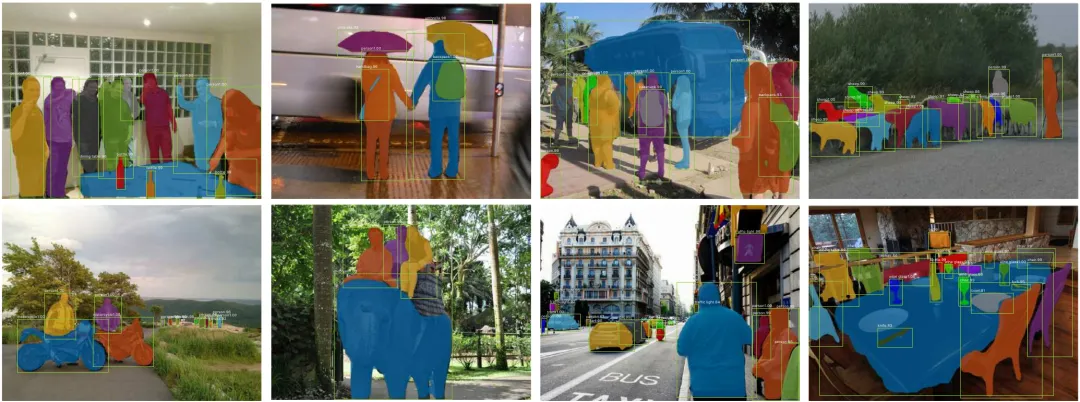
▲图2 | 2D视觉输出的实例分割结果。这类二维掩码和类别主要服务于画面识别,但因为缺乏深度,还不能直接转化为机械臂的三维抓取位姿。©【深蓝具身智能】编译
这些输出的共同点是:它们首先都组织在图像坐标系中。
视觉伺服可以根据目标在画面中的位置误差调整机械臂;当前大量视觉语言模型也主要接收二维图像,从中获得物体类别和关系。
对于“找出红色杯子”这样的任务,2D视觉往往是语义最丰富、成本最低的入口。
但2D视觉有一个根本边界:单张图像通常不能唯一确定真实三维尺度。
举个例子:
一个较小但离相机更近的杯子,可以与一个较大但更远的杯子在画面中占据相同像素面积。遮挡后的结构也不会因为模型“看懂了图像”就自动出现。
因此,“检测到杯子”只说明模型在画面中找到了一个区域,并不等于机器人已经知道杯子的三维位置。
深度:回答“当前视角下,表面离我多远”
当机器人需要触碰物理世界,它就必须获取尺度。
深度图在数据结构上仍然是一张二维规则网格,只是每个像素保存的不再是颜色,而是距离相关的数值。
深度可以来自双目视觉的视差估计、结构光(如RealSense D400系列)、ToF相机,或者激光雷达的扫描投影;单目深度模型则从单张RGB图像中学习几何先验。
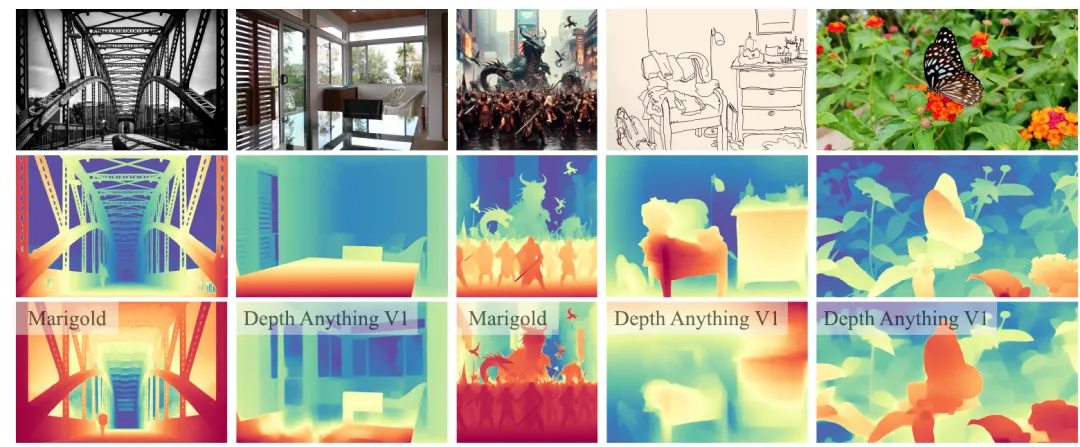
▲图3 | 单目深度模型输出的相对深度结果(中排)。这类结果能较好地表达画面中的远近次序与结构边界,但不等于可以直接用于步态规划的绝对米制距离。©【深蓝具身智能】编译
这里最需要辨析的是“相对深度”与“度量深度”。
许多单目深度模型(如早期的MiDaS)输出的是相对逆深度。这类结果能够较好表达远近次序和场景结构,却不必然直接给出以米为单位的绝对距离。
对于图像编辑,相对深度可能足够;但对于机械臂抓取和双足落脚,尺度误差会直接变成控制风险。
工程上,通常需要借助已知尺度标定或融合少量度量深度来实现对齐。
深度让像素第一次与物理空间发生直接联系,但深度图仍然是视角绑定的表面观测。它通常只记录从当前位置看到的第一层表面;桌子背面和被遮挡区域仍然未知。
点云:把深度反投影到三维,但“有点”不等于“有地图”
利用相机内参,深度图中的有效像素可以被反投影为三维点。
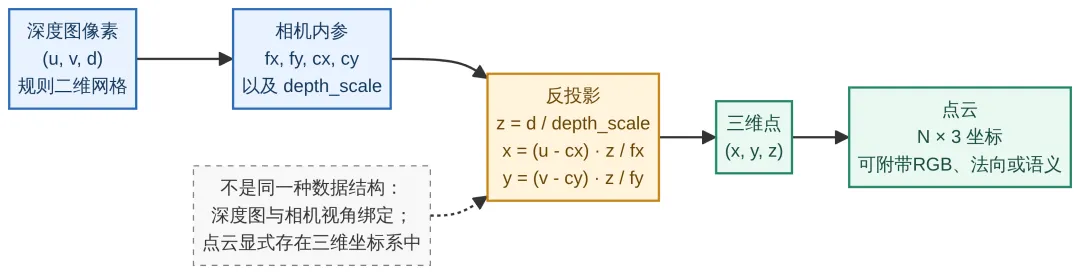
▲图4 | 深度图与点云的关系:前者仍按二维像素网格组织,后者则通过相机内参,将有效的距离观测显式写入了三维坐标系。©【深蓝具身智能】编译
深度图与点云表达的是同一批观测的不同组织方式:
-
深度图保留规则的像素邻接,便于使用二维卷积;
-
点云把每个有效观测显式放入三维坐标系,便于计算距离、法向和空间关系。
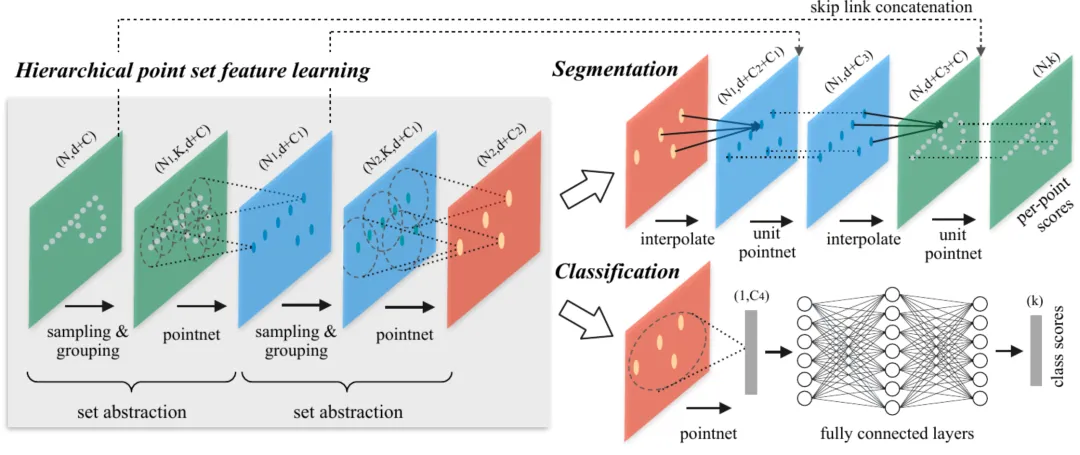
▲图5 | 点云处理流程示意。点云打破了二维图像的规则网格,系统可以直接在三维坐标系中对这些离散点进行层级化采样与几何特征提取。©【深蓝具身智能】编译
在具身任务中,点云常用于多视角ICP配准、局部法向与抓取位姿估计(如PointNet++、GraspNet等直接处理点云)。
但是,点云主要告诉机器人“观测到的表面在哪里”,而不自动告诉它“哪里已经确认是空闲的”。
一个没有点的区域可能确实是自由空间,也可能位于传感器视野之外,或被前景物体遮挡。
点云不会天然保存传感器射线穿过了哪些空间。
对规划器来说,“没有看到障碍物”与“已经观测并确认无障碍”是完全不同的安全语义。
占据栅格与距离场:同样是体素,保存的物理量完全不同
当机器人需要规划路线时,最关心的问题从“表面长什么样”变成了“哪里能走、离障碍多远”。
这就是占据栅格与距离场进入系统的原因。
经典占据栅格(如OctoMap)把空间离散成单元格,并利用贝叶斯更新维护每个单元被占据的概率,同时明确标记“空闲”“占据”与“未知”。
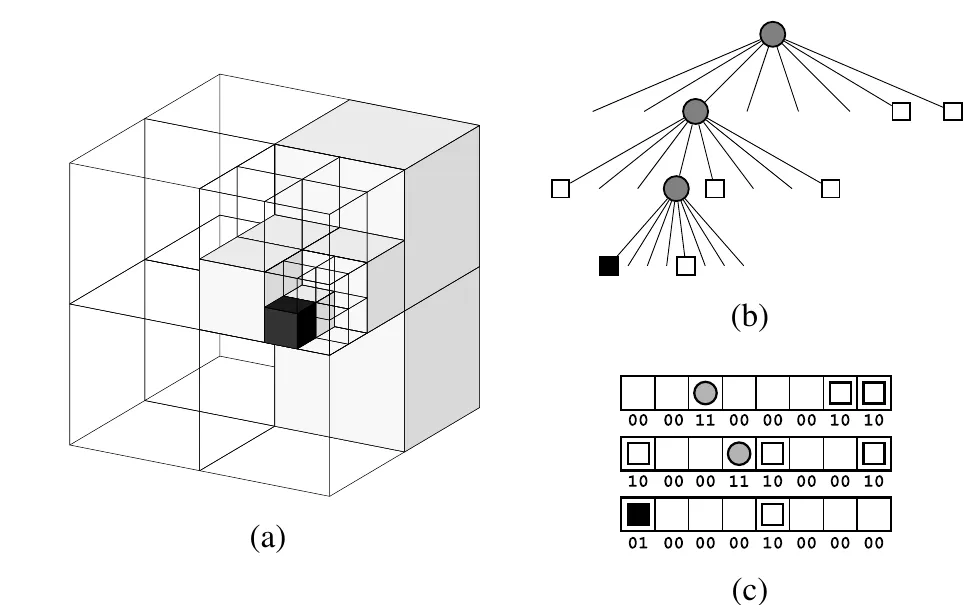
▲图6 | 占据栅格的三维空间切分。通过八叉树等结构,系统能够以概率方式明确记录哪些体素是空闲的、哪些被占据,以及哪些仍在传感器视野之外(未知)。©【深蓝具身智能】编译
在一些研究中,TSDF(截断符号距离场)、ESDF(欧氏符号距离场)与占据栅格经常被笼统地叫成“体素地图”。
它们确实都能存放在体素结构里,但每个体素保存的量和适用任务不同。
-
占据概率栅格保存被占据的概率,回答“这里是空闲还是占据”,常用于碰撞检查与探索。
-
TSDF保存到观测表面的截断符号距离,回答“表面零交叉在哪里”,常用于平滑融合多帧深度与网格提取。
-
ESDF保存到最近障碍物的欧氏符号距离,回答“离障碍还有多远”,常用于轨迹优化和安全余量查询。
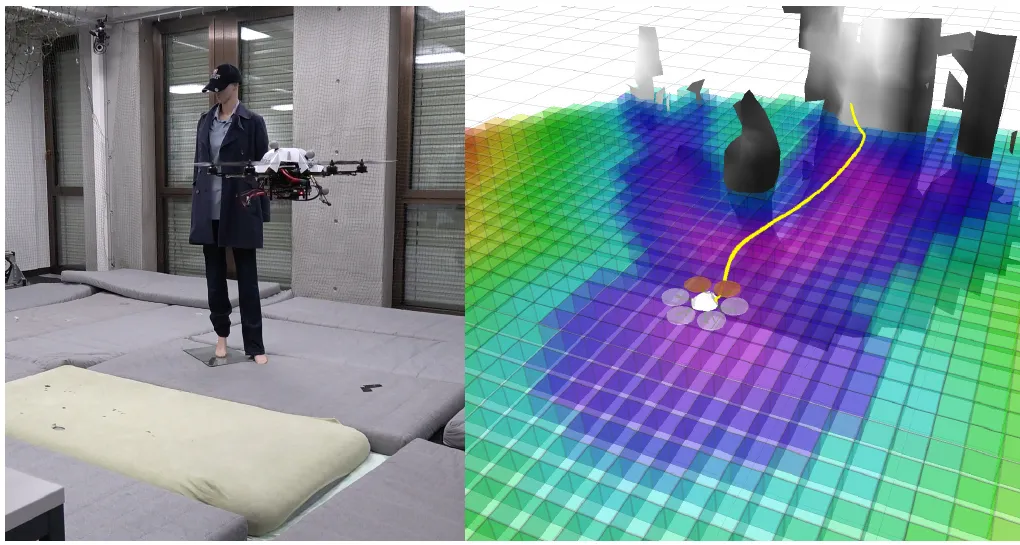
▲图7 | 欧氏符号距离场(ESDF)的规划作用。与只记录“是否占据”的栅格不同,ESDF直接保存了每个体素到最近障碍物的距离与梯度,让规划器能快速计算安全轨迹。©【深蓝具身智能】编译
这类地图的具身价值非常直接:
规划器不必逐个遍历原始点云,而可以快速查询某个候选姿态是否碰撞。
语义地图:不是把分割图上色,而是把意义锚定到空间
语义地图的核心,是在一个可持续查询的空间坐标系中附着类别、实例或语言特征。
一帧二维语义分割只告诉机器人当前画面里哪些像素属于“椅子”。
语义地图则必须结合相机位姿和几何观测,把不同视角的语义预测融合到统一的世界坐标系中。
“当前帧里有一把椅子”和“世界坐标 (x,y,z)(x,y,z)(x,y,z) 处长期存在一把椅子”是两种完全不同的信息。
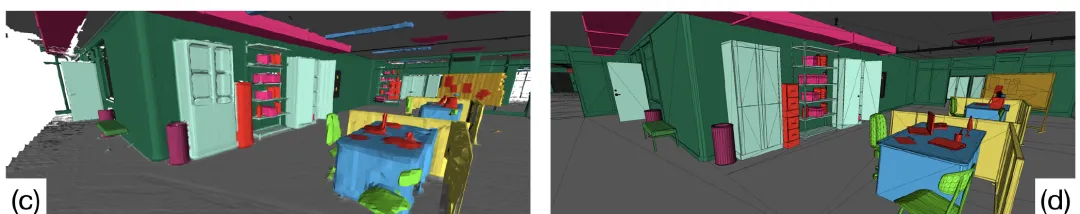
▲图8 | 三维度量—语义地图。场景表面不仅具有三维几何结构,每个体素或网格面也附着了语义类别。这使得“画面里有一把椅子”变成了“世界坐标系中长期存在一把椅子”。©【深蓝具身智能】编译
在融合策略上,常见方法包括贝叶斯更新、最大值投票或利用全景分割进行实例级建图。随着视觉语言模型的发展,语义地图也正在从“封闭类别”走向“开放词汇”。
VLMaps通过将预训练模型的像素级特征反投影并融合到三维地图中,让地图直接支持自然语言查询。
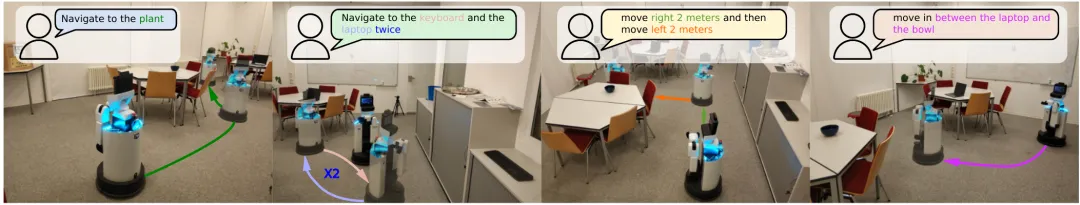
▲图9 | 开放词汇语义地图支持的语言导航。通过把视觉语言特征锚定到三维空间,机器人能够理解“在两张沙发之间移动”这类涉及空间关系的复杂指令。©【深蓝具身智能】编译
隐式地图:用可学习函数替代离散网格
前面讨论的栅格、体素、点云和网格,都是显式地图:把空间切分成具体的存储单元,分辨率越高,内存开销越大。
隐式地图则用一个可学习函数(通常是神经网络)来表示场景。
只要输入一个三维坐标,网络就能输出该处的占据概率、距离或特征。
NeRF是隐式表示在视觉领域的代表,但具身感知中的隐式地图不等于NeRF。
机器人更关心的是几何和占据情况,因此衍生出了隐式占据场、神经SDF和神经场SLAM等多种形式, 如iMAP、NICE-SLAM等系统能以小型MLP联合优化相机位姿和场景表示。
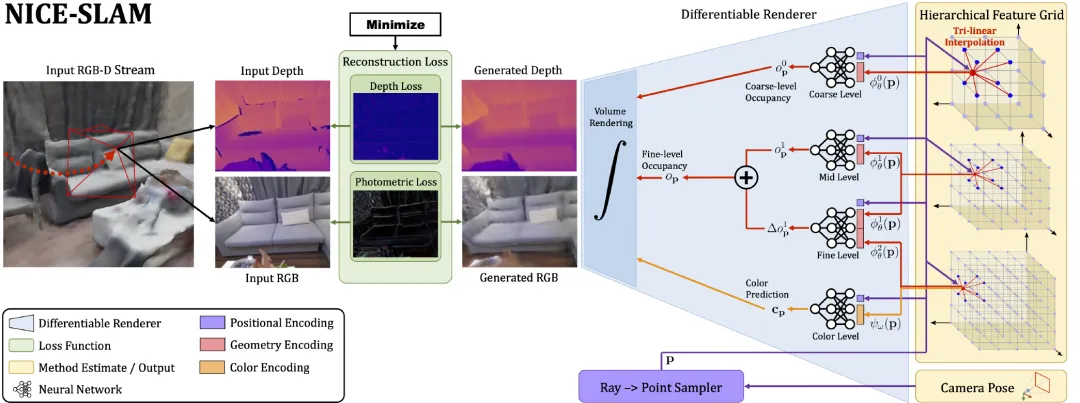
▲图10 | 隐式地图的神经表示流程。系统不再使用纯粹的离散网格保存数据,而是用可学习的网络与特征网格联合表示场景,支持连续的空间坐标查询。©【深蓝具身智能】编译
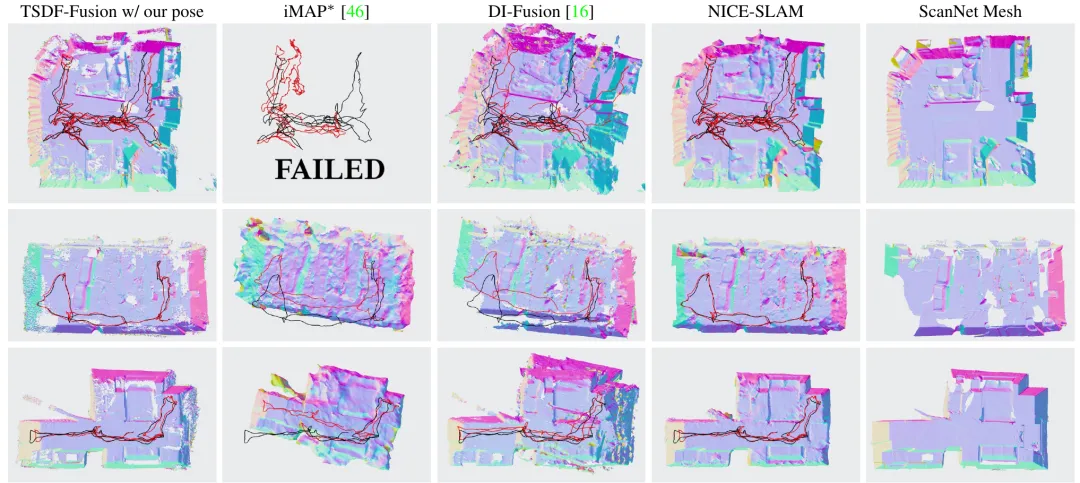
▲图11 | 神经隐式地图的三维重建效果。这类方法能同时处理相机跟踪与稠密重建,但目前在碰撞边界提取和在线更新速度上仍需针对具身场景做特殊优化。©【深蓝具身智能】编译
在正确层级,选择正确表征
从2D视觉到隐式地图,各类表征并非相互替代,而是共同构成了具身感知的完整能力栈:越是前端,越侧重实时反应与丰富语义;越是后端,越强调空间一致性与任务安全性。
实际系统往往在关键节点进行表征转换和融合,例如将深度提升为点云,再注入占据栅格做规划,同时用语义地图关联指令,又或借助隐式场完成高保真重建。
一台“优秀”的机器人,必然是一个能够在这些表征之间顺畅切换、取长补短的系统。
编辑|阿豹
审编|具身君
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
