

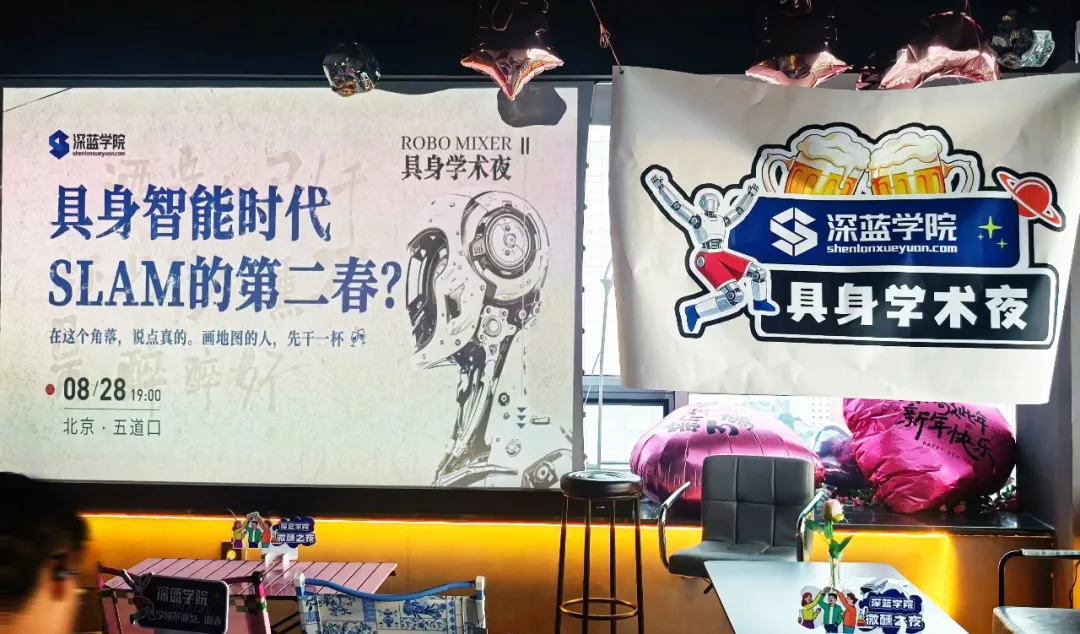
深蓝学院 · ROBO MIXER 具身学术夜
一些开放观点,在深蓝自由理性地探讨
深蓝学院-具身君
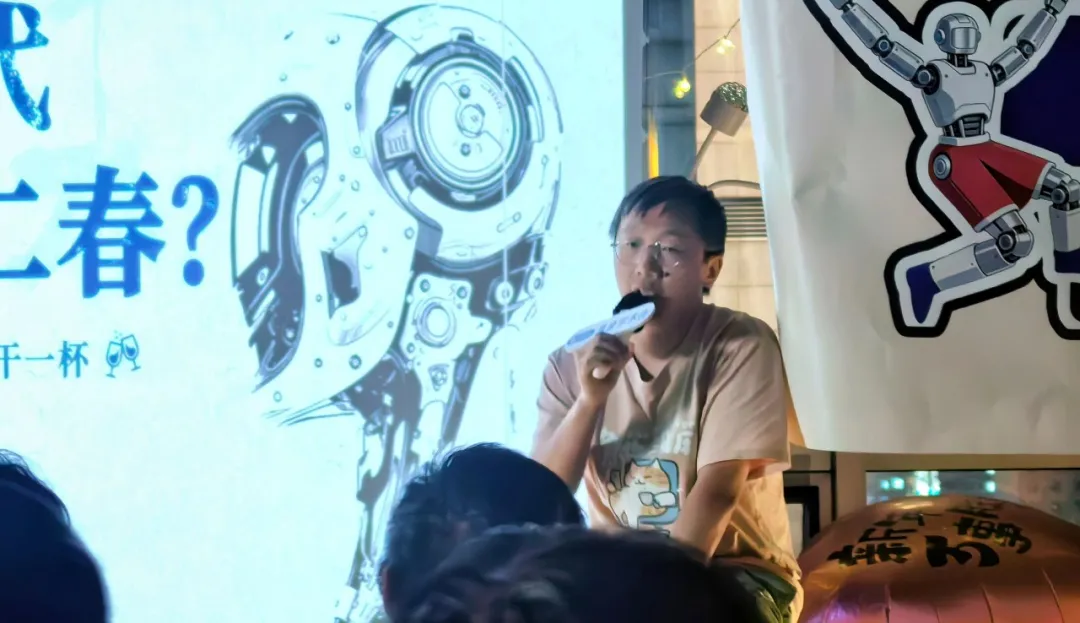
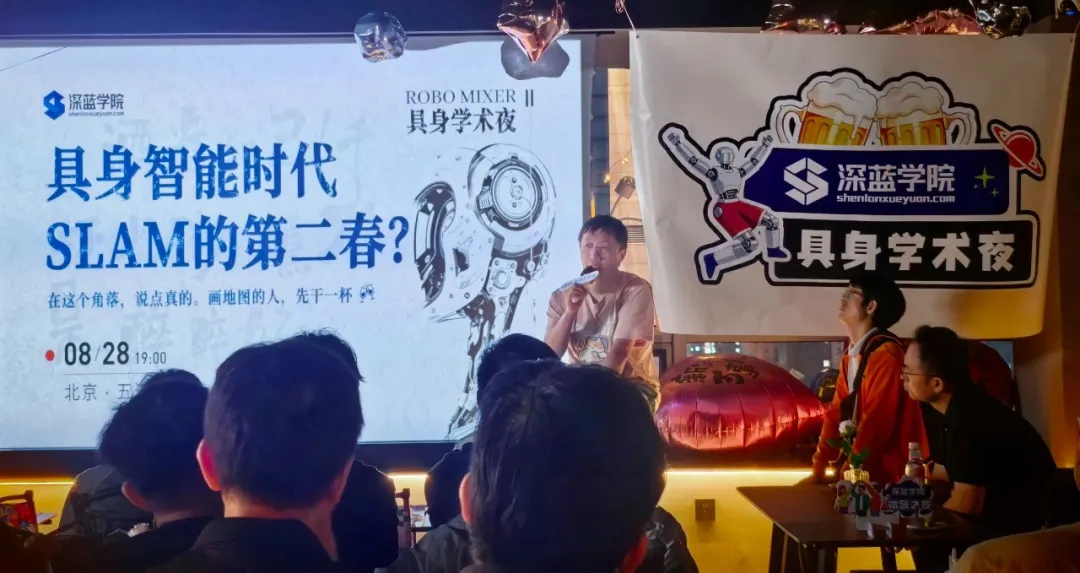
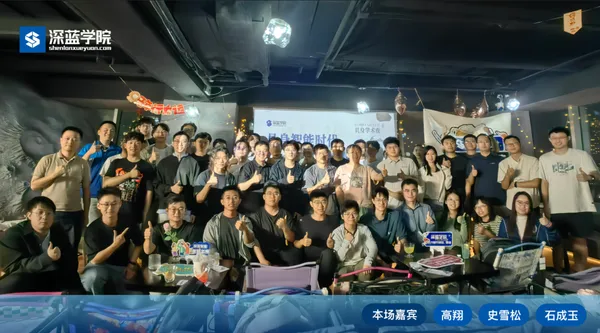
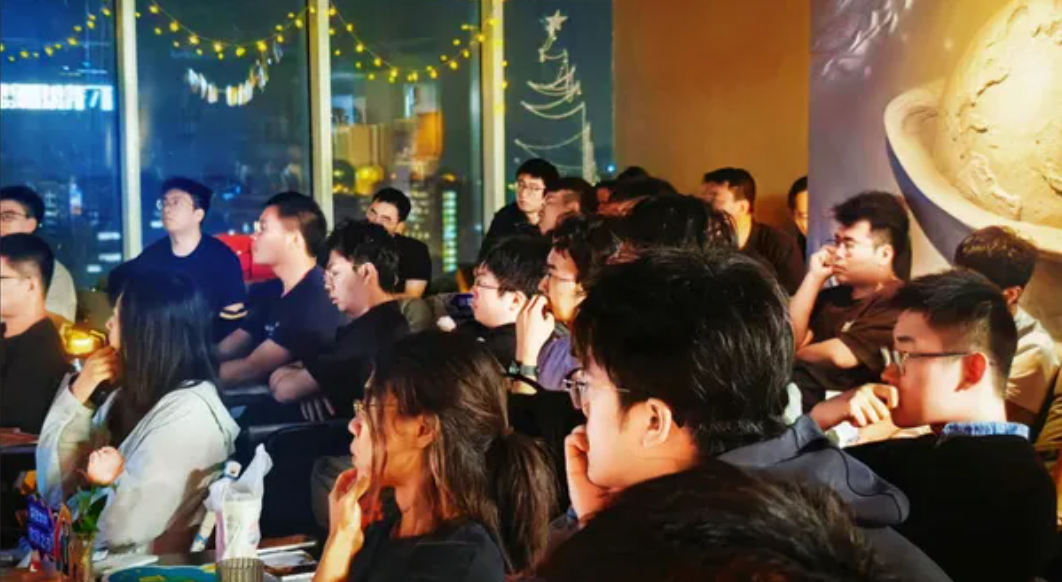
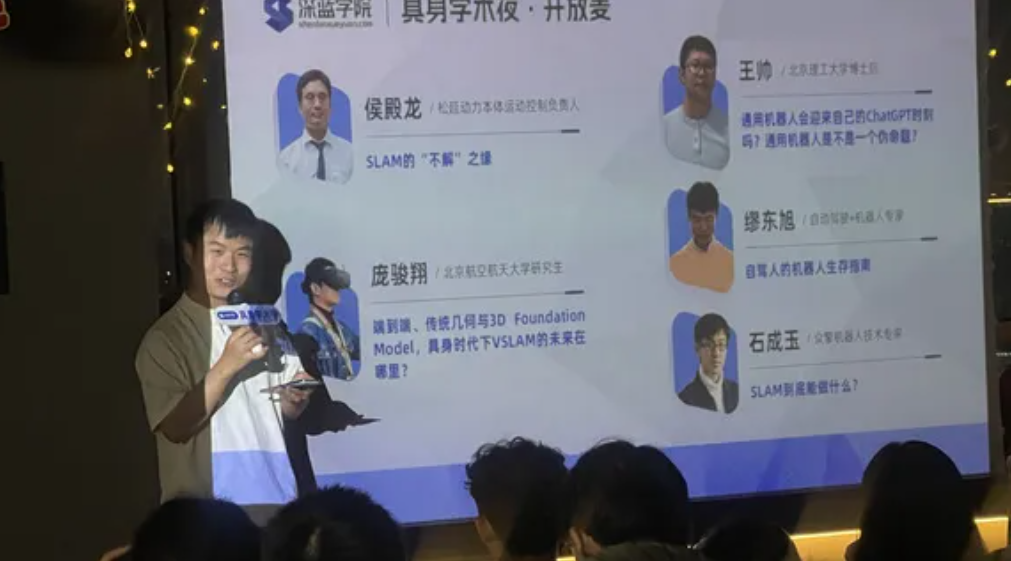
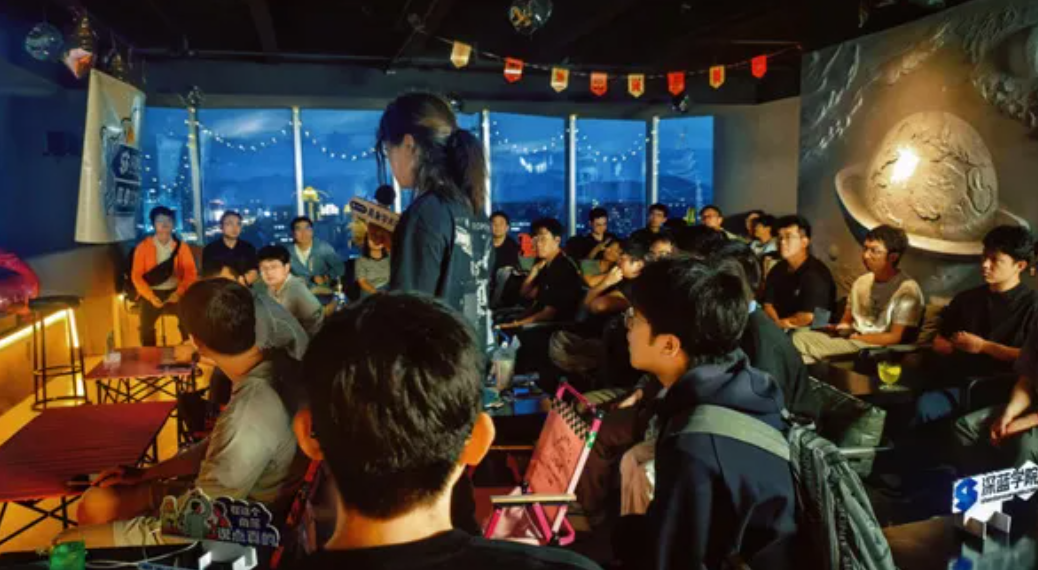
8月28日晚,北京五道口,深蓝学院「ROBO MIXER·具身学术夜」把一群年轻人聚在了同一个屋檐下。
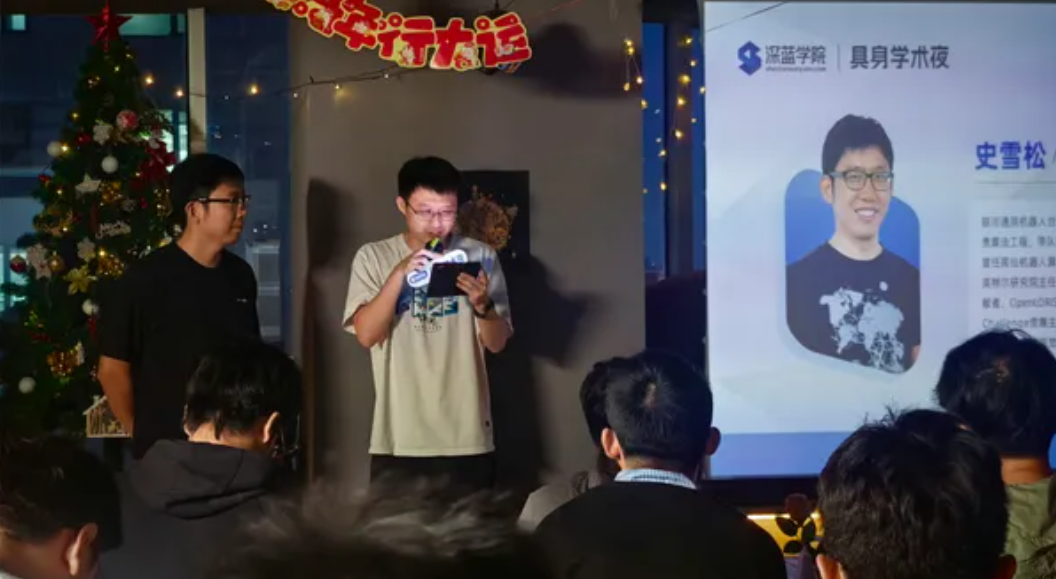
本场深蓝学院邀请了三位嘉宾:智身科技首席科学家《视觉SLAM十四讲》作者高翔、银河通用合伙人史雪松、众擎机器人技术专家石成玉。以及来自华为、百度、京东、蔚来、高德、面壁智能、灵心巧手、千寻智能、地平线、商汤、极佳视界、比亚迪、清华大学、北京航空航天大学等多家企业、高校的60余位参与者。
我们办的这场沙龙,主题起得直白:《具身智能时代,SLAM 的第二春?》
四个小时下来,反而聊到了一些当下整个行业很焦虑的问题。
离钱近的路,应该长什么样?
具身智能这几年,发布会很多,Demo 很多,融资新闻很多。但对着彼此的技术判断说实话的机会,很少。
开篇前,我们先聊聊这个“务实”的话题。
-
当前的主流叙事
高翔表示,当前的主流叙事是这样的:通用 VLA(视觉-语言-动作模型)会复刻大语言模型的成功之路。
数据越多、模型越大、算力越足,能力就越强,最终长出一个“什么都会干”的机器人基座。
比如,π0 / π0.5 那段时间是公认的拐点。据说,当时的数据不过是学校里几个学生采的,你采十段轨迹、我采一百段,拼一个数据集也能学出不错的效果。
这条路看起来已经被验证了,剩下的只是堆资源。
大厂确实是这么干的:采集工人每天十小时戴着头显高强度采数据,数据量翻了十倍不止。听上去,Scaling Law 即将在物理世界重演。
这条路的诱惑在于:一旦走通,赢家通吃。问题恰恰出在"一旦"上。
-
拆掉"更大"的地基
“更大是否就能更强”?我们拆成三个问题来看。
第一问:数据翻了十倍,模型能力真的涨了吗?
“当你的数据集扩大十倍、上百倍以后,模型能力并没有跟着涨,这是我现在看到的点。”
大厂高强度采集的新一代模型,在真机上并没有显著超过一年前的水平。
这不是孤例体感。
今年一项对 1228 篇 VLA 论文的系统分析得出了几乎一致的结论:这个领域自己的诊断,已经从“缺数据”变成了“naive scaling 失效”不同机器人混采的数据甚至产生负迁移,而精选 5% 的子集就能恢复全量数据 85–90% 的性能。
当前 VLA 数据集里的绝大部分「体积」,在做很少的「功」。
第二问:真做通用 VLA,模型得有多大?
这里大家可以来算一笔冷静的账。
能形成商业闭环的 coding 模型,国内两三百 B,国外主流1到1.5 T。而文字是一维推理问题,机器人操作是三维空间里输出高维连续控制——难度上了一个维度,模型至少还得再大一两个数量级。可现在主流 VLA 是 3B–8B,差着三到四个数量级。
按照这么看,意味着可能“就算做,也不是一两年内能收敛的事。”
这直接解释了当下 VLA 的产品化困境:3B 的模型说小不小,塞不进机器人端侧,推理要堆服务器级算力就没法产品化;说大不大,跟 VLM 比,3B 的 VLM 基本没法用,几十 B 的更大模型有人试过,也还没看出明显优势。
卡在中间,两头够不着。
第三问:VLA 本质上是个 BC,它没有 Planning?
VLA 是行为克隆,是反应式的。
比如,“我抓这个瓶子,并不是我认识到这个瓶子、我的任务里要去抓,而是我的训练数据里看到这个瓶子我就伸手。”
高翔做了一个 SLAM 人秒懂的类比:让机器人从 A 点到 B 点,经典方法是建图、列障碍物、跑 A* 搜出一条路;VLA 的做法是录一堆人从 A 走到 B 的轨迹,下次站在 A 附近,就沿着大家轨迹的"均值"走。你并没有规划,你在复读。
坑在于,现实扔给你的往往是从 C 到 D 的问题。语言上看起来相似,都是开箱、做作业,图像和轨迹数据却完全不同。
见过就见过,没见过怎么办?
只能靠茫茫多的数据去覆盖所有任务的可能性。而第一问刚刚说过,数据的边际效益正在衰减。
解决不了这三大问题,那么就意味着:更多的数据救不了一个没有规划能力的范式。
再者,训练信号本身到底怎么样?
loss 下降只说明模型输出的动作跟人越来越像,但人的动作有随机性、不保证最优、更不保证任务成功;而评测依赖的仿真仿真不了"我把瓶子打碎了、把桌子磕倒了"。
训练 loss 与任务成功之间的对齐,至今是个悬案。
至于眼下最当红的世界模型,不少人态度还是中立偏冷的。
“世界模型现在是个挺大的筐,做视频预测的叫世界模型,做 latent dynamics 的叫世界模型,做仿真的也叫——只要你有预测能力,你就可以叫自己世界模型。”
——高翔,智身科技首席科学家
一些人的预测是:这两年应该还会有快速发展,但很可能大家探索着探索着就碰壁了,发现这事儿不该这么做。
说回来,我们避免不了,会聚焦到务实的层面。
“一个大模型解决一切”是被资本叙事提前兑现的技术承诺。
模型的能力确实在涨,这要承认;但它的兑现时间表,比发布会 PPT 上长得多。
在它兑现之前,行业要活下去,要赚钱,要养研发,就必须找到另一条路。
上路之前更重要的是,路标是什么。
现实校验:史雪松给出的行业水位
史雪松则从另一个方向补上了现实校验:他把上一届世界人形机器人运动会的场景赛,当成一次公开的能力体检摆到了现场。
场景赛比的是机器人干活。
餐饮场景里,机器人要听懂“帮我拿一个包子和一个馒头”,自己拿起夹子,从热食柜取出商品放进饭盒,再听“请帮我加热一下包子”,打开微波炉、放入食品、关门、拧到指定时间,到点后开门取出放回饭盒;商超场景里:要自己读购物小票上货架取货,巡视发现缺货位,从补货框取货补齐摆正,还要把放错位置的商品归位——订单、缺货点位、商品位置全部随机;家庭场景更狠:不仅要完成收纳、叠衣服、挂衣服等长程任务,更要能具备抗干扰能力,赛题设置了突然到达的外卖,机器人要能立刻停下手中的工作,取完外卖,再继续之前的工作。
真正值得记下来的不是任务有多难,而是赛事的一个规则细节:允许人工遥操作参赛,但得分打五折。
结果是不少赛项的第一名,只有 150 分封顶的遥操成绩——真正敢全自主完成的队伍极少。
这个数字是整场沙龙里最诚实的市场信号。
它说明:在政府背书、媒体聚焦、头部公司尽遣主力的公开场合,行业对"通用自主能力"的信心,远没有对外宣传的那么足。多数队伍宁可分数减半,也要把人放在回路里。
史雪松还点破了一个被忽略的工程现实:很多头部具身智能公司,今年才开始开发自己的 SLAM 系统;而这届运动会的决赛,有队伍全场没跑起来,原因就是定位飘了——决赛场地是个大体育馆,空旷、天花板高、特征少,是 SLAM 的经典困难场景,而具身公司大多还没遇到过。
承认边界之后,架构就自然清楚了。
史雪松讲得很实在,参赛机器人最难啃的骨头就是上身操作——所有动作都得完全依赖模型自主完成。
为什么操作必须交给模型?理由很硬:软物体、密集摆放的主动接触操作,传统规则方法搞不定。
"你拿一个瓶子的时候,你的手一定会碰到两边的瓶子"
更根本的分野在于,机器人的操作是主动接触,贴着、挤着、碰着去干活,而自动驾驶的整个技术体系建立在"完全避免碰撞"之上,一个是高维空间里的连续博弈,一个是约束空间里的轨迹规划,方法论上根本不是一回事。
“未来的智能要更多靠数据驱动来突破,那就需要一种对模型更友好的方式,来实现机器人自身的定位、空间环境的理解和记忆。他给它起了个名字——Cognitive Mapping。”
——史雪松,银河通用联合创始人
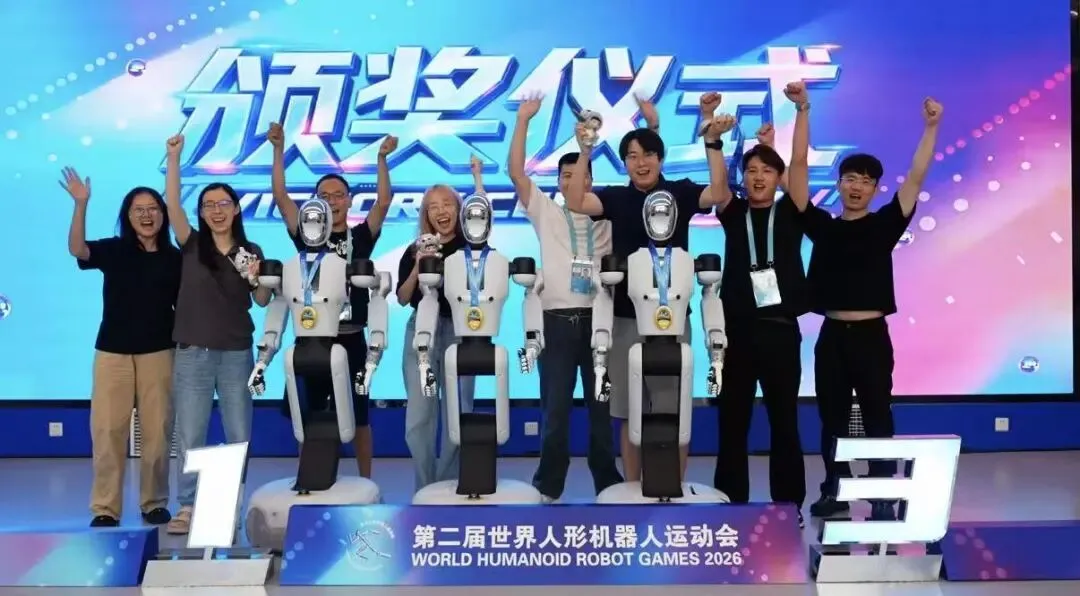
(图源|银河通用全自主问鼎三项最难场景赛冠军:家庭、餐饮、商超)
其实当天聊到的几个视角,某种程度上都指向同一个时间表:通用能力的兑现还需要时间,而行业必须在当下赚钱。
路在何方?
-
路标一:把"通用"换成"专一"
众所周知,在一些单任务上,0.1B、200M 的小模型在 LIBERO 这类基准上能做到 95 分以上,跟大厂模型打平。
一个只会干一类事的模型,比如专门拧螺丝的机器人,就只收集各种场景下拧螺丝的数据,能不能训出一个小巧但专一的模型?再配合强化学习,让它在真实部署里越干越快、越干越好?
这个事儿,大家觉得会不会可能是一个相对比较不错的落地做法呢?
因为通用路线,本质上赌的是「覆盖」。用一个足够大的模型把所有任务的可能性都“见”一遍。
专一路线,赌的是「闭环」。在一条窄任务上把数据、模型、部署、收益整个链条转起来。
前者是研究逻辑,后者通常是「资本/市场急切时」的生意逻辑。
当天几位上开放麦的分享者中,也提到了一些“悲观”看法。
开放麦来自北京理工大学的王帅,列了三组行业辩论:
-
人形机器人是比汽车更大的产业,还是下一个"自动驾驶式的泡沫";
-
每个家庭都有一台机器人,还是家庭恰恰是最后才会成功的场景;
-
机器人数据会形成超级飞轮,还是这个飞轮可能转不起来。
本质上这些问题都在聊一个事情,真正能产生商业价值、能进工厂的,都是专用机器人。一个通用机器人不做任何适应性改造,很难适应工厂环境。
而“生意逻辑”成立的证据,那天不止一处。
以下是几位开放麦的参与者分享的他们的切身经验与思考:
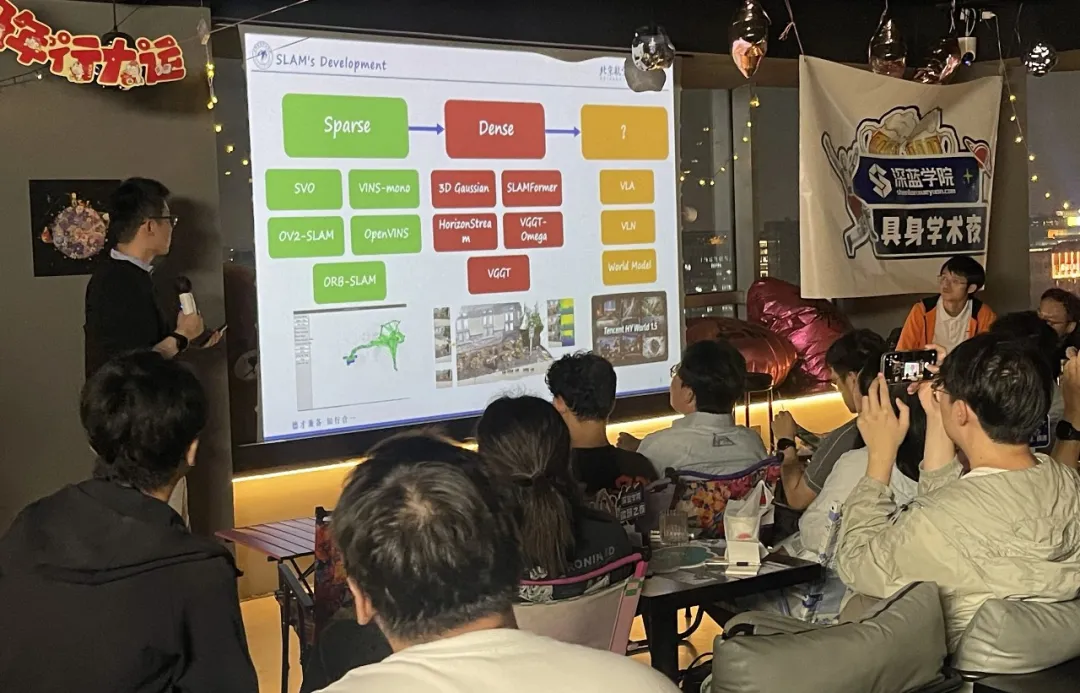
开放麦庞骏翔,北京航空航天大学:他从技术路线上给出了同构的判断。
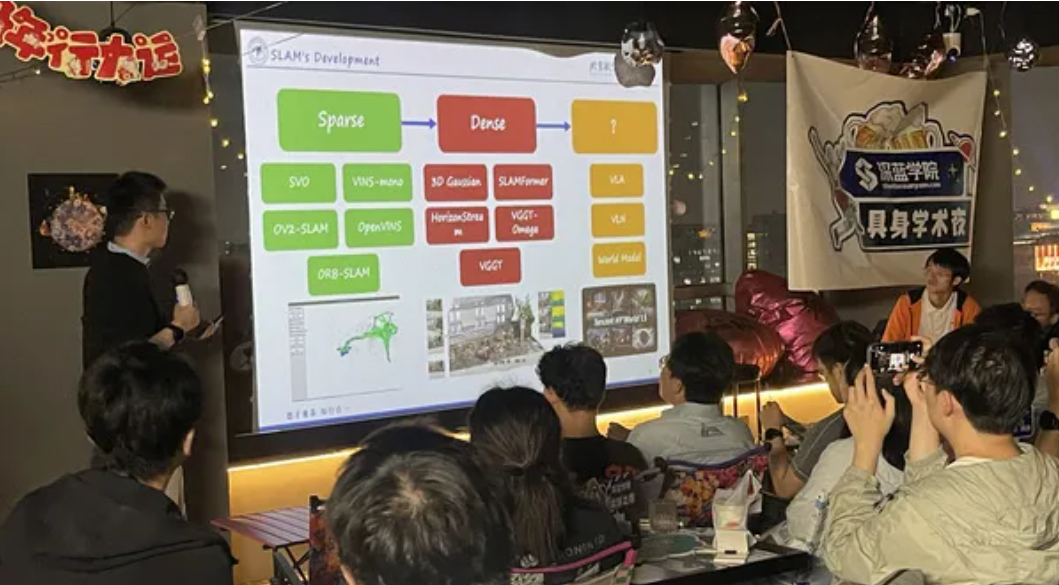
他把 SLAM 的发展概括为“从 Sparse 到 Dense”:Sparse 路线(ORB-SLAM、VINS-Mono)产业应用已经非常成熟,Dense 路线(3D Gaussian、端到端)更"聪明"但代价不小、局部精度仍有短板。
翻译成商业语言就是:新技术不是处处通吃,每个场景有每个场景的最优解,而"找到那个最优解"本身就是生意。
嘉宾高翔在问答环节还补了一个视角:行业数据是真实的壁垒。
基础模型没见过铁轨、矿区、电厂、风电站的巡检数据,就像语言模型不认识某个被分词器切碎的人名,碰到就乱套。
做得久、数据攒得长的公司,能垄断相对封闭的市场。
这句话几乎就是“专一路线”的商业模式的一种陈述:在一个垂直场景里把数据闭环转起来,别人可能就真进不来了。
-
路标二:不在存量市场卷,去新兴市场做第一个
专一还不够,还得选对专一的战场。
有观众问 VLN(视觉语言导航)落地有哪些好方案。
我记得,当时高翔的回答是:VLN 尴尬在它要替代的是一个已经很成熟的模块——传统导航接近 100% 的成功率,你的模型方法做不到,商业化就难。你在拿自己的短板去卷别人的长板,卷赢了也是惨胜。
反过来,叠衣服这种“传统方法压根做不了”的任务可能才是蓝海。
做机器人别在存量市场跟传统搬运机器人打价格战——那是个毛利率 10%–20% 的绞肉机;去新兴市场做第一个。
VLA 的优势是泛化和灵巧,是传统方法做不了的事;它的短板是稳定性和成功率,是传统方法已经做到极致的事。
拿 VLA 去打传统模块的存量市场,是用自己的短板换别人的饭碗;拿 VLA 去开传统方法进不了的新兴市场,才是把自己的长板变成定价权。
再加上小模型加 RL 的组合——在选定的窄任务上,模型不需要 300B,0.1B 就够;不需要覆盖所有场景,覆盖这一类就够;数据不需要百万小时,专一场景的积累就构成壁垒;部署不需要服务器级算力,端侧就放得下。
每一个环节,都同时是技术选择和成本选择。
这就是"离钱最近"的完整含义。
走上路,需要什么人?
一条路能不能走通,最终看有没有人走。
这场沙龙我们不可避免的,聊到了这个最让人踏实的部分。
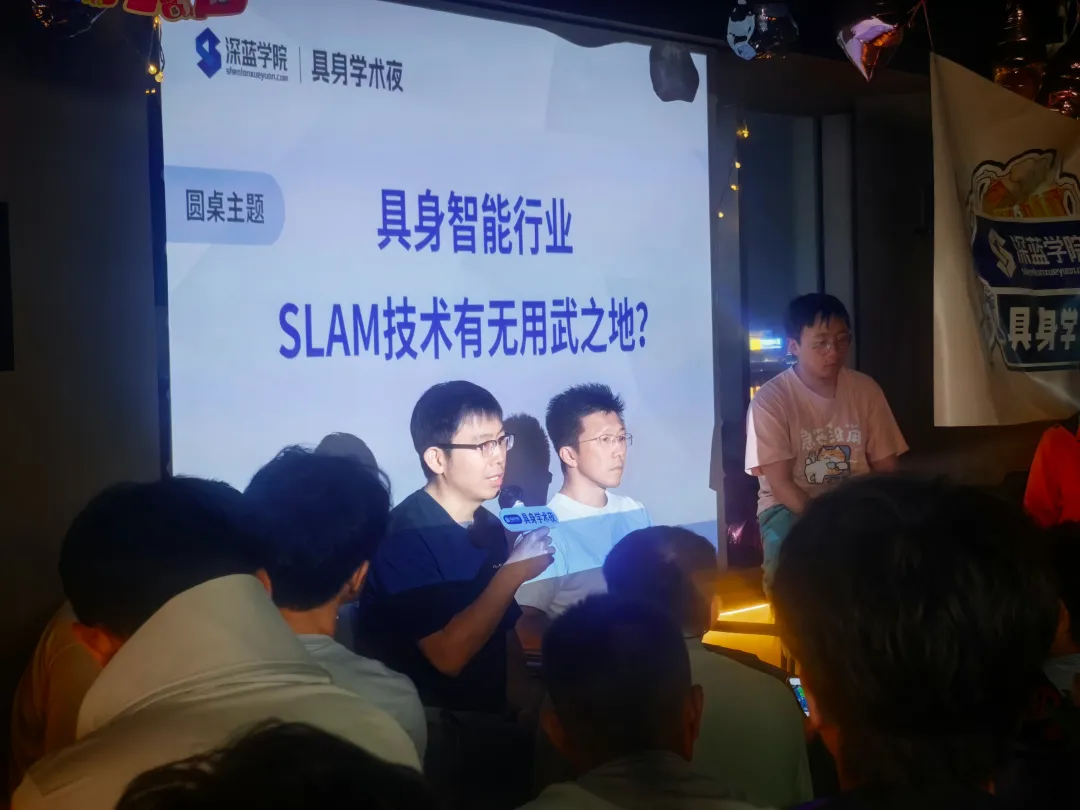
嘉宾高翔,对就业市场的回答有两个层次。
第一层:“SLAM 研究的人变少了,但 SLAM 的岗位在变多。”
机器人公司一两年内都要面对落地,落地就要面对定位。你很难找到一个业务,客户完全不关心到点成功率、回桩成功率。
第二层更冷峻:完全非数据驱动的传统方法会被持续替代。
给再多数据也不会变好的方法,注定让位于会变好的方法。但那些问题(定位、导航、时空一致性)不会消失,只是解法换了容器。
嘉宾史雪松,则把 SLAM 的新工作列成了几个面。
所有会动的机器人当前可能都离不开 SLAM 加传统导航,至少未来一段时间内,落地主流仍会是 SLAM 加规划。
给 VLA 标数据,真机采数据必须靠 SLAM 提供轨迹真值,尤其现在普遍用手持设备采数据,手持设备没有正运动学,正运动学是你的身体,轨迹真值只能靠 VSLAM 建,这就是为什么去年下半年开始市面上突然大量招聘 VSLAM 工程师;
传感器标定、在线标定、在线语义建图,名字不叫 SLAM,用的全是 SLAM 的技术。
他把这一切的地位总结成一个词:时空基准——有了 SLAM,才有统一的坐标系,才有所有数据统一的表示。
而再往上一层看整个人才结构。
我记忆非常深刻的是,当时高翔举了 OpenAI 和 Anthropic 的例子:千人大模型公司里,真正动手训模型的可能不到十个人。机器人行业还多出一环——把模型变成能交付的解决方案,要经历开发、验证、部署的漫长过程。
围绕大模型,上游的数据和下游的部署需要大量工程人才,需求量远比训模型的人多得多。
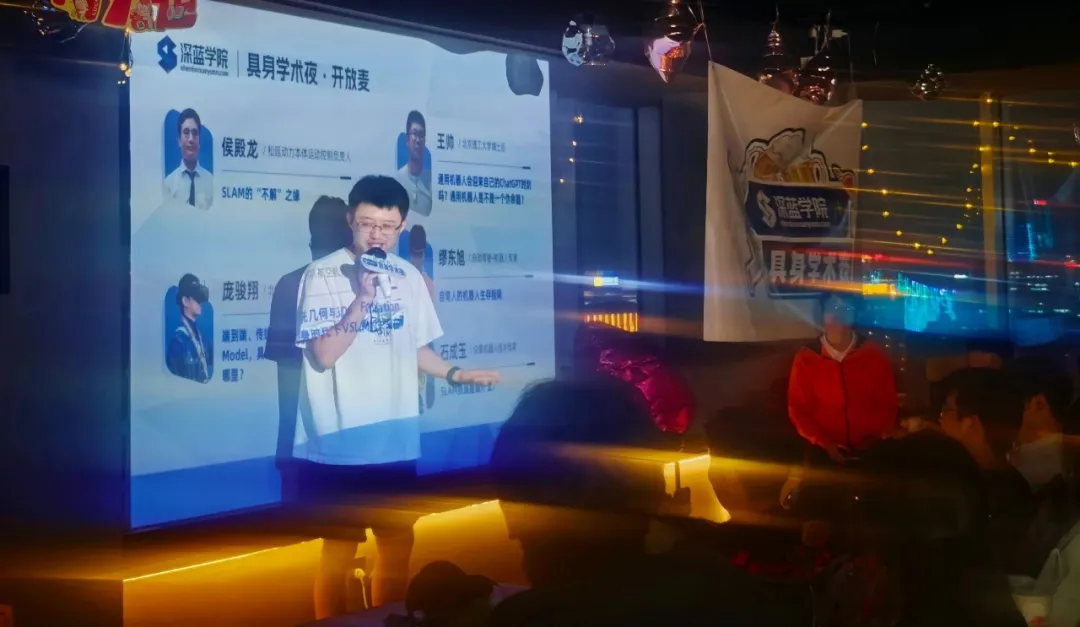
开放麦的讲者们用亲身经历给这个话题增加了一些视角。
主持兼开放麦嘉宾石成玉,复盘了一个黑色幽默的周期:
2017 年前后 SLAM 大热、一将难求;随后供给过剩,大家互相劝"能转雷达的转雷达";等具身智能起来,真值采集、环境重建又全离不开 SLAM。
“结果那帮 SLAM 同学转行之后,转不回来了。”
他们招人时甚至跟 HR 交代:不看之前任何背景,踏实愿意做 SLAM 就来面试。
——石成玉,众擎机器人技术专家
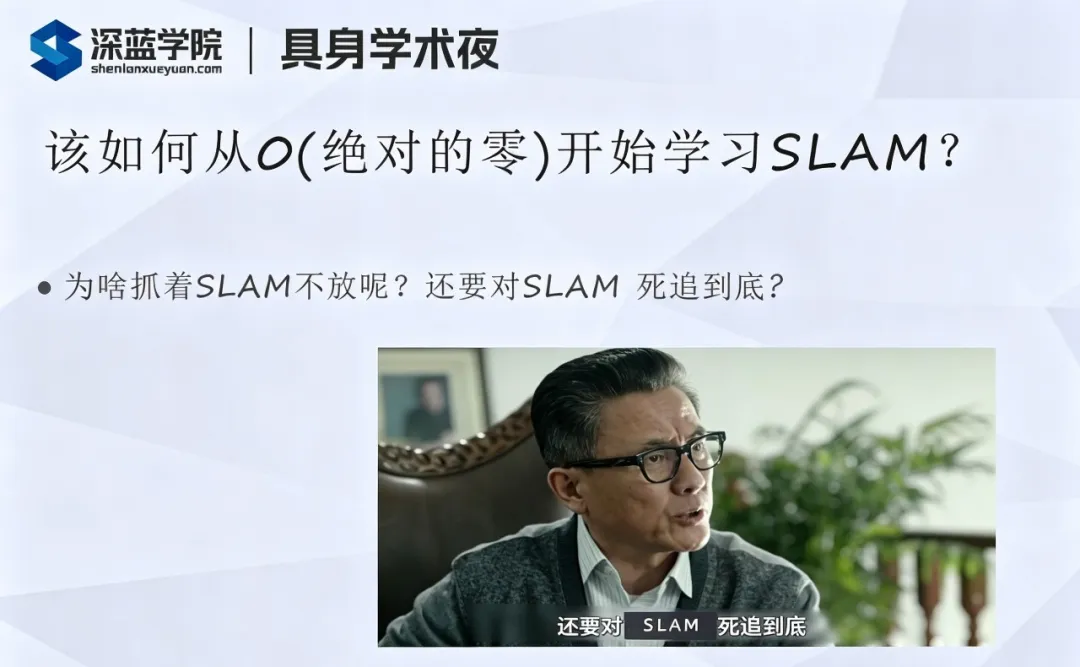
开放麦目前在具身智能公司的候殿龙,则提到,他身边很多人一入门撞上李群李代数就直接放弃了,他自己啃完高博的三本书坚持了下来。
“但我现在觉得,早点放弃也未必是坏事,大家都去做新东西了。”
“当年史博在直播上提出了 Lifelong SLAM 这个好问题和配套数据集比赛,自己顺着做了好几年,结果做着做着发现,史博士已经不做这个、去做具身智能了"。
开放麦从自动驾驶转型过来到具身智能的 MiaoDX,几乎是一份这个行业转型者的写实:
“当年毕业,把高博的书读完、Demo 跑完,就能去自驾公司实习;后来你得把 IO 跑通才能面机器人公司;去年你得会跑 VLA,今年你得跑起 World Model——所以还在学校做 SLAM 的同学,赶紧去跑 VLA 和 World Model 的 Demo。”他的建议朴素得近乎扫兴:多认识人,内推能让你少踩很多坑;把 GitHub 用起来,面试贴上自己的 repo 是硬通货。
他自己有个佐证:多年前把 SLAM 十四讲的代码改写成 Python 的仓库,没怎么维护却收获了大量 star;今年他让 Codex 按原码把两本书全部重写了一遍,“该有的都有,我一行都没写。”
嘉宾高翔还回应了那个很多人关心的问题:
能不能让 AI 自动迭代 SLAM 系统,不再需要算法工程师?
他的回答认为:“这有个说法叫 AI 奇点。目前看 AI 做事务性的事可以——解释代码、搭环境、跑通开源项目的门槛确实低了很多——但从头做一个复杂系统还不行。没有一个 AI 能写出一个正常的操作系统内核,或者做一个能上架的完整游戏。”
而石成玉给从业者的建议,与高翔遥相呼应,也适合作为这一节的收尾:
SLAM 是个工具,里面的非线性优化、李群李代数这些数学基本功,跟做 VLA 都是相通的。基本功学好,掌握任何一个方向都会很快。
SLAM 里的“精华”与“糟粕”
最后,高翔提到,上一代机器学习走过一个弯路叫特征工程:做车牌检测要设计连通点、断点,做指纹识别要去数指纹上有多少个断点、每个弯上有没有断点。
后来发现这些都不需要,你把原始像素喂进去,它自己能学。
推而广之,SLAM 里哪些东西是人为设计的“糟粕”,哪些是应该留下的“精华”?
他的答案很明确:
运动模型、观测模型、相机的投影、渲染器,这些东西有非常 solid 的数学基础,是“精华”;
而提特征点(ORB、FAST、SURF)、高斯假设(为什么状态变量一定是高斯?),这在他看来是“糟粕”。
那么地图、语义呢?
他不认为语义必须是一个 Label、一个 3D 空间的 Bounding Box,因为大语言模型里的语义就是一个 Token,就是一个高维向量,你不应该给它一个符合人定义的、engineering 出来的东西。
所以长期看来,地图可能就是一个“SLAM Token”,某种高维的数学表示,运算之后可以可视化的结果,但不需要长得像一张给人看的图。
SLAM 的数学内核不会死,死掉的只是那些人为设计的中间表示。
而这恰好呼应了史雪松开场说的“机器人不等于视觉理解 + Action 输出”
模型时代,SLAM 不是退场,可能是从“产品里的组件”变成“系统的时空基准 + 数据的真值来源 + 认知地图的下一站”。
而对于行业创业、从业者而言,研究还是离钱更近是始终会围绕在近几年的问题与思考。
这大概就是“线下”的意义:
你在线上可以刷到无数个“VLA /世界模型终局论”,但你只有坐进一个房间里,看着这些正在交付出真实机器人、在赛场上验证过自主性的人,你才会意识到,行业真正稀缺的,从来不是那些被反复转述的热词,而是能在一个场域里愿意把那些热词拆开、看到底下地基、聊真实行业前景的人。
我们后续会继续办这样的沙龙。每场名额有限,下场见。
声明:本文不能代表深蓝学院/嘉宾/参与者的当前技术观点,仅为本次「SLAM」限定主题下的分享&探讨,供更多业内朋友一同交流。
画地图的人没有过时,只是地图画在了新的地方。
我们下一场沙龙见,欢迎大家提议期待的主题、嘉宾、城市。
深蓝学院 · ROBO MIXER 具身学术夜
图源 | 深蓝学院现场实拍
在这个角落,我们说点真的
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
