

为了将算法知识真正转化为解决问题的能力,我们开设了《算法详解》专栏。
这期聊聊强化学习里最常被拿来当第一个基线、也最容易让一行公式产生误会的 PPO。
如果现在要训练一个机器人走路、机械臂抓取或者车辆跟车策略,PPO 往往是最先被拿来尝试的算法之一。它不一定最省样本,性能也不一定永远最好,但实现相对简单,训练通常也比较稳定。
不过我第一次看 PPO 时,一直没想明白一件事:公式里为什么非要放一个 min 和 clip?很多文章会把它概括成“限制策略更新幅度”,这句话没有错,却容易让人误以为 PPO 给新旧策略之间加了一道硬约束。
实际上,PPO 的裁剪不是一道墙。要理解它在裁什么,得先看看策略梯度为什么会把自己推坏。
假设一个机器人走了一批轨迹。某一步,它在状态 s 下选择动作 a,结果比预期更好,那么最直接的想法就是:提高以后在相同状态下选择这个动作的概率。反过来,如果结果更差,就降低它的概率。
问题在于,轨迹是由采样时的旧策略产生的。
用这批数据更新一次以后,策略已经变了;再继续更新 ,新策略与产生数据的旧策略会越来越远。如果不加限制,同一批“过期数据”可能被反复放大,最后让策略突然退化。
完全只训练一步当然可以,但数据利用率太低。TRPO 给新旧策略之间的差异加上约束,明确要求策略不能走得太远,代价是优化过程比较复杂。PPO 想解决的是一个很实际的问题:
能不能继续使用普通的一阶优化器,同时让一批轨迹安全地多训练几轮?
答案是它给目标函数加了那个著名的 min 和 clip。但为什么是"加在目标里",而不是像 TRPO 那样"约束在策略上"?
先别急着背公式,我们把 PPO 拆成三块看:它量什么、它截什么、它为什么不需要一道硬墙。
同一个状态、同一个动作,在新旧策略下各有一个被选中的概率。PPO 用两者的比值衡量策略变化:
其中,π_old 是采样时的旧策略,π_new 是正在训练的新策略。r=1 表示概率没有变化;大于 1 表示新策略更愿意选择这个动作;小于 1 则相反。
只知道概率怎么变还不够,我们还得知道这个动作值不值得鼓励。这由优势估计 Â 表示,可以先把它理解成:这次动作的结果,相比当前状态下的平均表现好多少。
-
Â>0,动作比预期好,希望提高它的概率;
-
Â<0,动作比预期差,希望降低它的概率。
最基础的目标可以写成:
优势为正时,优化器会推动 r 变大;优势为负时,会推动它变小。方向没有问题,问题是它不知道什么时候应该停。
PPO 在上面的目标外面加了一层裁剪:
公式看起来有点绕,分别讨论优势为正和为负就清楚了。
当 Â>0 时,这是一个值得鼓励的动作。随着 r 增大,目标也会增大;但当 r 超过 1+ε 后,裁剪项不再增长,min 会选择封顶后的结果。继续大幅提高这个动作的概率,已经拿不到更多收益。
当 Â<0 时,我们希望 r 变小;但当它低于 1-ε 后,目标同样被截住。继续把这个动作的概率往下压,也不会带来更多收益。
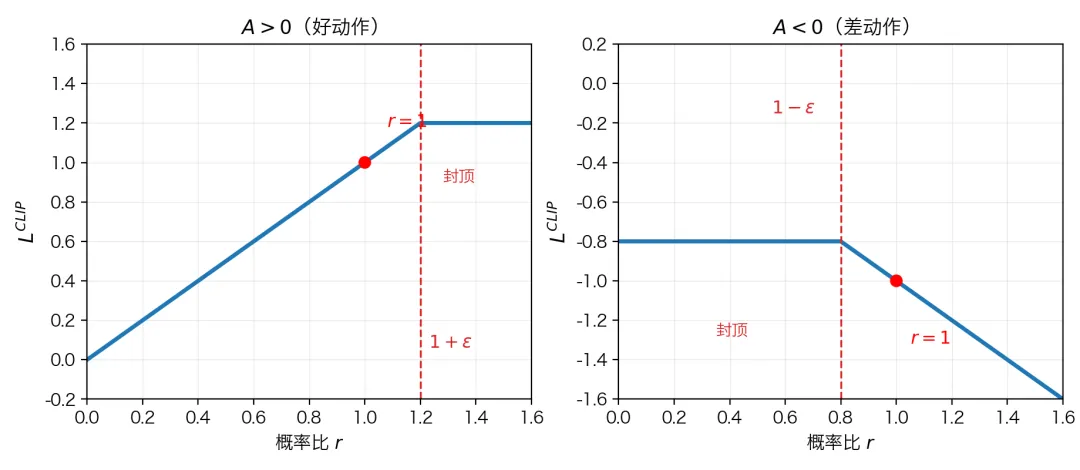
图 1| 优势为正和为负时,PPO 的裁剪方式并不相同。红点是更新起点 r=1。图源:作者自制。©【深蓝 AI】编译
这里有一个经常被讲错的细节。
假设 ε=0.2,不能直接说“概率比最多只能变化 20%”。clip限制的是越界更新在目标函数里能够获得的收益,并没有把所有 r 强制锁在 [0.8,1.2] 内。一次更新完成后,某些样本的概率比仍然可能越界。
所以我更愿意把它理解成:PPO
没有给策略围一道硬墙,而是在策略走得太远时,撤掉了继续往前走的奖励。这种限制没有 TRPO 那么严格,但足够简单,可以配合常见的一阶优化器使用。
环境通常只提供奖励,优势还需要根据奖励和价值估计计算。PPO 通常采用 actor-critic 结构:actor 接收状态并给出动作分布,critic 估计从当前状态出发,未来大概能够获得多少回报。
在连续动作空间里,策略网络常见的做法是输出高斯分布的均值和标准差,再从分布中采样动作。不 过这只是一种常见实现,并不是 PPO 对网络形式的硬性要求。
有了价值估计以后,可以用 GAE(Generalized Advantage Estimation)计算优势。它在估计偏差和方差之间做权衡,参数 λ 参与控制这个权衡。
一次 PPO 迭代大致是:
用当前策略采集轨迹,并保存旧策略的动作概率
↓
根据奖励和价值估计计算回报与优势
↓
拆成多个 minibatch,训练若干个 epoch
↓
丢弃这批轨迹,用更新后的策略重新采样
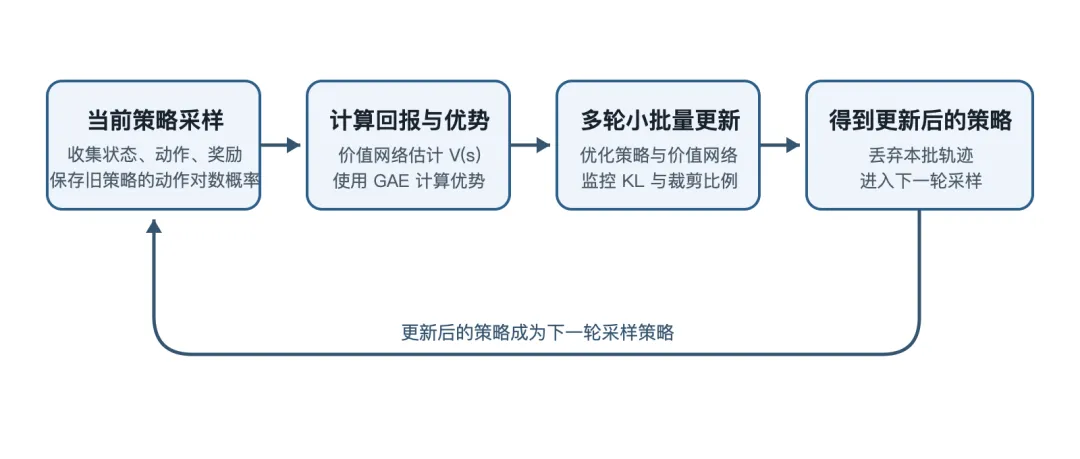
图2 | 当前批次的数据会被复用若干轮,但下一次迭代需要重新采样。图源:作者自制。©【深蓝 AI】编译
因此,“PPO 的数据只能使用一次”并不严谨。一批 on-policy 数据可以在当前更新中训练多个 epoch;策略更新完成后,它通常不会像 SAC、TD3 那样被放进经验回放池,供后续持续复用。这就是 PPO 稳定性和样本效率之间的取舍。
PPO 只是相对稳定,并不意味着拿默认参数一定能收敛。换一个环境、奖励尺度或者动作空间,结果可能完全不同。相比只盯着总奖励,下面几个信号更值得一起看。
approx_kl 近似衡量新旧策略的差异。它突然变大,通常意味着本轮更新走得过远。部分实现会设置target_kl,超过阈值后提前结束本轮训练。OpenAI Spinning Up 默认采用这种做法;Stable-Baselines3 提供了对应参数,但默认并未开启。
clip_fraction 表示当前批次里有多少样本触发了裁剪。它一直接近 0,可能说明更新幅度很小;长期过高,则说明大量样本都在撞裁剪边界。这个指标不能单独决定参数怎么改,但可以帮助判断学习率 和训练 epoch 是否过于激进。
熵反映策略分布的随机程度。熵下降通常意味着策略逐渐确定,但“越低越好”并不成立。下降过快 可能导致探索过早结束;长期居高不下,则可能说明策略始终没有学到明确偏好。不少实现允许增加 熵奖励,不过是否启用、系数多大,仍要看任务。
actor 的更新还依赖 critic。如果价值网络预测得很差,优势估计也会失真。这时即使 clip工作正常,策略仍可能朝错误方向更新。
排查时可以顺着计算链路往回看:奖励是否合理,终止状态有没有处理对,回报和 GAE 是否算对,旧策略的 log_prob 是否真的固定,再看策略损失、价值损失和 KL 的变化。只看一条 episode reward 曲线,很难判断问题究竟在哪里。
还有一点需要注意:论文写的是最大化 clipped objective,而大部分代码实现的是最小化它的相反数。因此,代码中出现 max不一定写错了,可能只是目标函数换成了 loss 的形式。判断实现是否正确,必须把正负号一起展开。
PPO 的优势不在于某个指标永远最强,而是取舍比较实用:它能处理离散和连续动作,使用普通的一阶优化器就能训练,同时通过裁剪降低策略被一次更新推坏的风险。主流强化学习库也提供了成熟实 现,因此它很适合用来建立第一个基线。
它的边界同样明确。PPO 需要不断用当前策略采集新数据。如果仿真环境便宜、能够并行运行很多环境,这个代价往往可以接受;如果数据来自真车或真实机器人,采样成本就会迅速变成主要问题,此 时更应该比较 SAC、TD3、离线强化学习或模仿学习等方案。
换到自动驾驶控制里,也不应该因为神经网络推理快,就直接得出“PPO 比 MPC 更合适”。MPC 能够显式处理模型和约束,工程行为也更容易分析;强化学习策略把大量计算放到了训练阶段,但安全约束、泛化和仿真到现实的差距并不会因此消失。选哪个,仍然取决于问题本身。
OpenAI 公开的 InstructGPT 训练流程曾使用 PPO,根据奖励模型给出的分数继续优化语言模型。这里的 actor 不再输出机器人的关节力矩,而是在已有文本后选择下一个 token;奖励也不再来自机器人是否站稳,而是来自根据人类偏好训练的奖励模型。
问题的形式变了,核心仍然是根据奖励调整策略,同时避免新策略在一次更新中离原策略太远。不过 ,这只能说明公开的 InstructGPT 方案使用过 PPO,不能据此推断当前 ChatGPT 的完整训练流程。
我觉得理解 PPO,重点不是背住 ε=0.2、γ=0.99 这些常见参数,而是想清楚它在防什么:一批轨迹被重复训练时,新策略会逐渐偏离产生数据的旧策略,而 clip通过截断越界更新的收益,让这种偏离不至于轻易失控。
它不是硬约束,也不能保证训练一定稳定。真正排查一次异常训练时,仍然要沿着奖励、价值估计、 优势、概率比、KL 和裁剪比例逐层检查。公式只有一行,问题往往藏在整条数据链路里。
审核|阿蓝
参考资料
1 Schulman et al. Proximal Policy Optimization Algorithms. arXiv:1707.06347.https://arxiv.org/abs/1707.06347
2 Schulman et al. High-Dimensional Continuous Control Using Generalized Advantage Estimation. arXiv:1506.02438. https://arxiv.org/abs/1506.02438
3 Schulman et al. Trust Region Policy Optimization. arXiv:1502.05477.https://arxiv.org/abs/1502.05477
4 Ouyang et al. Training language models to follow instructions with human feedback. arXiv:2203.02155. https://arxiv.org/abs/2203.02155
5 OpenAI Spinning Up. Proximal Policy Optimization.https://spinningup.openai.com/en/latest/algorithms/ppo.html
6 Stable-Baselines3. PPO Documentation.https://stable-baselines3.readthedocs.io/en/master/modules/ppo.html
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
