

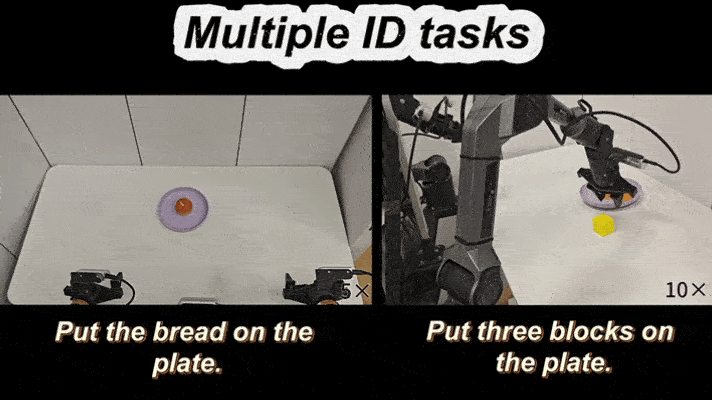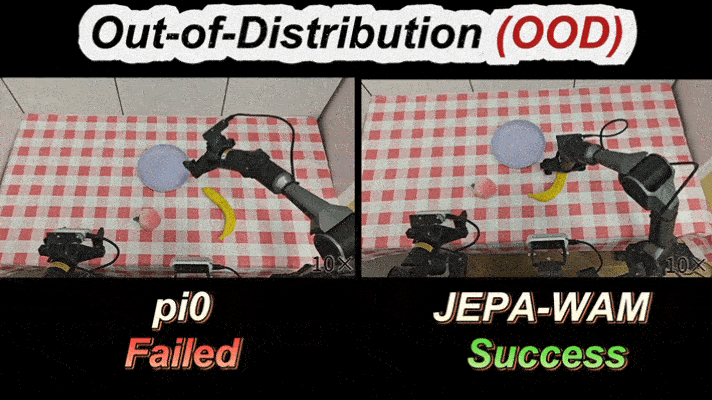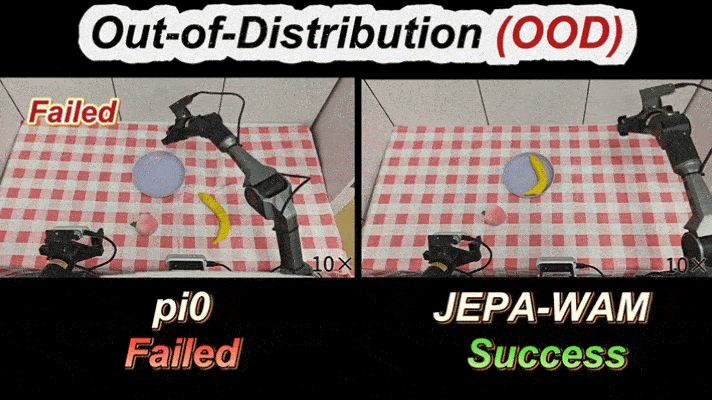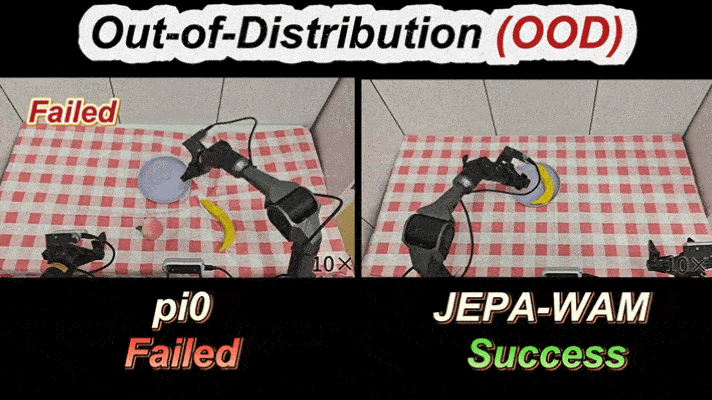
基于 V-JEPA 共享预测器构建潜态 WAM,联合时序表征提升机械臂域外泛化能力
——从零搭建策略
上图来自中国人民大学、清华AIR、XYZ Embodied AI等团队的联合团队推出JEPA-WAM。
基于预训练V-JEPA构建共享预测器潜态世界模型,无需生成像素画面,依靠时空联合表征实现跨场景强泛化,仿真与真机双平台验证,无大规模机器人预训练条件下LIBERO-Plus数据集79.2%成功率刷新同赛道最优水平,适配现有成熟VLA模型无损提升鲁棒性。
现有技术路线
当前机器人VLA世界模型分为两条主流路线:
-
视频生成式WAM
通过逐帧预测未来图像建模环境变化,理论上能完整还原场景动态,但推理阶段需要循环生成画面,算力消耗巨大,机械臂嵌入式设备很难实时运行;
同时像素重建会冗余记录光照、噪声等无关信息,模型容易过拟合训练环境,域外场景泛化能力弱。
-
传统独立分支潜态WAM
放弃像素生成,直接在特征空间预测未来,但设计上存在两种缺陷:
一是仅编码单帧未来特征,丢失当前-未来画面之间的局部空间变化关系,物体微小位移、遮挡等关键动作线索丢失;
二是时序预测网络和动作编码器完全分离,时序损失无法反向优化生成动作的主干网络,世界建模的增益很难传递给动作预测分支。
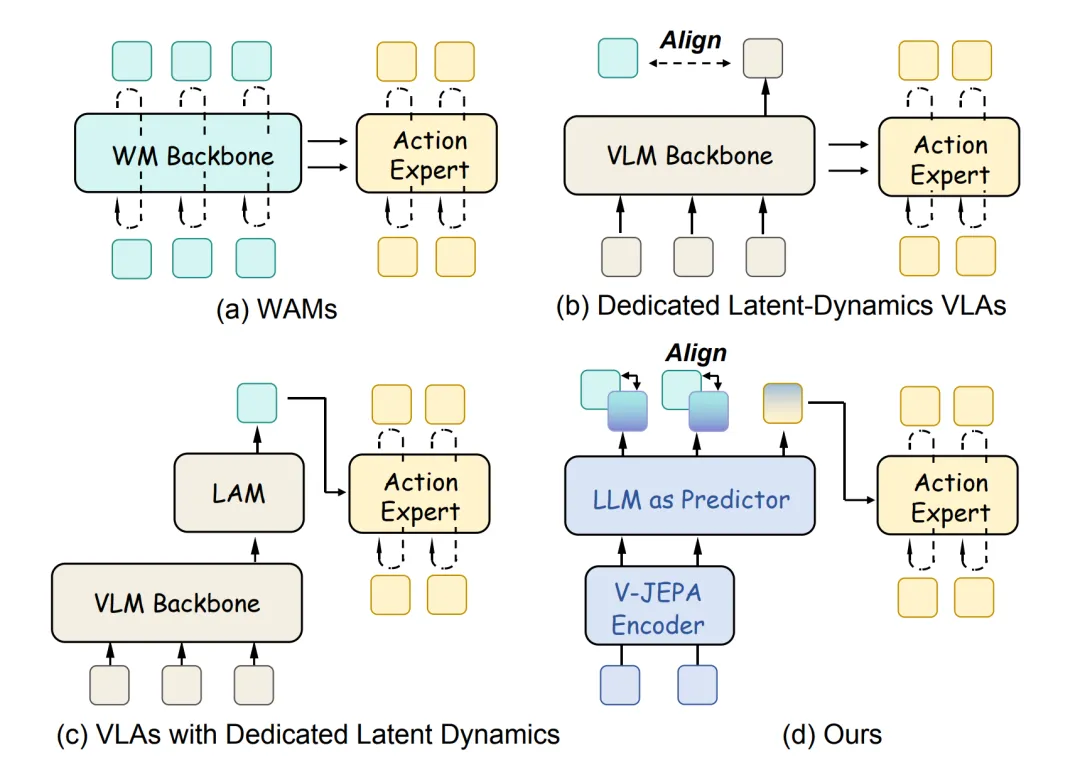
▲四类潜态VLA范式对比图©【深蓝具身智能】编译
对比目前四类潜态VLA范式,能直观看出JEPA-WAM差异化设计逻辑:
-
传统WAM:世界建模与动作专家分属两套独立主干,信息割裂;
-
专用潜动力学VLA:单独搭建动力学模块作为动作输入,监督信号间接;
-
带独立LAM分支VLA:视觉主干输出特征后额外新增动力学子网络,无法共享权重;
-
JEPA-WAM(本文):单Qwen共享预测器同时输出时序表征与动作特征,时序损失直接优化主干,不存在冗余分支。
当前的JEPA衍生机器人方案如VLA-JEPA、JEPA-VLA,仅将JEPA特征作为输入,没有实现时序预测与动作生成耦合,而JEPA-WAM首次把联合时空预测目标嵌入V-JEPA表征空间,一套预测器完成两大任务,从结构上解决特征复用不足的问题。
JEPA-WAM核心架构与三大创新设计
整套框架核心由冻结V-JEPA编码器、Qwen2.5-0.5B共享预测器、DiT动作专家三部分构成,训练阶段开启时序预测分支,部署时直接删除预测头,仅保留动作推理链路,不增加上线延迟。
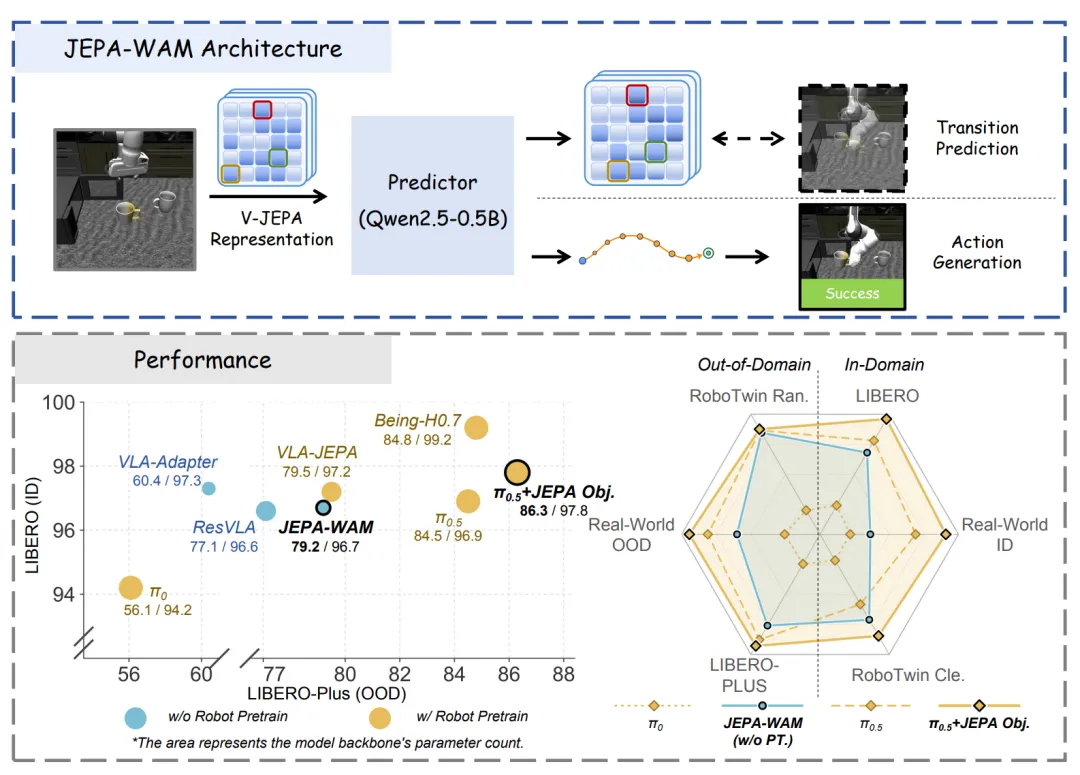
▲JEPA-WAM 整体架构与综合性能总览©【深蓝具身智能】编译
时空联合当前-未来预测目标(核心表征创新)
绝大多数潜世界模型只单独编码未来单帧特征,JEPA‑WAM 创新构造联合时序表征 :
将当前帧 与步后的未来帧 沿时间维度堆叠,送入冻结 V‑JEPA 统一编码,输出同尺寸、保留分块空间信息的联合特征。
-
:同相机时序画面拼接,V‑JEPA 原生双帧 tubelet 编码保证输出空间网格和单帧完全一致; -
:冻结目标编码器,避免时序损失破坏预训练视觉能力; -
多视图拼接:全局、腕部相机特征有序拼接,完整保留机械臂多视角空间对应关系。
该表征不单独编码未来,而是直接存储“当前→未来”全部局部变化:
物体移动区域、遮挡变化、手爪交互信息全部保存在分块token里。
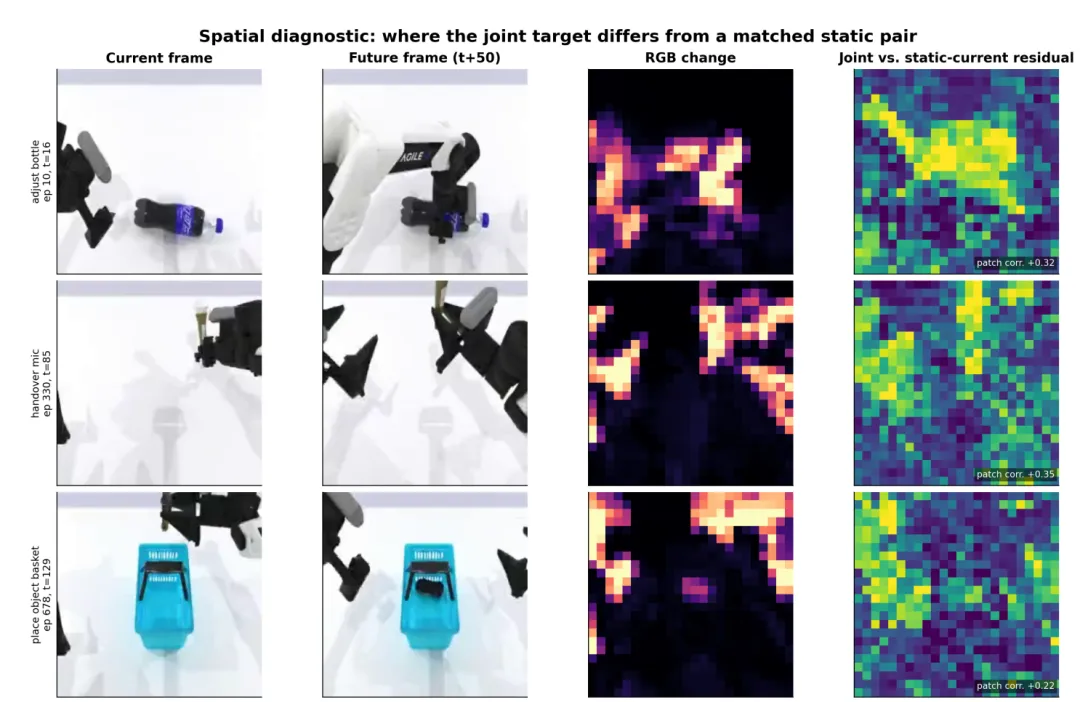
▲联合时序表征的空间变化可视化诊断图©【深蓝具身智能】编译
可视化结果显示,联合表征的特征变化区域和画面RGB动态区域高度匹配,模型能精准捕捉手爪、物体交互的局部变化,不会丢失细粒度动作线索。
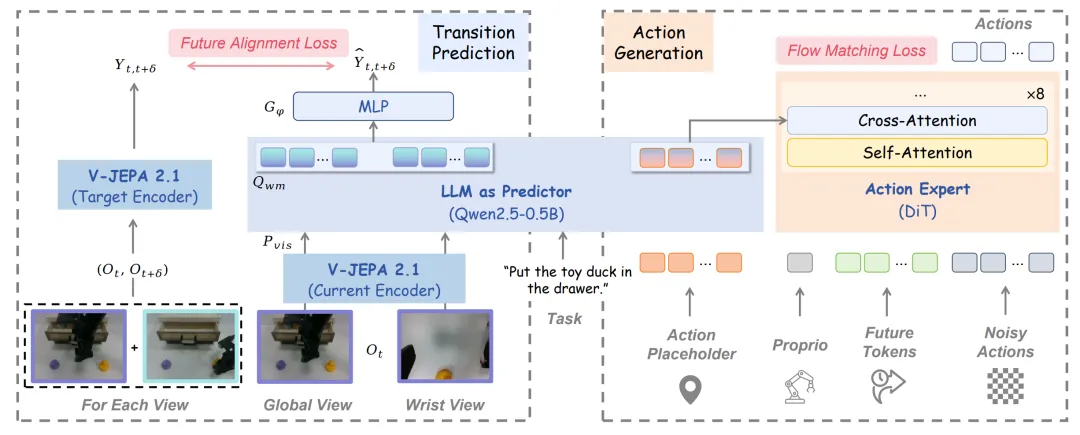
▲JEPA-WAM详细推理流程图©【深蓝具身智能】编译
单共享预测器耦合时序建模与动作生成
这是JEPA-WAM最关键的结构创新,彻底解决时序监督无法作用于动作主干的行业痛点:
共享预测器选用轻量化Qwen2.5-0.5B,输入V-JEPA视觉特征、语言指令、专用动作占位符token,单次前向传播输出两组特征:
-
:用于时序预测的视觉位置隐态,保留原始 patch 空间排布,送入 MLP 预测头对齐联合时序目标;
-
:动作专用聚合表征,单独送入 DiT 动作专家生成连续机械臂动作。
训练总损失为动作匹配损失+时序对齐损失加权和:
采用逐块余弦距离损失,强制预测器学习画面时空变化;基于流匹配预测连续机械臂动作序列。
两套损失同步更新同一个 Qwen 主干,时序学到的空间动态知识直接赋能动作预测,不存在两套网络的信息壁垒。
无侵入式适配现有预训练VLA模型
JEPA-WAM并非独立全新模型,可作为辅助监督模块无损接入π0.5等成熟大规模机器人预训练VLA,无需改动原有视觉、动作推理通路。
实现方式仅新增一组可学习Future Token:
在VLM输入序列末尾追加64个专用时序token,输出隐态重塑为粗特征图,上采样对齐V-JEPA联合目标维度,额外增加时序对齐损失辅助训练。
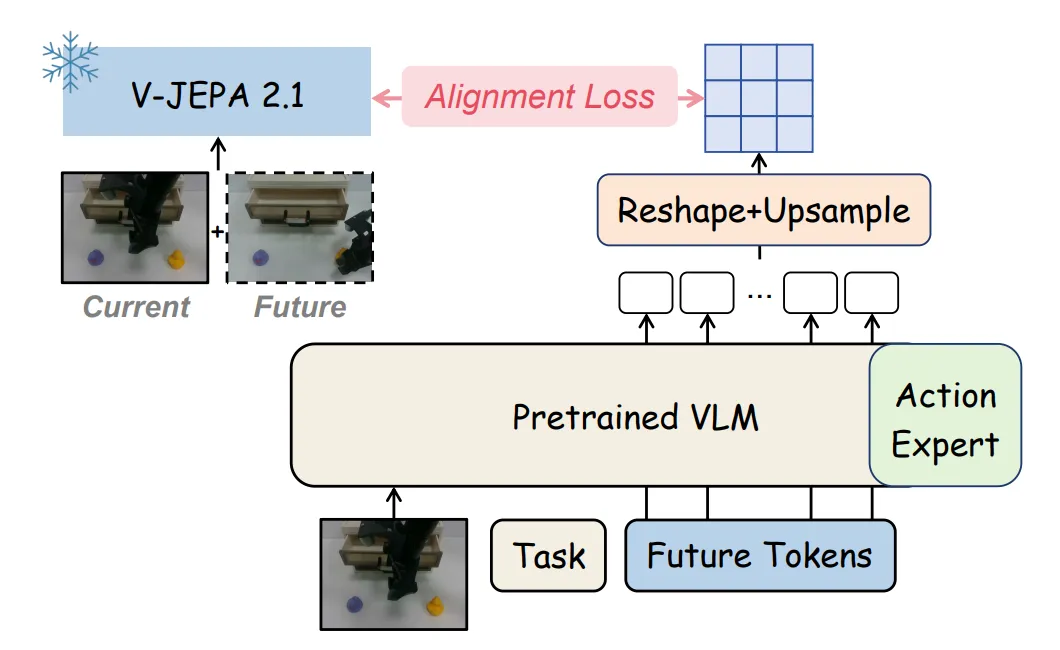
▲预训练VLA接入时序监督结构图©【深蓝具身智能】编译
在LIBERO-Plus数据集,原生π0.5基线84.5%,接入JEPA时序监督后提升至86.3%,成为全赛道最优结果,证明该时序范式对大尺度预训练VLA同样具备显著增益,适配存量工业VLA算法。
仿真与真机双维度实验:指标的收益与局限
实验覆盖LIBERO仿真单臂、RoboTwin 2.0双臂仿真、真实AgileX双机械臂三大平台,区分“无机器人大规模预训练”“带预训练”两组基线横向对比,指标不单纯追求纸面刷榜,区分域内ID、域外OOD两种场景解读实际落地价值。
LIBERO系列仿真基准
-
LIBERO(域内ID场景)
原生JEPA-WAM无预训练平均成功率96.7%,和ResVLA、Fast-WAM等主流方案持平;
接入π0.5预训练模型后提升至97.8%,域内性能无衰减,证明时序监督不会破坏基础任务能力。
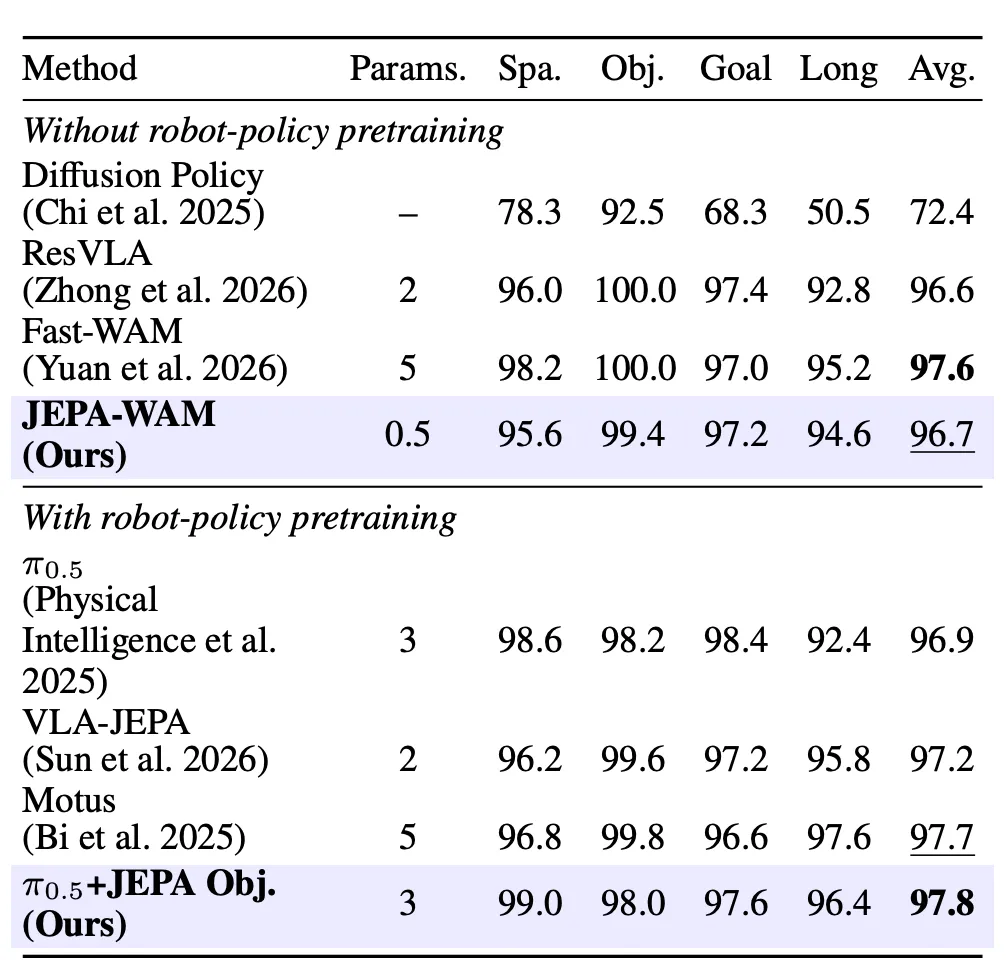
▲LIBERO 数据集任务成功率(%),按是否使用大规模机器人预训练分组©【深蓝具身智能】编译
-
LIBERO-Plus(域外OOD核心评测场景)
该数据集通过更换光照、物体摆放、背景、相机视角制造分布偏移,专门测试泛化能力,是行业核心鲁棒性标尺。
无大规模机器人预训练组别:JEPA-WAM 79.2%,超越RoVLA、ResVLA等全部基线,同赛道第一;
带预训练组别:π0.5+JEPA Obj达到86.3%,整体榜单最优;
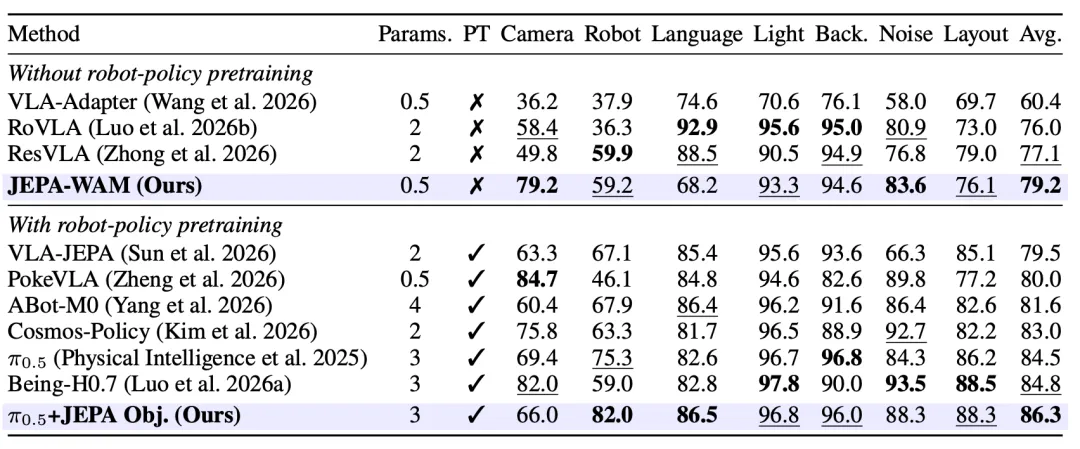
▲LIBERO-Plus 域外泛化数据集任务成功率(%)©【深蓝具身智能】编译
分维度数据显示,相机偏移、物体布局变化、光照扰动下JEPA-WAM提升幅度最大,证明联合时序表征对视觉扰动鲁棒性提升效果最突出。
RoboTwin 2.0双臂仿真
区分Clean标准场景、Random随机扰动场景(物体乱序、视角切换):
原生JEPA-WAM:Clean 79.9%,Random 36.9%,远超无预训练基线;
π0.5叠加时序监督:Clean场景75.4%→84.6%大幅提升,Random扰动场景性能基本持平;
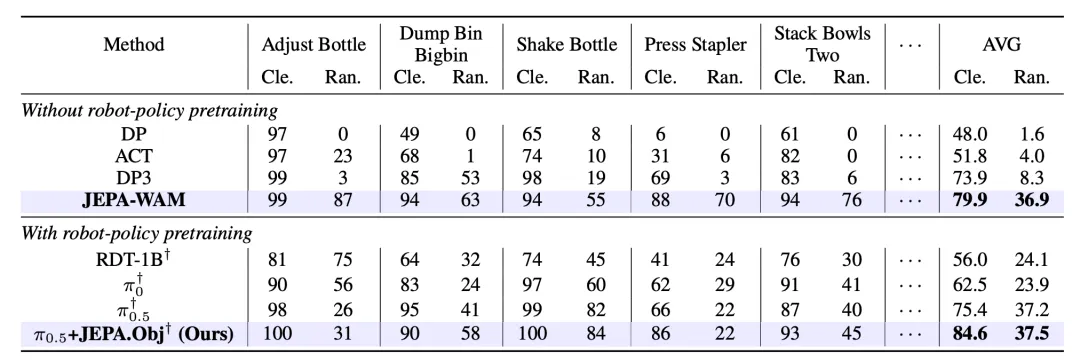
▲RoboTwin 2.0 仿真标准 / 随机扰动场景单任务成功率(%)©【深蓝具身智能】编译
推理效率补充:单帧推理85ms(11.76Hz),对比ABot-M0(125ms)速度提升32%,嵌入式机械臂控制器可实时运行,不存在视频生成模型的算力瓶颈。
真实双机械臂真机测试
搭建6自由度双臂平台,设计5类操作任务(摆盘、堆叠、抽屉抓取),分别测试标准ID环境、更换背景物体OOD环境:
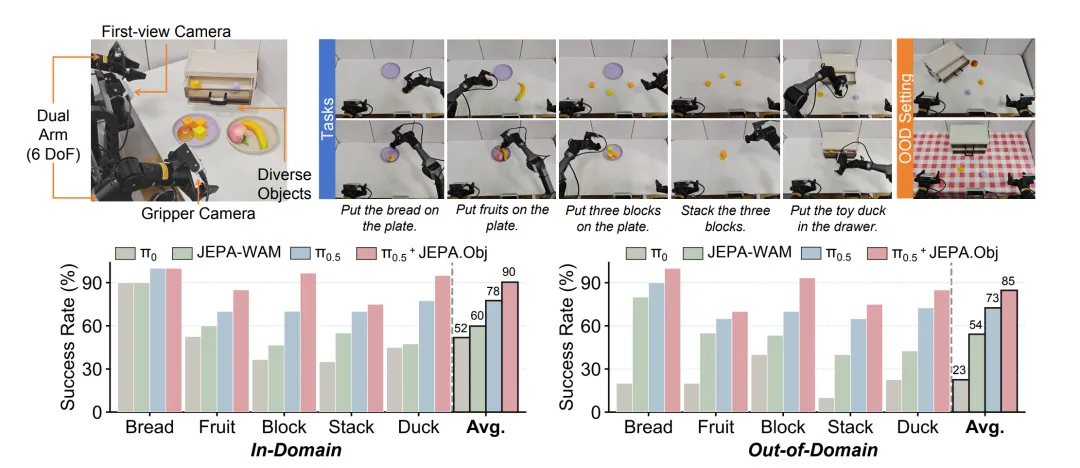
▲真实双臂机器人五项操作任务的域内 / 域外实验结果©【深蓝具身智能】编译
轻量JEPA-WAM原生模型:ID均值59.8%,OOD均值54.2%,对比原生π0(ID51.8%/OOD22.5%)域外泛化提升一倍以上;
π0.5叠加JEPA时序监督:ID 77.5%→90.3%,OOD72.5%→84.7%,真机复杂物理交互下泛化增益稳定复现。
真机实验核心价值:仿真数据集的泛化优势不是纸面数字,真实相机畸变、机械传动误差、物体摩擦力扰动场景下依旧成立,具备工业落地可行性。
消融实验(优化要点)
表征层面:联合时序目标>仅未来帧>特征差值,分块空间对齐不可压缩;
主干层面:时序监督作用于预测器最后一层效果最优,中层辅助监督收益大幅下滑;
任务隔离:专用动作占位符能避免时序特征干扰动作生成,是平衡多任务的关键;
视觉基座:V-JEPA自带时序表征能力,替换DINO+SigLIP基线,域外平均直接提升3.8%。
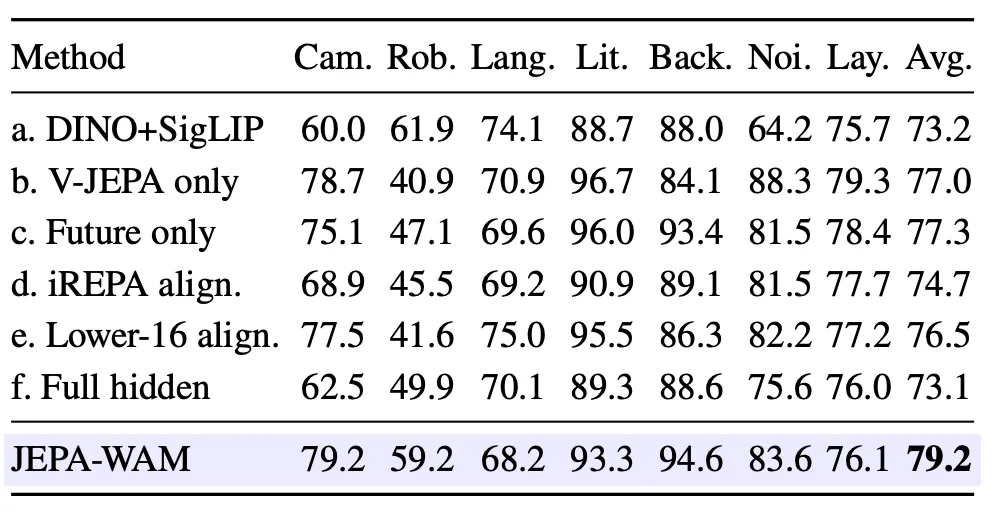
▲LIBERO-Plus 数据集分扰动维度消融实验结果©【深蓝具身智能】编译
总结
JEPA-WAM跳出“生成像素”、“独立动力学分支”两大传统世界模型设计思维,依托V-JEPA稠密分块表征搭建共享预测器,用联合当前-未来时序目标精准捕捉场景局部时空变化,让时序动态监督直接赋能动作生成主干。
无论是从零训练轻量化VLA,还是优化现有大规模预训练机器人策略,都能稳定提升光照、视角、物体布局扰动下域外任务成功率,同时保持低推理开销,适配工业机械臂嵌入式硬件。
该工作证明JEPA类自监督视频表征是解决VLA泛化瓶颈的优质底座,后续若融合多模态传感、自适应时序偏移参数、语言条件时序目标,有机会进一步拓展至动态工件、长步骤工业装配等高难度机器人任务。
编辑|小小怪博士
审编|具身君
Ref
论文标题:JEPA-WAM: Learning Vision-Language-Action Policies with Joint-Embedding World Modeling
扫码添加阿蓝,选择想要加入的交流群即可
(按照提交顺序邀请,请尽早选择)
👇
